 NexAIX-官方博客
随着智谱 AI 相继推出并开源 GLM-5.2 与 GLM-5.3,GLM 系列在开源大模型阵营中的定位已经从早期的“高性价比通用对话”全面转向长程智能体(Long-Horizon Agent)与复杂软件工程(Agentic Coding)。特别是 744B 级 MoE 架构配合 IndexShare 稀疏注意力机制落地后,真正工程可用的 1M(100 万)Token 上下文与 128K 最大输出,让直接把完整代码仓库塞进上下文、连续执行数十步工具调用成为常态。
但在把 GLM 模型接入生产环境、Cline 或自研 Agent 管线时,不少开发团队会遇到一系列工程层面的摩擦:订阅制 Coding Plan 存在绑定指定客户端、5 小时动态积分上限、高峰时段倍率上浮以及历史模型自动重定向等限制;而如果打算拿开源权重自己搭 vLLM 或 SGLang,FP8 精度下动辄需要 8 张 H100/H200(超过 640GB 显存)的硬件门槛又让中小团队望而却步。
本文梳理当前 GLM 核心模型的技术代际与适用场景,拆解生产环境调用 GLM API 常见的四类工程隐患,并给出基于 NexAIX 自有算力集群的标准 OpenAI 兼容接入与核验方案。
一、GLM-5.2、GLM-5.3 与 Flash/Turbo 怎么选?
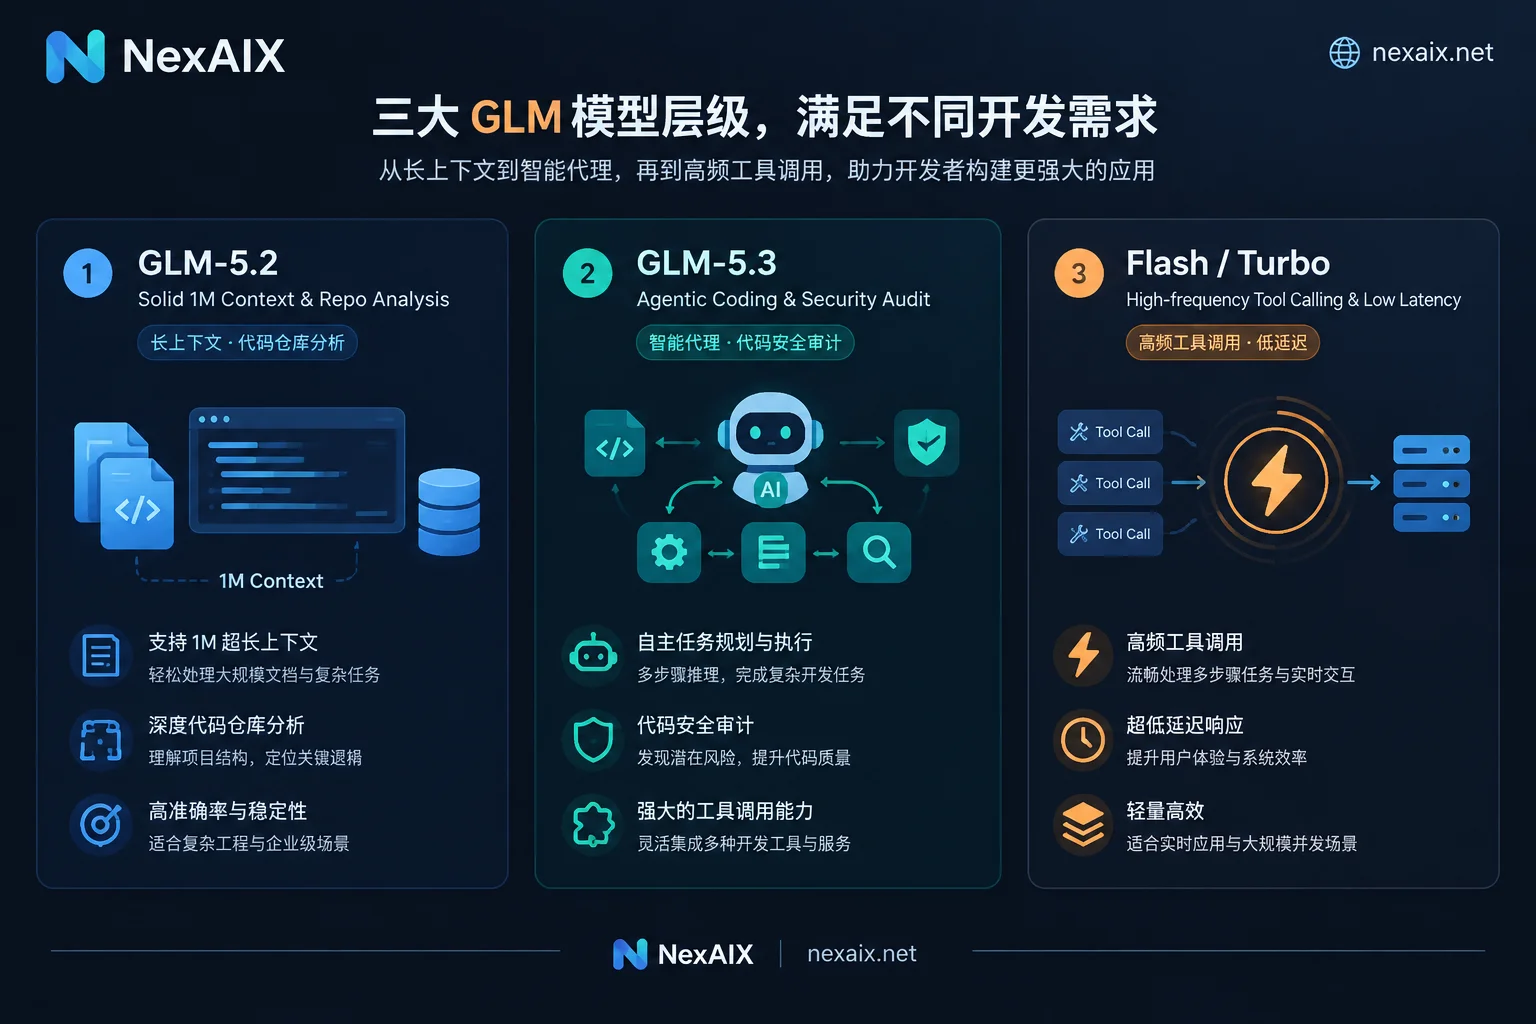
在 GLM-5 家族经过多轮迭代后,不同子型号在后训练(Post-training)权重、上下文深度与工具调用倾向上拉开了明显差距。接入 API 前,建议先按业务负载定好基座:
| 模型系列 | 核心架构与规格参考 | 能力侧重 | 典型生产场景 |
|---|---|---|---|
| GLM-5.2 | 744B 级 MoE(激活约 40B),1M 上下文,MIT 开源协议 | 首个打通 Solid 1M 无损上下文与长程软件工程环境的版本,跨文件重构与长文档召回稳定 | 整库代码分析、自动化研究报告生成、固定版本基线的生产级 Agent |
| GLM-5.3 | 与 5.2 同源底座,强化异步智能体 RL 后训练,1M 上下文 | 复杂 Coding 与终端执行(Terminal Bench)显著跃升,具备突出的白盒代码审计与漏洞发现能力 | 多步自主调试(SWE 任务)、DevSecOps 自动化代码安全审查、复杂系统架构生成 |
| Flash / Turbo 分支 | 轻量化激活或针对特定长链路调度优化 | 牺牲部分极限深度推理,换取更高吞吐与更低的首字延迟(TTFT),强化高频 MCP/工具调用 | GUI Agent 实时交互、高频多智能体协同分工、结构化数据清洗与高并发客服 |
版本核对提示:不同时期上线的具体模型版本、推理精度(如 BF16、FP8 等)、上下文上限与计费单价,请直接访问 NexAIX 模型广场 查看实时标注。以glm-5.2为例,你可以通过 GLM-5.2 模型详情页 查阅其完整的发布方、许可协议、输入模态与参数规格(注意:浏览单个模型网页时,URL slug 需将模型 ID 中的点替换为横线,即/models/glm-5-2/;而在代码中发起 API 请求时,model字段仍填写glm-5.2)。若团队需要调用的特定开源权重版本暂未在列表中,可附上型号与预计用量发邮件至 [email protected],我们评估算力后会回复排期。
二、工程落地 GLM API 常见的四类痛点
在调研或初步试用阶段,很多开发者会先接触到各类“包月编程套餐”或低价聚合渠道。然而一旦将业务推向自动化流水线或团队多人共用,以下四个问题往往会集中爆发:
1. 订阅套餐的工具锁定与高峰期软限流
部分面向个人开发者的订阅套餐(如 Coding Plan)仅限在白名单客户端内生效,无法作为通用后端 API 供自研服务调用;同时存在每 5 小时与每周的双重积分池上限,且在工作日 14:00–18:00 高峰时段会触发不同的抵扣系数或次级调度排队。对于需要可预期延迟的线上业务,这种非标准限流极难在代码层做容错处理。
2. 历史模型被“静默升级”导致 Prompt 漂移
在一些套餐规则下,当客户端请求 glm-5.2 或 glm-5.1 时,网关会在后台强制将其自动重定向至更新的模型(或将旧版 Turbo 强行切至新版 Flash)。虽然新模型在公开榜单上跑分更高,但在严苛的生产环境里,底层模型的静默替换很容易打破既有的正则表达式解析、JSON 结构化提取或特定 System Prompt 的遵从度。
3. 低价转售渠道的“量化缩水”与上下文截断
由于 744B 级 MoE 模型全量加载需要庞大的显存开销,市面上部分依靠拼车或二次转售的中转服务,为了在有限显卡上塞入更多并发,会私下使用过度量化版本,或者在服务端将 1M 的上下文窗口硬性截断到 64K/128K。反映在业务端,就是 Agent 执行到第 10 轮以后突然“失忆”、丢掉开头的架构约束,或是频繁出现意外截断(可参考本站此前关于大模型 API 输出被截断的排查方法)。
4. 多模型混合编排时的 SDK 与账单碎片化
在真实的 Agent 架构中,很少有团队只用单一模型:通常是用 GLM-5.2 / 5.3 处理重度代码仓库理解与长文本分析,同时搭配 Claude Opus 5 或 GPT-5.6 做交叉验证,或者用 Qwen、DeepSeek 处理分类路由。如果每接一家模型都要维护一套独立的 SDK、认证逻辑和充值发票,基础架构的维护成本会呈指数级上升。
三、NexAIX 的供给方案:自有算力部署与透明边界
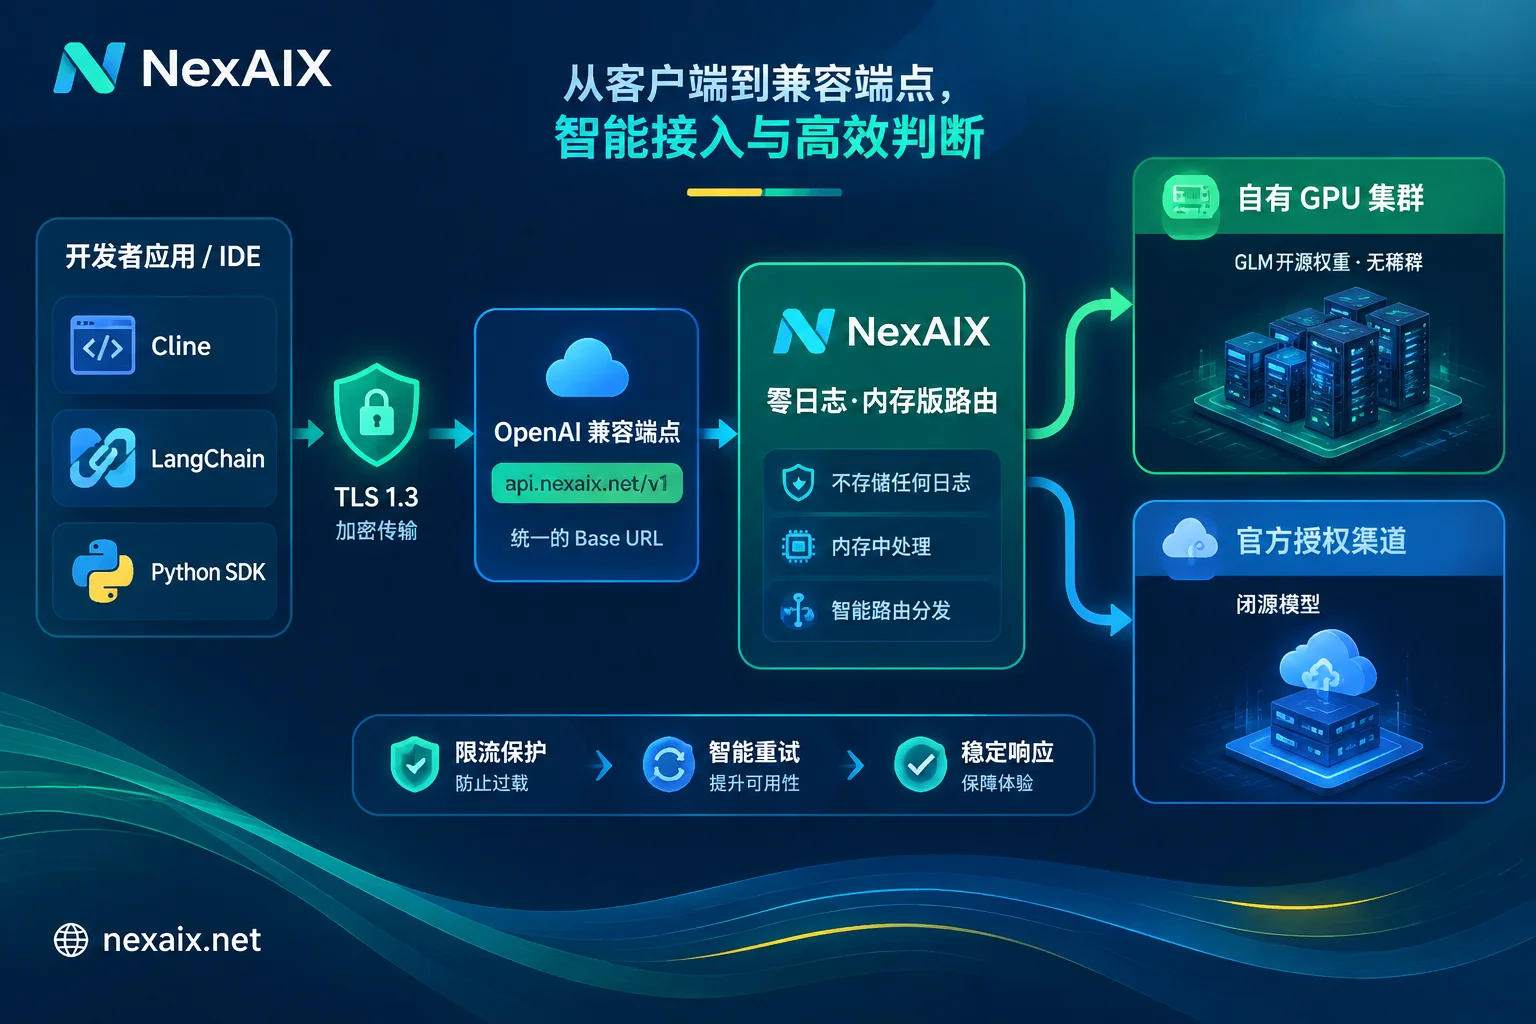
针对上述工程痛点,NexAIX 的设计逻辑非常直接:只做清晰的算力供给与标准化的 OpenAI 兼容网关(关于开源与闭源供给模式的详细对比,可延伸阅读开源权重模型 API 和官方授权渠道有什么区别)。
- 自有算力部署(针对 GLM 等开源权重模型)
NexAIX 上的 GLM 系列属于官方发布的开源权重模型,直接部署在我们自建与自租机房的自有 GPU 集群上,由自有工程团队独立运维,绝不转售不可控的第三方拼车额度。每个模型详情页均明确标注「自有算力部署」标签,并公开上下文窗口、最大输出与实际推理精度(如 BF16、FP8 等,关于精度对质量的影响详见模型推理精度 BF16 和 FP8 有什么区别)。 - 不降配、不静默换模型
我们承诺 不降配(No Dilution):API 响应体(Response Body)里的model字段严格对应实际执行推理的模型。请求glm-5.2就由glm-5.2执行,绝不在后台静默替换为 Flash 小模型,不暗降推理精度,不截断标称的上下文与最大输出,也不注入任何隐藏的系统提示词。temperature、top_p、max_tokens等参数全程原样透传。 - 明确的限流语义(429 + Retry-After)
开源模型的容量直接来自自有 GPU 集群。每把 API Key 设有明确的 RPM、TPM 与并发上限(需更高配额可联系申请,按实际集群容量答复)。当遇到突发洪峰触发满载时,网关会立即返回标准的 HTTP429 Too Many Requests状态码并附带Retry-After响应头,绝不无限期挂起连接,也绝不擅自把请求路由给更便宜的模型顶替,把退避、排队或切模型的控制权完全交还给你的业务代码。 - 零对话日志(Zero Logs)与合规可审计
代码仓库与业务数据往往涉及核心知识产权。在 NexAIX 侧,所有的prompt与completion仅在内存中流转转发,请求结束即刻释放,不落盘、不用于模型训练、也不转交任何第三方;系统仅保留请求 ID、模型名、Token 计数、时间戳与状态码用于计费与排障,客户端到推理节点全程采用 TLS 1.3 加密(详见 不记录对话说明)。此外,我们具备完整企业主体,支持签合同、开具发票以及签署服务协议与数据处理协议(DPA)。
四、三步接入:用一套 OpenAI 兼容接口打通 GLM 与全球旗舰模型
NexAIX 严格遵循 OpenAI Chat Completions 规范实现,支持流式输出(Streaming)、函数/工具调用(Function Calling)与多轮对话。如果你的项目已经在用 OpenAI SDK,只需修改 base_url 和 api_key 即可完成平滑迁移(更多语言配置可参考换大模型 API 要改哪些代码)。
先前往 NexAIX 控制台 使用邮箱注册(无需企业资质,注册即送测试额度),创建一把 API Key,即可按以下方式调用:
1. Python 接入示例(长上下文 + 工具调用 + 流式输出)
以下示例展示如何通过标准 openai 库调用 glm-5.2,传入工具定义并处理流式返回:
import os
from openai import OpenAI

# 仅需将 base_url 指向 NexAIX 端点,换上你的 API Key
client = OpenAI(
    api_key=os.environ.get("NEXAIX_API_KEY"),
    base_url="https://api.nexaix.net/v1"
)

tools = [
    {
        "type": "function",
        "function": {
            "name": "run_unit_test",
            "description": "在沙箱环境中执行指定模块的单元测试并返回结果",
            "parameters": {
                "type": "object",
                "properties": {
                    "module_path": {"type": "string", "description": "测试文件路径,如 tests/test_auth.py"},
                    "timeout_sec": {"type": "integer", "description": "超时秒数"}
                },
                "required": ["module_path"]
            }
        }
    }
]

response = client.chat.completions.create(
    model="glm-5.2",  # 切换模型只需修改此字段,如改为 claude-opus-5 或 gpt-5.6
    messages=[
        {"role": "system", "content": "你是一名资深后端架构师,负责审查代码库并调用测试工具验证修复方案。"},
        {"role": "user", "content": "请分析 auth 模块的 token 刷新并发竞争问题,先触发一次单元测试确认复现。"}
    ],
    tools=tools,
    tool_choice="auto",
    temperature=0.2,
    max_tokens=4096,
    stream=True
)

for chunk in response:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
    if delta.tool_calls:
        for tc in delta.tool_calls:
            print(f"\n[触发工具调用] {tc.function.name}: {tc.function.arguments}", end="")
2. 在 AI 编程助手与 Agent 框架中直接配置
得益于统一的 OpenAI 兼容接入标准,任何支持自定义 base_url 的开发工具与编排框架都能直接接入 NexAIX 上的 GLM 模型。你可以为不同项目或不同工具分别签发独立的 API Key(每把 Key 具备独立配额、独立权限与按模型分项的独立账单,一旦泄露可单独吊销):
- Cline / IDE 插件:在设置中选择
OpenAI Compatible,Base URL 填入https://api.nexaix.net/v1,Model ID 填入glm-5.2(详细图文步骤见 Cline 怎么配置自定义模型 API)。 - Dify / 知识库与工作流:在模型供应商中添加 OpenAI-API-compatible 渠道(配置细节见 Dify 添加 OpenAI 兼容模型指南)。
- 桌面客户端与网关:同样无缝支持 Cherry Studio、NextChat、OneAPI 以及 LangChain、LlamaIndex、Vercel AI SDK。
更重要的是,一把 Key 即可访问全部已开通模型。当你在处理某段极其棘手的跨语言底层重构、希望把结果交给闭源模型做二次对比时,不需要更换 SDK 或新建渠道,只需将请求里的 model 字段从 glm-5.2 改为官方授权渠道的 claude-opus-5 或 gpt-5.6,接口格式完全一致。
五、调用生产环境 GLM API 的四项工程自查与调优建议
将 GLM API 正式并入生产流量前,建议技术负责人结合以下四点完成上线核验:
- 关注超长输入的首 Token 延迟(TTFT)与成本曲线
虽然 GLM-5.2/5.3 支持百万级上下文,但在物理规律上,超长输入在 Prefill(预填充)阶段的计算量极大,首 Token 延迟和单次调用费用会随输入长度显著上升。建议在开启stream=True流式输出以改善前端体感的同时,合理裁剪无用的历史日志,避免每次多轮对话都全量重传几百 KB 的冗余输出。 用四种方法自查“原版未降配”
如果你从其他渠道迁移过来,怀疑此前遭遇过模型替换或上下文缩水,可以参照我们的 不降配自查指南(或阅读博客专题怎么确认 API 返回的是不是原版模型)做四项复核:- 核对返回体中的
model字段是否与请求完全一致; - 固定 prompt、
temperature=0与随机种子进行跨时段复测; - 构造接近模型标称上限的输入长度进行压测,确认不会提前报长度超限或丢失中间信息;
- 让模型复述收到的全部消息,排查网关是否偷加了隐藏提示词。
- 核对返回体中的
- 实现基于
Retry-After的客户端退避策略
由于 NexAIX 坚持单一端点透明供给,不做掩盖真实模型身份的“自动故障转移”,建议在客户端(如使用 Pythontenacity或 OpenAI SDK 内置重试机制)捕获429状态码,并读取响应头中的Retry-After秒数执行指数退避,或由业务层显式决定是否切往备选模型(错误码处理详见AI API 错误码怎么看)。 - 记录
request_id以便精准排障
NexAIX 的每次 API 调用都会在响应中返回唯一的请求 ID。因为我们不记录你的对话内容(Prompt/Completion 不落盘),在遇到超时、状态码异常需要联系技术支持时,请务必在日志中保留该请求 ID 并附带提供,以便工程团队根据元数据进行链路定位。
结语
GLM-5.2 与 GLM-5.3 的开源,让开发团队在构建百万上下文仓库级 Agent 时拥有了真正能扛住复杂工程任务的开源基座。省去自建多机多卡 GPU 集群的繁琐运维,避开消费级套餐的隐式规则限制,你可以直接前往 NexAIX 控制台 领取免费测试额度,或浏览 模型列表 查看 GLM 系列与各大旗舰模型的实时规格,用一行 base_url 的改动把原汁原味的自有算力接入你的生产管线。若有企业级高并发配额、独立资源池或私有化部署需求,欢迎随时通过 [email protected] 与我们取得联系。



评论(0)