 NexAIX-官方博客
BF16 和 FP8 都是浮点格式,区别在于每个数用多少位来存。
- BF16:每个数 16 位(2 字节),数值范围和 FP32 一样,很少出现溢出。多数开源大模型发布的权重就是 BF16。
- FP8:每个数 8 位(1 字节)。权重和 KV 缓存的显存占用大约减半。在有原生 FP8 计算单元的 GPU 上,吞吐可以明显提高,代价是数值精度会降低一些。
对质量的影响取决于任务。日常对话和知识问答中,FP8 与 BF16 的评测差距通常在 0.5%~1% 以内。在代码生成、长链条数学推导,以及激活值离群点较多的深层模型上,FP8 更容易出现小幅退化或结果不稳定。
落到选型上,可以分两种情况:
- 自己部署模型:先看硬件是否支持 FP8,再看任务能不能接受这点精度损失。
- 调用 API:精度由服务方决定,你没法自己选。你需要确认服务方用什么精度运行模型,并有办法自己验证。
先看位数:差别在指数和尾数怎么分
浮点数由三部分组成:符号位、指数位和尾数位。指数位决定能表示多大或多小的数,尾数位决定同一量级内能分得多细。
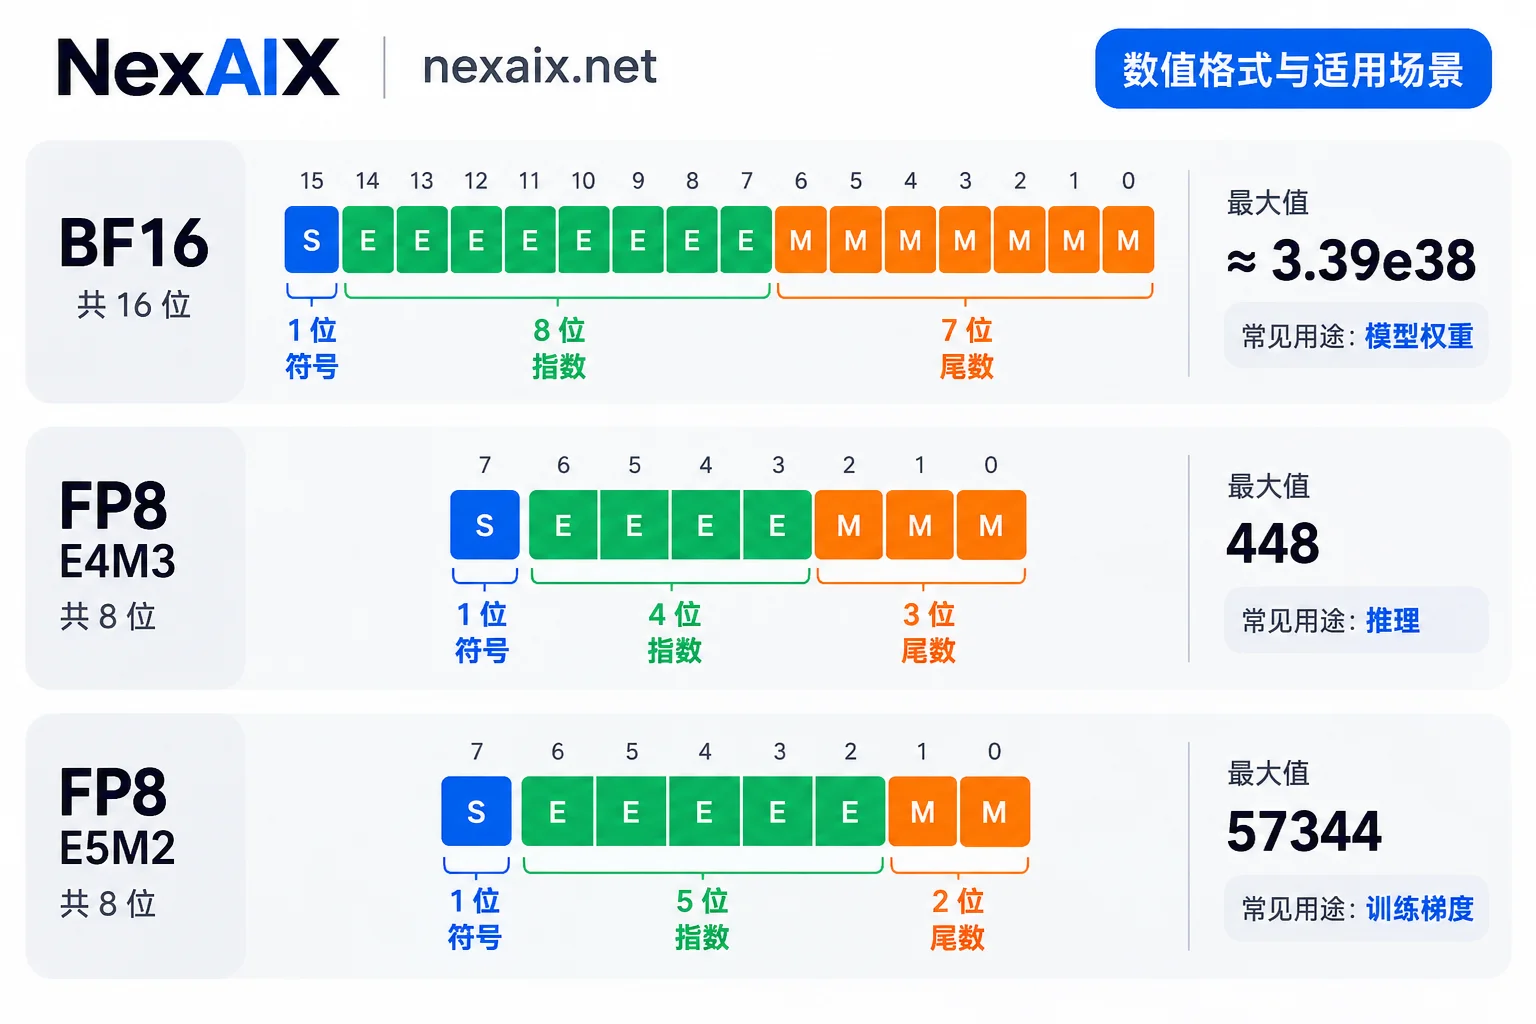
- BF16:1 位符号、8 位指数、7 位尾数。指数位和 FP32 一样多,所以最大值约 ±3.39×10³⁸,推理时基本不用担心溢出。
- FP8 E4M3:1 位符号、4 位指数、3 位尾数。最大绝对值约 448,范围较窄,但尾数多一位,数值更细。推理时的权重和激活值大多用这种格式。
- FP8 E5M2:1 位符号、5 位指数、2 位尾数。最大绝对值约 57344,范围更大,但更粗糙,多用于训练中的梯度计算。
所以,看到「FP8 推理」时,通常指的是 E4M3。它的数值范围很窄,量化时要配合缩放,把原本的数值映射到这个范围里。
同样是 8 位,为什么 FP8 比 INT8 这类整数量化更受欢迎?整数格式的刻度是均匀分布的。浮点格式在零附近刻度更密,越往外越稀。Transformer 的权重和激活值大多集中在零附近,呈钟形分布,正好落在 FP8 最精细的区域。这也是 FP8 在通用任务上损失较小的主要原因。
显存:权重和 KV 缓存都约减半
BF16 每个参数 2 字节,FP8 每个参数 1 字节。以 70B 参数的模型为例,仅权重就从约 140 GB 降到约 70 GB。激活值、框架开销等其他部分不一定同比例下降,但权重通常是显存的大头。
长上下文场景下,KV 缓存往往比权重更占显存。KV 缓存也用 FP8 存储时,这部分占用同样接近减半。带来的直接好处有两点:
- 同样的显存能放下更大的 batch 或更多并发请求。
- 解码阶段更快。 大模型逐个生成 token 时,瓶颈通常在显存带宽,而不是算力。每次要搬运的数据少一半,生成速度会受益。
速度:只有硬件原生支持才有收益
FP8 能不能加速,取决于 GPU 有没有原生 FP8 Tensor Core。
- NVIDIA Hopper(H100、H200)、Ada Lovelace(如 L40S)、Blackwell 架构:FP8 Tensor Core 的理论算力是 BF16 的 2 倍。实际部署中,端到端吞吐通常能达到 BF16 的 1.3~1.8 倍。
- Ampere 架构(如 A100)及更早的卡:没有原生 FP8 计算单元,拿不到这部分加速。数据在 FP8 和计算格式之间来回转换,还可能带来额外开销。
如果你手上是 A100,FP8 的主要价值是省显存、让模型能放得下,不要指望它提速。
质量:哪些任务看不出差别,哪些要小心
公开评测的大致结论如下。
差距很小的任务:MMLU-Pro 这类知识型评测、阅读理解、日常对话。FP8 与 BF16 的差距通常在 0.5%~1% 以内,实际使用中很难感知。
更容易出问题的任务:
- 代码生成:以 HumanEval 这类需要执行单元测试的评测为代表。
- 严密的符号数学推导。
- 激活值离群点较多的深层模型。
这些任务对误差更敏感,有两个原因:
- 推理链条越长,每一步的微小数值误差越可能累积。
- 代码只要错一个符号,测试就不通过,没有「差不多对」的空间。
所以在这类任务上,FP8 偶尔会出现退化或波动,BF16 仍是更稳妥的质量基准。
怎么选:按场景对号入座
自建推理服务,GPU 是 Hopper、Ada 或 Blackwell,任务以对话、客服、摘要、检索问答为主
FP8 很适合,能拿到更高的吞吐和更低的单 token 成本。上线前,用自己的业务样本和 BF16 版本对比一轮。
自建推理服务,GPU 是 A100 等不支持原生 FP8 的卡
只有在显存放不下 BF16 版本时才值得考虑 FP8,速度收益基本没有。
代码生成、数学推导,或要和论文、官方评测结果对齐
优先用模型官方发布时的精度运行。多数开源模型的原始精度是 BF16。也有部分模型官方发布的权重本身就是 FP8,这时 FP8 就是它的原始精度,不算降级。判断是否降精度,要和官方发布的版本比,而不是一律以 BF16 为准。
通过 API 调用模型
你看不到、也改不了服务端的运行精度。这时要问的是:服务方有没有在官方精度之下运行这个模型。
通过 API 调用时,怎么确认精度没被降
第一步:分清模型是怎么供给的。
- 闭源模型:OpenAI、Anthropic 等厂商没有公开云端实际的运行精度,外部无从核对。能确认的只有一点:调用是否走厂商的官方渠道。
- 开源权重模型:由各服务方自行部署。同一个模型,不同服务方可能用 BF16,也可能用 FP8 甚至更低精度的量化版本,价格和速度的差异往往就来自这里。
第二步:用自己的任务做对照测试。 不需要复杂的评测框架,准备一小套固定用例就能看出系统性差距:
- 从真实业务里挑 20~50 个用例。重点放代码题(附单元测试)和多步推理题,这些最容易暴露精度问题。
- 把 temperature 设为 0,固定其他参数。即便如此,服务端仍可能存在少量非确定性,所以不要只跑一次。
- 准备一个参照组,可以是模型官方 API,也可以是你自己按官方精度部署的版本。用同一套用例,分别跑参照组和待测端点。
- 比较整体指标,比如单元测试通过率、最终答案正确率,不要盯着个别回答的措辞差异。如果代码和数学题出现稳定的成绩落差,而闲聊类题目看不出区别,就符合低精度运行的典型表现,值得向服务方确认。
这个方法只能提供信号,不能直接证明服务端用了什么精度。但对于判断「这个端点能不能用于我的任务」,它已经够用。
如果端点兼容 OpenAI 接口,切换参照组和待测组只需改 base_url 和模型名,具体写法见《OpenAI 兼容接口怎么用:改一行 base_url,把现有应用接到新端点》。
以 NexAIX 为例:
- 开源权重模型:部署在自有算力集群上,承诺不降精度、不换小模型、不砍上下文。
- 闭源模型:走厂商官方授权渠道。
- 每个模型属于哪种供给方式:都在模型清单和对应模型页上标明。
- 四条承诺的验证方法:写在服务承诺页,可以对照上面的测试步骤自己核对。
注册后的测试额度足够跑完一轮小规模对照。



评论(0)