 NexAIX-官方博客
判断 API 背后是不是原版模型,不能靠问它“你是哪个模型”。比较可靠的做法是交叉验证,按成本从低到高分四类:
- 看响应字段和 usage 统计,确认协议特征是否完整;
- 用固定的探针题测知识截止和能力上限;
- 用长上下文压测,确认没有被偷偷截断;
- 看首字延迟和解码速度,作为辅助信号。
要先说清楚一个边界:OpenAI、Anthropic、DeepSeek 等厂商目前都没有对返回结果做数字签名,所以下面这些手段都属于工程上可复核的检查,做不到密码学级别的证明。单项异常只算线索,几项同时异常,结论才站得住。
为什么问“你是谁”不算数
请求到达模型之前,会先经过服务商的中间层。中间层完全可以注入一段 System Prompt,让模型自称任何名字。另一方面,不少开源模型的训练语料里混有其他厂商模型的对话,即使没人动手脚,它的自我认知也可能是错的。所以模型自报的身份既可能被伪造,也可能本来就不准,不能当作证据。
第一步:看响应字段和 usage
这一步成本最低,写个脚本就能跑。最有用的做法是拿一个可信基准对照:如果你有官方直连的 Key,就用完全相同的请求(同样的 messages、temperature=0)分别打官方和待测端点,再比较结果。
重点看这几项:
- prompt_tokens 是否对得上。 同一段输入,同一模型的分词结果是确定的。待测端点的输入 token 数如果明显多于官方,很可能被注入了隐藏的 System Prompt;如果差得离谱、对不上任何已知分词器,后端可能根本是另一个模型家族。OpenAI 系模型可以用 tiktoken 在本地算一遍做参照,其他厂商要用各自的分词方式,不能混用。
- 厂商特有字段在不在。 比如 Anthropic 的接口在启用 Prompt Cache 后,usage 里会返回
cache_creation_input_tokens和cache_read_input_tokens;推理模型(例如 DeepSeek-R1)应当有独立的reasoning_content思维链输出和推理 token 统计;OpenAI 体系的部分响应带system_fingerprint。走逆向通道或换了模型的服务,往往缺这些字段,或者字段存在但数值明显不合理。 - 注意协议转换。 如果你是通过 OpenAI 兼容格式调用一个 Anthropic 模型,服务商会做格式映射,原生字段可能被改名或省略。缺字段是否可疑,要看该端点文档有没有说明它透传哪些协议特性。
下面这段 Python 用流式请求一次性拿到 usage、指纹和时延,后面第四步也会用到:
import time
from openai import OpenAI

client = OpenAI(base_url="https://待测端点/v1", api_key="YOUR_KEY")

def probe(model, messages):
    t0 = time.time()
    first = None
    usage, fp = None, None
    stream = client.chat.completions.create(
        model=model, messages=messages, temperature=0,
        stream=True, stream_options={"include_usage": True},
    )
    for ev in stream:
        if ev.choices and ev.choices[0].delta.content and first is None:
            first = time.time()
        if ev.usage:
            usage = ev.usage
        fp = getattr(ev, "system_fingerprint", None) or fp
    t1 = time.time()
    ttft = (first - t0) if first else None
    speed = usage.completion_tokens / (t1 - first) if (usage and first) else None
    return {"usage": usage, "fingerprint": fp, "ttft": ttft, "tokens_per_s": speed}
个别端点不支持 stream_options,这种情况下 usage 会是空的,可以改成非流式请求单独取 usage。
第二步:用固定探针测能力
System Prompt 能改模型的语气和自称,改不了它真正知道什么、能做到什么。探针分两类:
- 知识截止探针:挑一些恰好落在不同模型知识截止期交界处的事件提问。原版模型应该知道的事,被换成旧版或小模型后往往答不上来,或者开始编造。
- 能力上限探针:高难度数学题(如 AIME 级别)、复杂代码重构、带逻辑陷阱的推理题。大模型和小模型在这类题上的通过率差距很大。
做法上要注意三点:题目集固定下来反复用;每题多跑几轮看通过率,单次答对答错说明不了什么;最好和官方直连的结果放在一起比。
第三步:长上下文压测
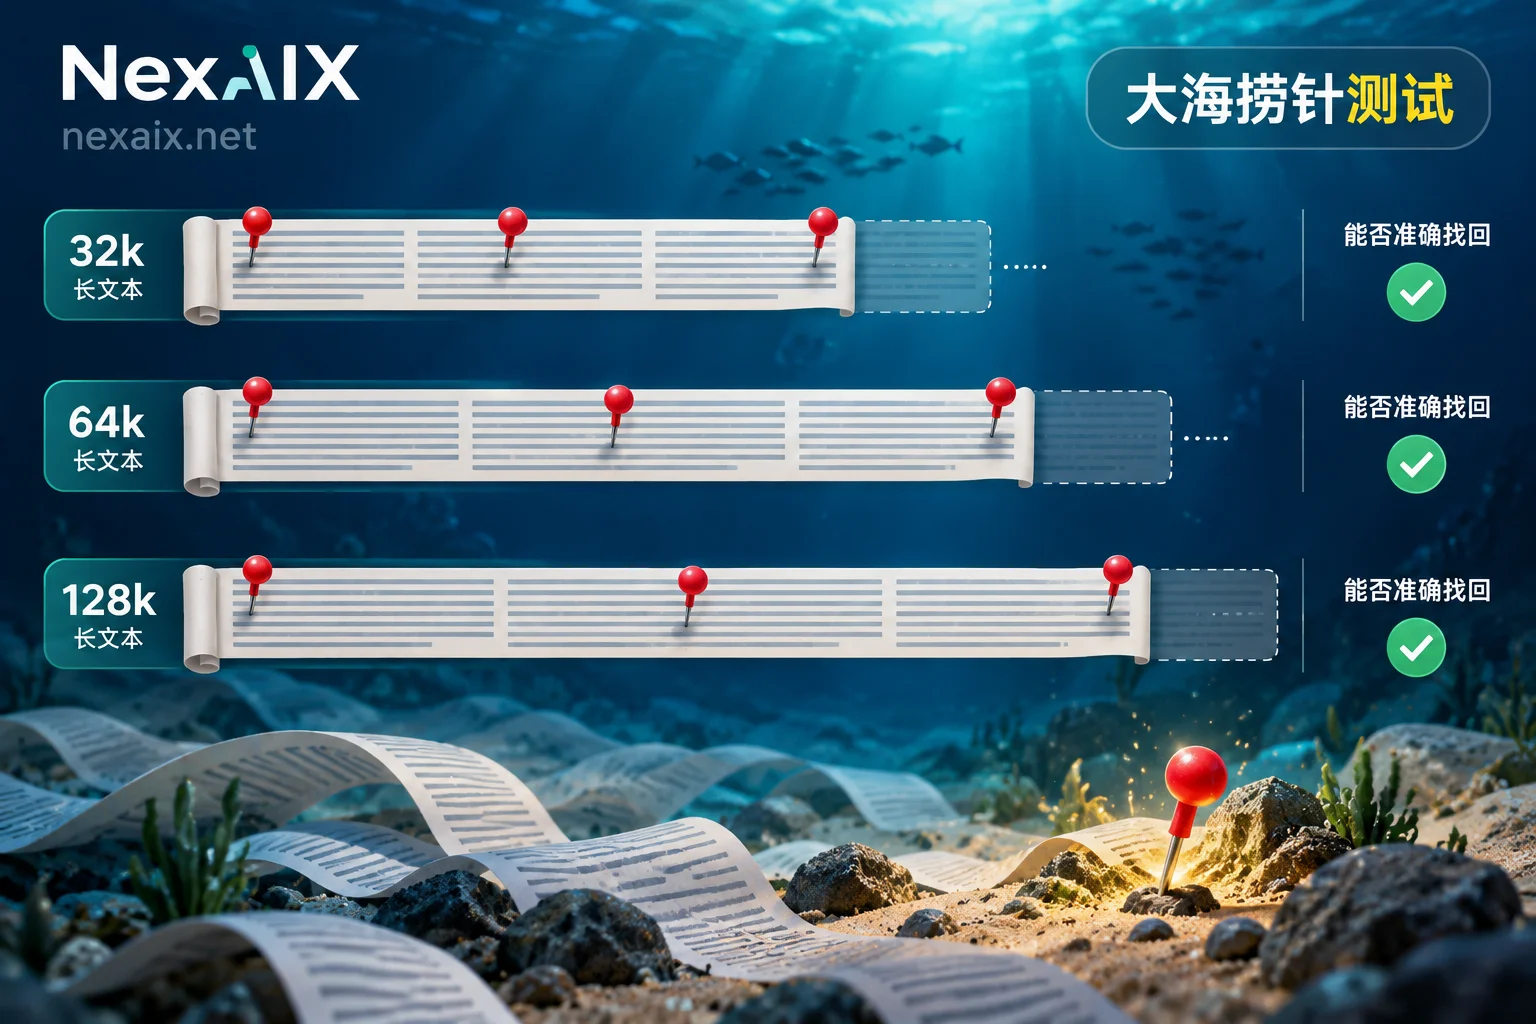
把标称 128k 或 200k 的上下文在网关层截到 8k、16k,是降低显存开销的常见做法,日常短对话里很难察觉。可以用“大海捞针”测:在 32k、64k、128k 三档长度的无关文本中,随机位置埋一条指令或一个关键信息,让模型精确找出来。
出现以下情况,基本可以判定上下文被砍了:
- 超过某个长度就报错或超时,而这个长度远低于标称值;
- 针埋在开头或中间时答不出,埋在末尾才能答出;
- 返回的 prompt_tokens 明显小于你实际发送的长度。
如果只是输出变短,先看 finish_reason,排除 max_tokens 设置的问题,参考大模型 API 输出被截断怎么办。同时也顺手测一下 Tool Calls 和 JSON Schema / Structured Outputs:原版模型通常能严格按 schema 输出,替换后的模型更容易漏字段、格式错乱。
第四步:首字延迟和解码速度,只作辅助
参数量大的模型和小模型在 GPU 上的首字延迟(TTFT)和每秒解码 token 数有物理差异。如果标称旗舰模型,吞吐却快得像轻量模型,或者同一批请求里速度忽快忽慢、像是在几个模型之间来回切换,就值得怀疑后端换了模型或在混用调度。
但这个信号很容易被干扰:网络延迟、服务端负载、批处理策略、缓存命中都会影响数字。适合用来在长期监控里发现突变,不适合单独拿来下结论。
降精度量化最难测
量化部署(比如从 BF16 降到更低精度)不会改模型名,也不一定改变字段,主要表现为复杂任务上质量下滑,只能靠第二步的探针通过率去间接发现。精度本身也不是越低越坏,FP8 和 BF16 的取舍可以看模型推理精度 BF16 和 FP8 有什么区别。实际操作中,更现实的办法是要求服务商明确写出部署方式和精度,再用探针抽查。
把检查变成例行任务
一次性验过不代表一直没问题,生产环境建议:
- 把上面的脚本、探针题和三档长度的捞针用例固定成一个小测试集;
- 首次接入时与官方基准跑一遍,记录 token 数、通过率、TTFT、tokens/s;
- 之后定期或在服务商发公告后重跑,和第一次的记录比较,关注突变而不是绝对值。
选服务商时先看它让不让你验
技术检查是兜底,服务商本身的透明度同样重要:供给方式说没说清楚,配额和限速是否公开,是否承诺不换模型、不降精度、不砍上下文,以及是否给出可以复核的方法。
以 NexAIX 为例,只有两种供给方式:开源权重模型部署在自有算力集群,闭源模型走厂商官方授权渠道,每个模型页都标明属于哪一种,你可以按上面的方法逐项对照。四条承诺和对应的验证方法写在优势与验证方法页;要确认某个模型的供给方式和上下文规格,可以在模型清单里找到对应模型页。注册送的测试额度足够把这套检查完整跑一遍。



评论(0)