 NexAIX-官方博客
一次生产事故,让选型标准从价格转向容灾
凌晨两点,你的服务监控突然告警:调用第三方大模型API的超时率飙升至40%。你打开日志,看到清一色的429和5xx错误,业务线被迫降级为缓存回复。事后复盘,你发现单一Provider的抖动就足以让你的Agent应用瘫痪数小时。这类场景正在成为后端工程师的常态。而近期OpenRouter文档的更新,将这种痛点上升为行业标准的转向:它把故障转移明确拆分为Provider级与Model级两个独立层级,并上线/benchmarks端点暴露实时TPS、延迟与30天可用性数据。这意味着,多模型API网关的竞争已从单纯的价格中转,转向谁能在故障发生时提供更可靠、更透明的容灾机制。
对技术负责人而言,选型清单里必须增加一项新的验收维度:自动故障转移的触发条件是什么?它覆盖到哪一层?切换后你还能不能信任返回的model字段?本文将基于OpenRouter的机制,给出可照做的验收清单,并提醒你故障转移带来的可观测性债务。
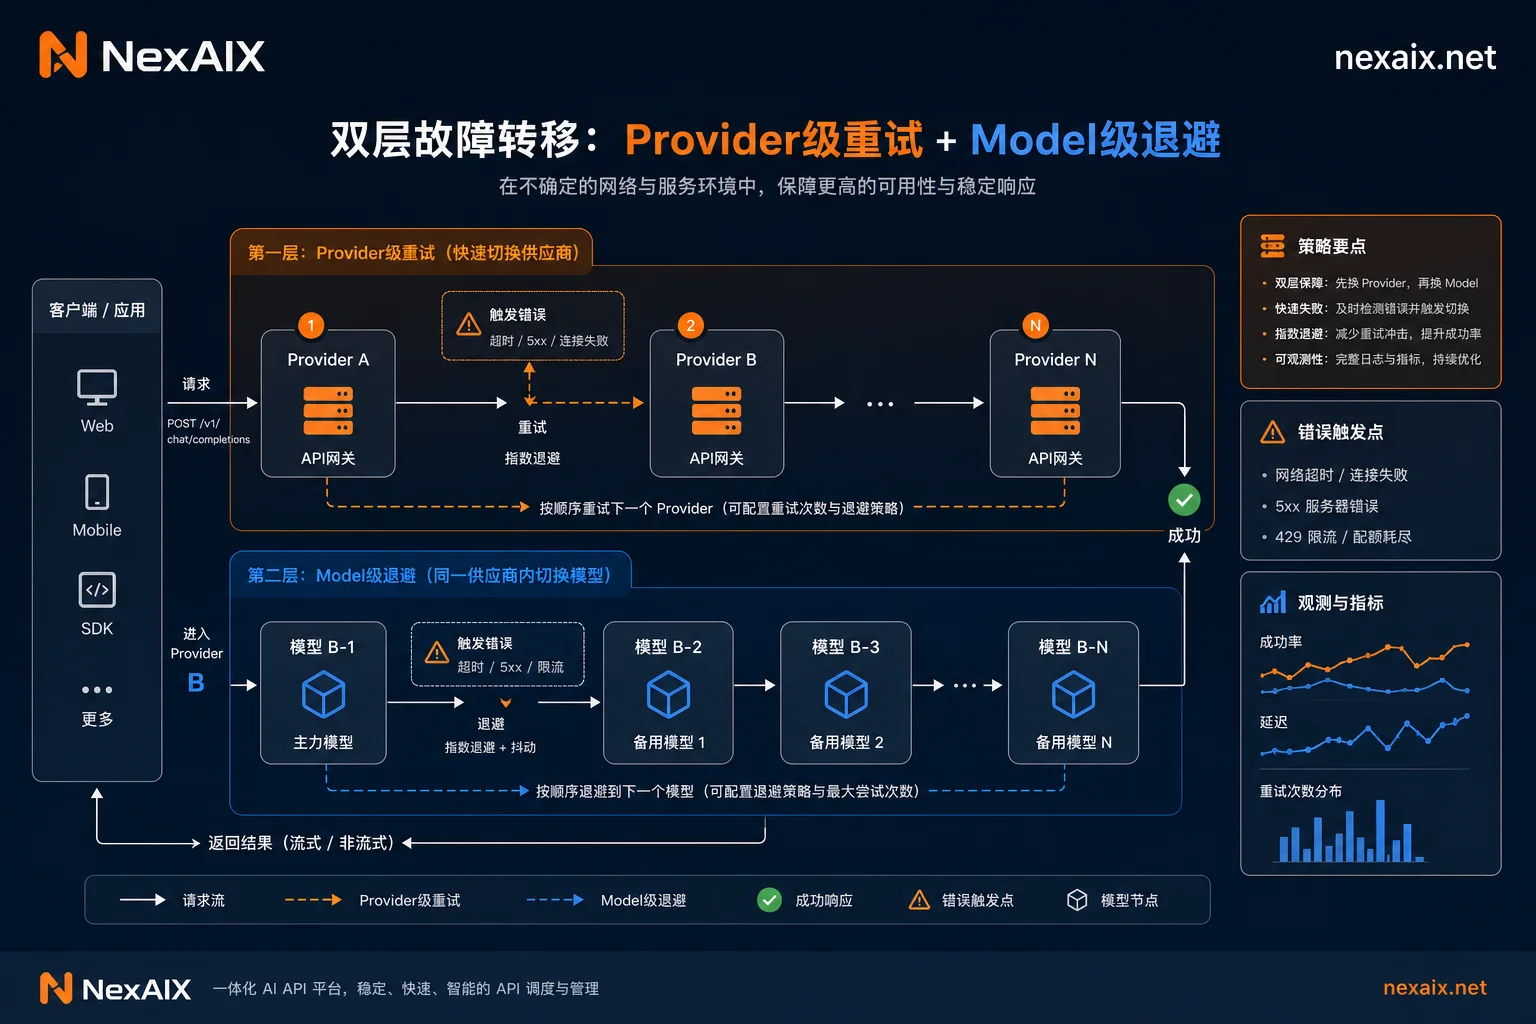
自动故障转移分两层:Provider级重试 vs Model级退避
根据OpenRouter文档(2026年8月更新),其故障转移机制是双层的:Provider级故障转移默认开启(allow_fallbacks: true),当某个Provider节点返回5xx或429错误时,网关自动将请求转发到另一个服务节点,同时将过去30秒内出错的节点临时降级,避免持续命中故障点。而Model级退避则需要显式配置models数组,当主模型的所有Provider都不可用、或遇到Context Length超限、审核拒答等场景时,网关会切换到备选模型。
这两层机制解决的问题完全不同,不能互相替代。Provider级重试针对的是同一模型的供应节点故障,对业务无感知;Model级退避则是模型层面的降级,可能影响输出质量。理解这一区别,是进行容灾验收的第一步。你的网关如果只宣称"故障转移",你需要追问:是Provider级还是Model级?触发条件是否包含429、5xx、超时以及上下文超限?
切换之后,你还知道跑在哪个模型上吗?
这是本文的核心争议点。自动故障转移虽然提升了可用性,却引入了三类可观测性债务:
- 流式输出中断:当请求正在流式传输中途,底层Provider失效,网关可能中止流。根据第三方分析(Requesty,2026年7月),部分Provider对取消的流(Cancelled Stream)仍会计费,导致成本账单与服务质量不符。
- 重试非幂等:如果请求带有副作用(如调用外部工具、写入数据库),网关自动重试可能重复执行,造成数据不一致。
- model字段失真:切换后,返回体中的model标识可能与你预置的模型不一致,而这会直接影响cost核算、eval结果归因以及线上问题复盘。
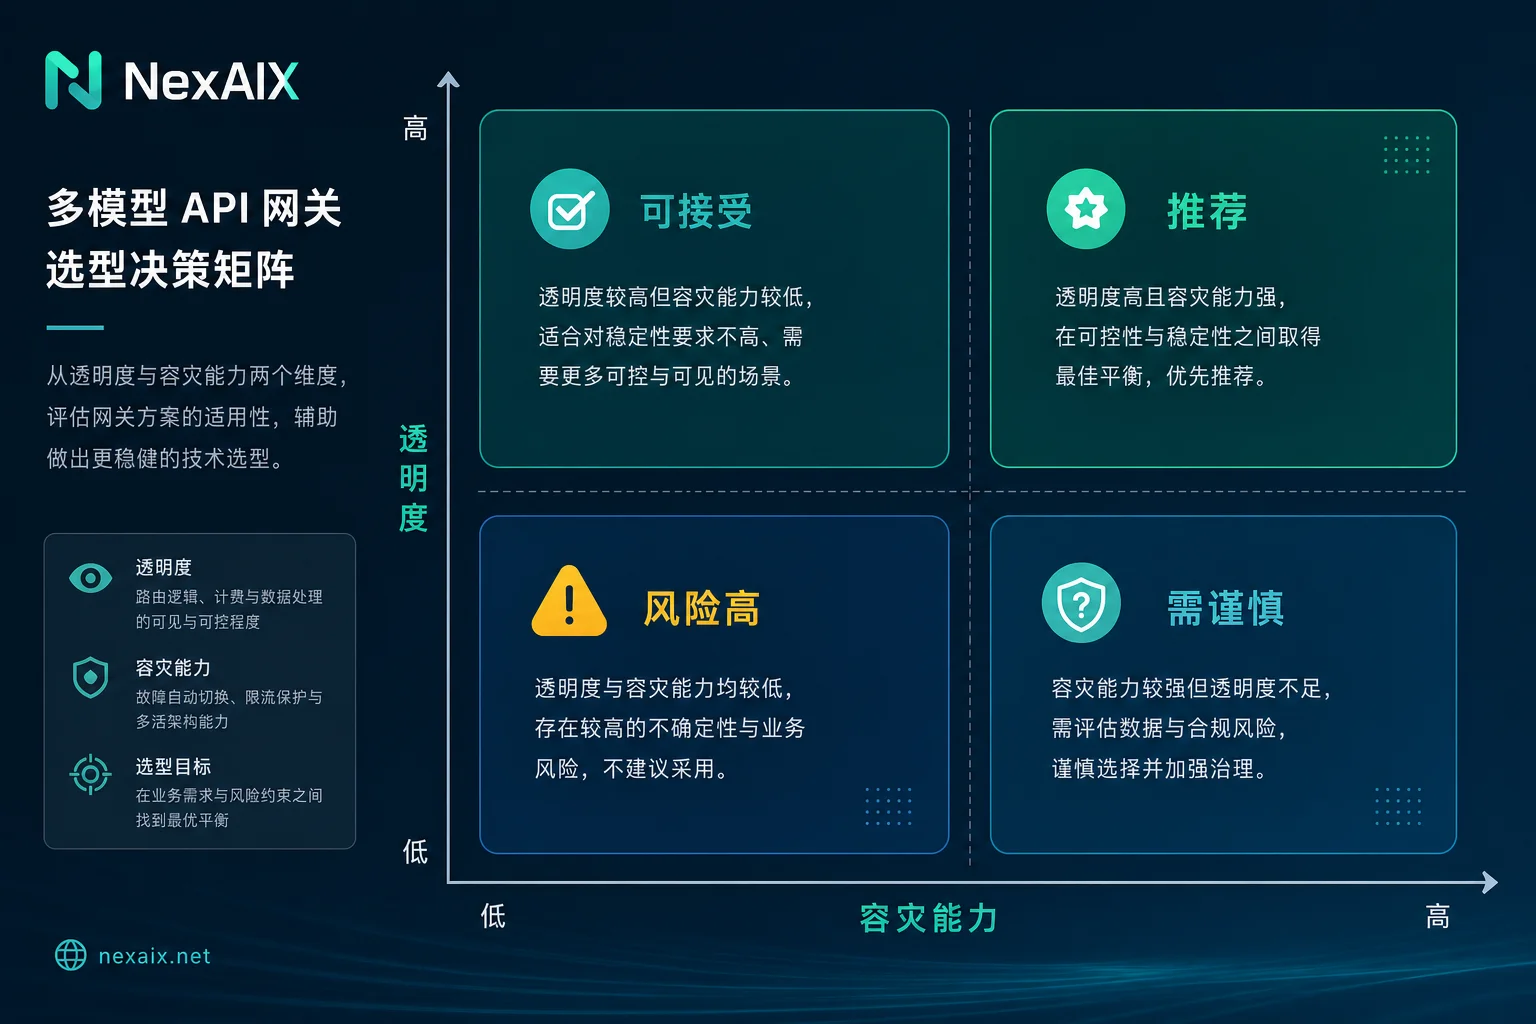
更严重的是"静默降级":某些网关可能在不告知的情况下,将请求路由到更便宜的模型以节省成本。这种"透明度"问题,应当成为供应商评估的红线。你需要确认网关是否如实回传model字段,以及它是否允许你完全控制降级策略。
客户端仍要自己做的事:幂等键、超时预算与退避策略
网关的容灾能力不能替代客户端的健壮性。你依然需要为带副作用的调用生成幂等键,并在应用层去重;将整链路超时拆分为connect、TTFT、总时长三段预算,避免网关重试叠加把P99拉爆;重试应采用指数退避加抖动,配合断路器,防止上游故障引发重试风暴;对于流式场景,需要准备断点重生成逻辑,不能假设无缝接续。
记住:网关的自动故障转移只是降低中断概率,而不是消除中断。你的架构设计必须考虑到最坏情况。
多模型API网关容灾验收清单:8个可直接照做的测试项
以下清单基于OpenRouter机制与行业最佳实践,建议你将此纳入供应商评估与上线前回归测试。
| 测试项 | 操作方法 | 合格标准 | 不合格信号 |
|---|---|---|---|
| 1. 标准错误码 | 故意触发429/5xx(如用真实请求压到限流阈值) | 网关返回标准429或其他5xx错误码,不吞错误 | 错误码被转换为200,或返回非标准内容 |
| 2. 上下文超限退避 | 构造超长上下文请求,使主模型触发Context Length | 网关明确报错,或按models数组切换模型,并在返回体标明实际模型 | 静默截断或返回无意义内容 |
| 3. 返回体model字段 | 连续发起请求,记录返回的model字段与请求配置 | model字段与实际执行模型一致,若有切换会明示 | model字段与预期不符,或恒为预设值 |
| 4. 取消流计费 | 流式请求中途主动取消,对比账单token与输出token | 取消的流不重复计费,或计费规则透明 | 账单token远大于实际输出 |
| 5. 幂等重试 | 提交带副作用请求,观察网关重试行为 | 网关不产生重复副作用,或提供幂等键支持 | 同一请求被多次执行 |
| 6. TTFT抖动 | 注入Provider故障,记录切换时的首token延迟 | TTFT抖动在可接受范围(如<1s) | 切换耗时超过业务容忍度 |
| 7. 错误码吞没 | 查看网关日志,确认错误码是否被拦截 | 网关保留原始错误码,并在响应或日志中透出 | 错误码丢失,或统一转为200 |
| 8. 静默降级 | 询问供应商书面承诺,并抽查请求日志 | 供应商承诺不静默切换模型,且日志可查 | 未明确承诺,或存在未说明的模型切换 |
路由评测数据怎么用:把benchmark当线索,而非结论
OpenRouter的/benchmarks端点聚合了Artificial Analysis、Design Arena与tau-bench/GPQA等第三方评估数据,允许按task_type或source筛选,并结合p90吞吐量与30天可用性进行路由约束。这类数据能帮你缩小候选模型集,但它反映的是宏观分布,并非你业务流量下的真实表现。因此,正确用法是:将其作为选型初筛的参考,最终必须以你自己的eval集与线上灰度数据为准。你可以把benchmark数据当作"线索",但"结论"必须来自你自己的验证。
用统一OpenAI兼容接口跑一次真实故障演练
在进行容灾验收时,你需要一套能在多个模型间无缝切换的对接方式。建议使用统一OpenAI兼容接口,这样同一套代码可以在不同网关、不同模型间进行对照eval。你可以设计三类故障注入:超时、取消流、超长上下文,然后记录各方案的latency、错误码与model字段。
以NexAIX为例,其公开服务承诺可作为透明度合格线的参考:满载时返回标准429与重试建议、不静默切换到更便宜模型、返回体model字段对应实际执行模型、只保留请求ID/模型名/token数/时间戳/状态码等排障元数据。其OpenAI Chat Completions兼容接口(base_url: https://api.nexaix.net/v1)支持流式与工具调用,便于你用同一套代码做容灾演练与横向对比。具体规格、价格与可用性,请以NexAIX当前模型页、定价页与状态页为准。
结论:可用性与透明度必须一起打分
多模型API网关的容灾能力,正在从"能自动重试"升级为"明确触发条件、重试幂等、拒绝静默降级、model字段如实回传"。选型时,请把容灾能力与透明度一起打分,并将本文的验收清单纳入评估流程。记住,网关本身也有路由开销,容灾只是降低中断概率,而非消除中断。把可用性和可观测性放在同等位置,才是生产级架构的正确打开方式。



评论(0)