 NexAIX-官方博客
同一个模型名,为什么你的首 Token 要多等几秒?
2026 年 4 月,多家服务商针对 DeepSeek V4 Pro(1.6 万亿参数 MoE,支持 1M 上下文)的实测显示,TTFT 从低于 1 秒到数秒不等,输出吞吐从 30 到 160+ tok/s 不等。这并非模型本身的问题,而是算力架构与节点搭建的差异。如果你自建 Agent 或 RAG 服务,对延迟和吞吐敏感,那么你需要一套方法,用可测数据判断你调用的 API 是真正的自有算力AI API,还是经过多层代理转发、可能“掺水”的中转站。
先对齐口径:TTFT、输出吞吐、E2E 各自测的是什么
DeepInfra 在 2026 年 6 月提出的三层 KPI 框架,给出了清晰的语义边界:
- TTFT(首 Token 延迟):从请求发出到收到第一个 token 的时间,反映排队与调度效率。
- 输出吞吐量(Throughput):每秒生成的 token 数,体现解码算力与 batch 策略。
- E2E(端到端延迟):从请求到全部响应完成的总耗时,体现用户真实等待。
这三个指标会分别被不同环节污染:网络抖动、代理层缓冲、流式实现都可能影响 TTFT 计时。首 token 延迟怎么测,取决于计时起点定义——必须从请求发出计到第一个非空 delta 落地,而不是到第一个 chunk 到达。因此,在流式响应中,正确测量首 token 时间应使用 Python + OpenAI SDK。示例代码如下:
import time
from openai import OpenAI
import statistics

client = OpenAI(api_key="YOUR_KEY", base_url="https://api.example.com/v1")

def measure_ttft():
    start = time.perf_counter()
    stream = client.chat.completions.create(
        model="deepseek-v4-pro",
        messages=[{"role": "user", "content": "写一篇短文"}],
        max_tokens=100,
        stream=True,
    )
    ttft = None
    chunk_count = 0  # 流式 chunk 数为近似速率,精确 token 数以最后一条响应的 usage 为准
    model_field = None
    for chunk in stream:
        if chunk.choices[0].delta.content:
            if ttft is None:
                ttft = time.perf_counter() - start
                model_field = chunk.model
            chunk_count += 1
    elapsed = time.perf_counter() - start
    status = 200
    return ttft, chunk_count, elapsed, model_field, status

N = 100  # 建议不少于 100 次成功请求;若只跑 20–30 次,只报 p50/p95 并明确标注 p99 不可用
samples = []
for _ in range(N):
    ttft, chunk_count, elapsed, model_field, status = measure_ttft()
    samples.append((ttft, chunk_count, elapsed, model_field, status))

ttfts = [s[0] for s in samples]
throughputs = [s[1] / s[2] for s in samples]  # chunk/s

p50 = statistics.quantiles(ttfts, n=100)[49]
p95 = statistics.quantiles(ttfts, n=100)[94]
p99 = statistics.quantiles(ttfts, n=100)[98]
print(f"TTFT p50/p95/p99: {p50:.3f}/{p95:.3f}/{p99:.3f} s")
print(f"输出速率均值: {statistics.mean(throughputs):.1f} chunk/s")
输出为你本地环境的实测值,本文不提供任何服务商的实测数值。需要注意的是,流式 chunk 数仅为近似速率,精确 token 数以最后一条响应的 usage 为准。
三层 KPI 与检测信号对照表:
| KPI | 反映链路 | 污染点 | 检测信号 |
|---|---|---|---|
| TTFT | 排队与调度 | 网络、代理缓冲 | p95/p99 分化 |
| 吞吐 | 解码算力 | batch 策略 | 并发塌陷 |
| E2E | 用户等待 | 整体链路 | 跨时段漂移 |
DeepInfra 的 KPI 框架说明了什么:自有算力AI API 和代理转发区别
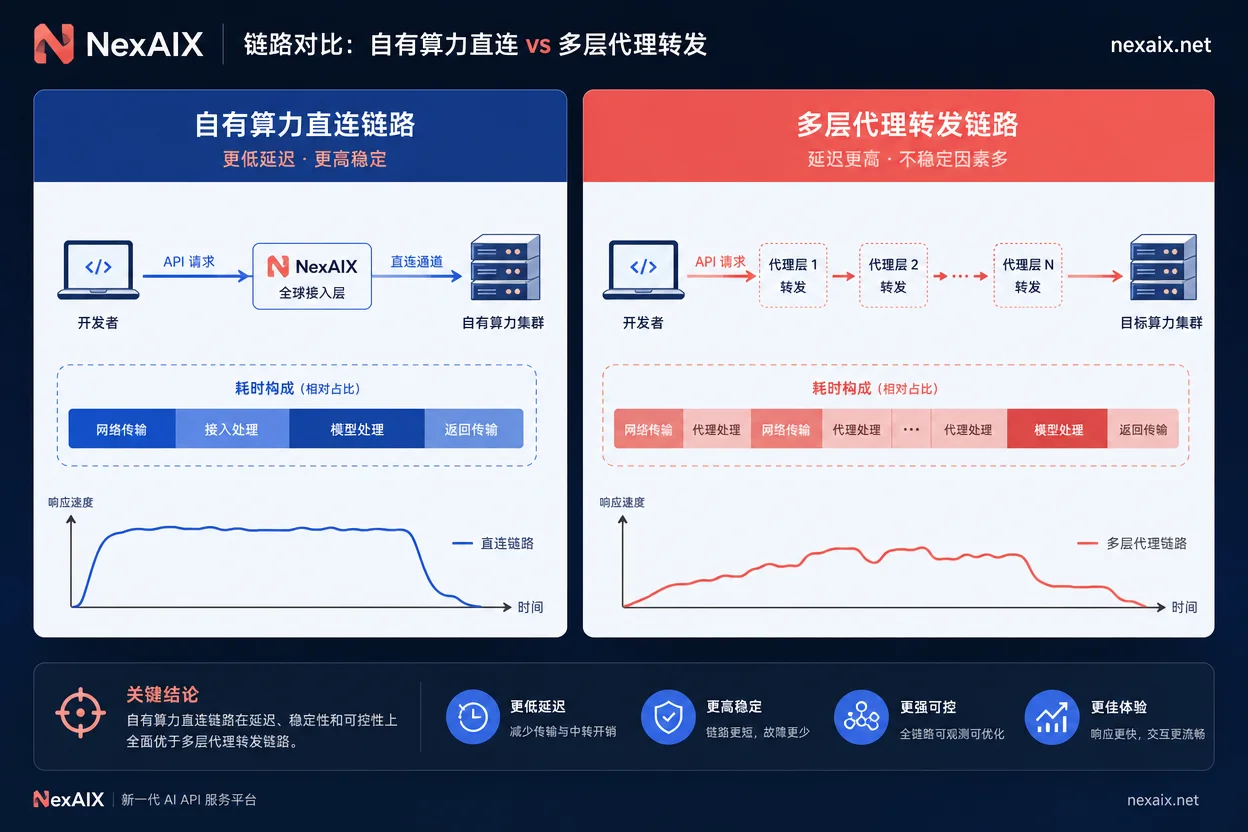
DeepInfra 强调,自有基础设施部署能在中高并发与长上下文场景下提供确定性性能保障。而多层代理转发则引入了额外的排队与路由不确定性。聚合中转平台(如 OpenRouter)以跨 Provider 自动路由保证连通率,但开发者担忧静默路由导致模型降级或行为不一致;自有算力服务商则固定底层节点并透传实际执行模型,保障一致性。但这两条路线是业务取舍,而非优劣之分:如果你的业务更看重连通率,中转站可能更合适;如果看重稳定性能,自有算力更可控。
压测协议:固定 prompt、固定输出长度、并发梯度与时段采样
要分辨自有算力AI API 与代理转发,必须设计可复现的压测实验。下面这套流程既是大模型 API 吞吐量的测试方法,也是判断并发上限从哪一档开始塌陷的依据:
- 固定 prompt 模板:使用一个代表生产场景的 prompt,固定输入长度。
- 固定 max_tokens:例如设为 100,控制输出长度。
- 关闭随机性:设置 temperature=0,固定 seed。注意:部分兼容端点不支持 seed 或忽略 temperature=0,需在正式采样前先跑一次一致性检查,若不支持则改为固定 prompt 多次采样取分位数,并在报告中标注该限制。
- 并发梯度:1、4、8、16、32,每档不少于 100 次成功请求(p95 判读的下限),若只跑 20–30 次,只报 p50/p95 并明确标注 p99 不可用。
- 时段采样:覆盖工作日高峰(如 10:00-12:00)与凌晨低谷(如 3:00-5:00)。
- 记录元数据:request id、返回体 model 字段、usage token 数、状态码。每个字段都有验收用途:request id 用于向供应商追溯单次异常、model 字段用于核验是否被替换、usage token 数用于与本地 tokenizer 估算交叉比对、状态码用于区分限速与故障。
本节脚本为单并发骨架,并发梯度需用线程池或 asyncio 并发发起同一函数,本文不展开实现。
五组可执行数据:分位数分化、吞吐塌陷点、跨时段漂移、长输出稳定性、429 前兆
以下阈值均为方法示意,需以你自己的基线数据校准,本文不提供任何服务商的实测数值。
分位数分化(TTFT p50 vs p95/p99)
AI API 延迟 p95 p99 分析的核心不是均值,而是尾部行为。
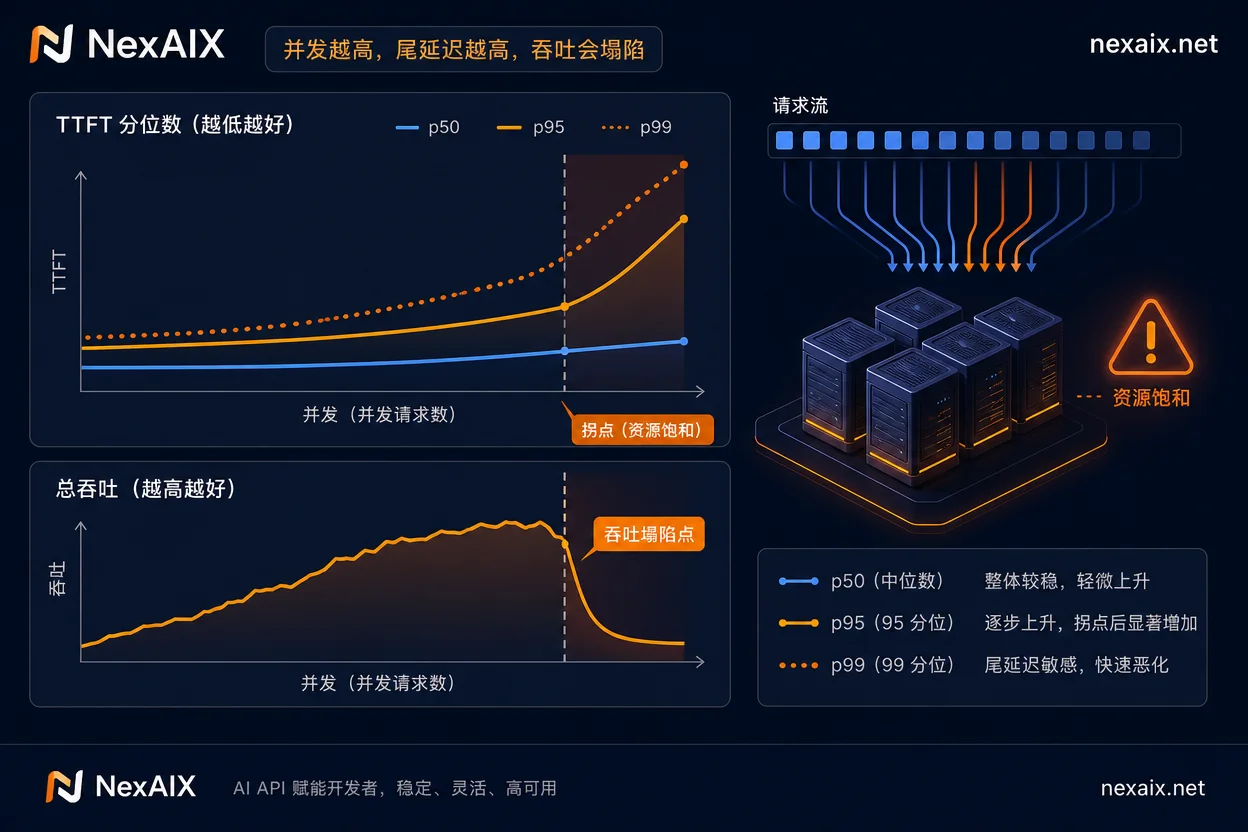
- 信号:p95/p99 与 p50 的比值持续大于某一你自定的阈值(如 3–5 倍,阈值需按自身 SLA 设定)。
- 可能原因:请求排队或资源抢占,常见于共享资源池。
- 交叉验证:检查并发梯度下 p95 是否随并发上升而恶化。
- 具体做法:同时记录同一批样本的网络 RTT 基线(如对 base_url 做 TCP 握手计时),先扣除网络抖动再判断 p95/p99 分化是否来自服务端排队。
吞吐塌陷点
- 信号:并发从第 k 档升到第 k+1 档时总吞吐不增反降。
- 可能原因:后端容量触顶或限速生效。
- 交叉验证:同时记录 429 占比、是否带 Retry-After 与配额说明字段,若吞吐塌陷但无任何 429 且 model 字段不变,需进一步排查是排队而非限速,且不得据此单独判定掺水。
跨时段漂移
- 信号:同一并发下,凌晨测得的 TTFT 和吞吐明显优于白天。
- 可能原因:资源池共享,或路由在不同时段变化。
- 交叉验证:查看返回的 model 字段是否始终一致。
- 具体做法:两个时段必须使用同一 prompt、同一并发档与同一客户端出口网络,并在报告中记录采集起止时间戳,否则漂移结论不成立。
长输出稳定性
- 信号:输出 token/s 随时间衰减,尤其是输出长度进入你业务的长文档区间时。
- 可能原因:长上下文下注意力计算压力增大,或 batch 挤压。
- 交叉验证:对比不同 max_tokens 下的吞吐曲线。
- 具体做法:按输出进度分段统计速率(如每 200 token 一段)画衰减曲线,而不是只看整段平均,衰减发生的位置比幅度更有诊断价值。
429 前兆
- 信号:在出现 429 之前,延迟逐渐抬升。
- 可能原因:限速策略触发前的排队。
- 交叉验证:确认 429 是否携带 Retry-After 头,以及错误信息是否明确。
注意:单个信号不足以定性,必须交叉验证。
性能异常 ≠ 掺水:用 model 字段、token 计数与错误码做交叉验证
性能差异不等于掺水。要判断是否“暗降级”,需核对:
- model 字段:返回体中的 model 是否与请求一致。
- token 计数:usage 的 token 数是否与本地 tokenizer 估算量级吻合。
- 错误码:满载时是标准 429 还是静默降级。
小型中转站宣称“100% 原装通道”,但缺少公开状态页和完整 model 字段时,无法证实,只能靠可复测数据判断。
把压测脚本接到统一 OpenAI 兼容端点上做横向对照
横向压测的前提是使用统一的 OpenAI 兼容接口。NexAIX 提供 base_url https://api.nexaix.net/v1。NexAIX 对开源权重模型使用自有算力集群部署,闭源模型走官方授权渠道,因此上一节需要核对的 model 字段与 429 行为在同一端点内语义一致。核对项如下:
- model 字段透传:对照请求与返回体 model 是否一致。
- 满载返回标准 429 与重试建议:观察是否携带重试信息而非静默切换。
- usage 元数据可核对:只保留请求 ID、模型名、token 数、时间戳、状态码,可直接对应压测脚本记录的字段。
- 不记录 prompt/completion:压测样本内容不进入日志。
你可以用测试额度,按本文协议在 NexAIX 上跑同一套脚本,核对上述字段。具体规格与可用性以当前模型页与更新日志为准。
供应商验收清单:签约前必须要到的 8 项指标与承诺
| 指标 | 要求 |
|---|---|
| TTFT p50/p95/p99 | 指定并发下的分位数 |
| 输出 token/s | 平均与最低值 |
| E2E 上限 | 最大可接受延迟 |
| 限速与配额规则 | 明确每分钟/每小时上限 |
| 429 行为 | 标准错误码 + 重试建议 |
| model 字段透传 | 必须与实际执行模型一致 |
| 日志保留 | 请求 ID、token 数、时间戳等 |
| 状态页与变更通知 | 有公开状态页,重大变更提前通知 |
注意:目前缺少第三方关于中转站 429 后平均恢复时长(MTTR)的公开统计,此项需供应商自证或自行长期采样。
结论:先定义指标,再谈稳定
稳定不是形容词,而是分位数。选型的第一步是把验收指标写进合同或内部 eval,第二步才是比价。建议你先按本文协议在自己的生产 prompt 上跑一轮基线,再用测试额度在 NexAIX 的兼容端点上对照,一周内即可完成最小行动路径。



评论(0)