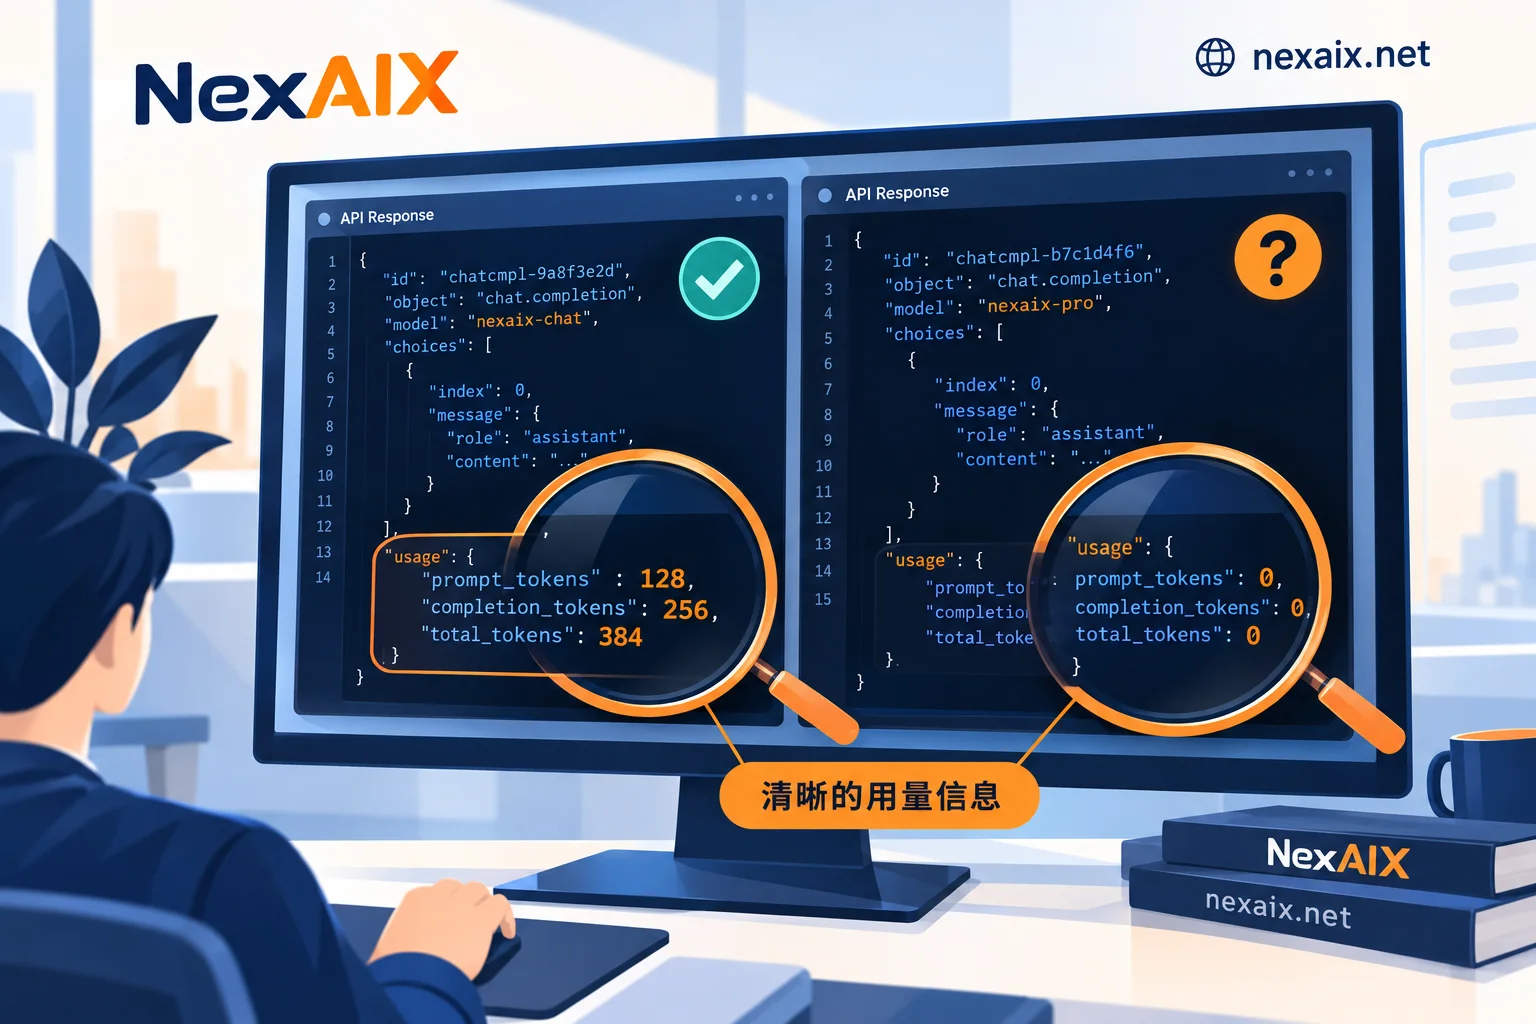
直接问模型“你是谁”不能验真。本文给出一套可执行的交叉检查:核对响应字段与 usage,用固定探针对比能力,做长上下文压测,再参考首字延迟和解码速度,并说明每种方法的边界和适用场景。
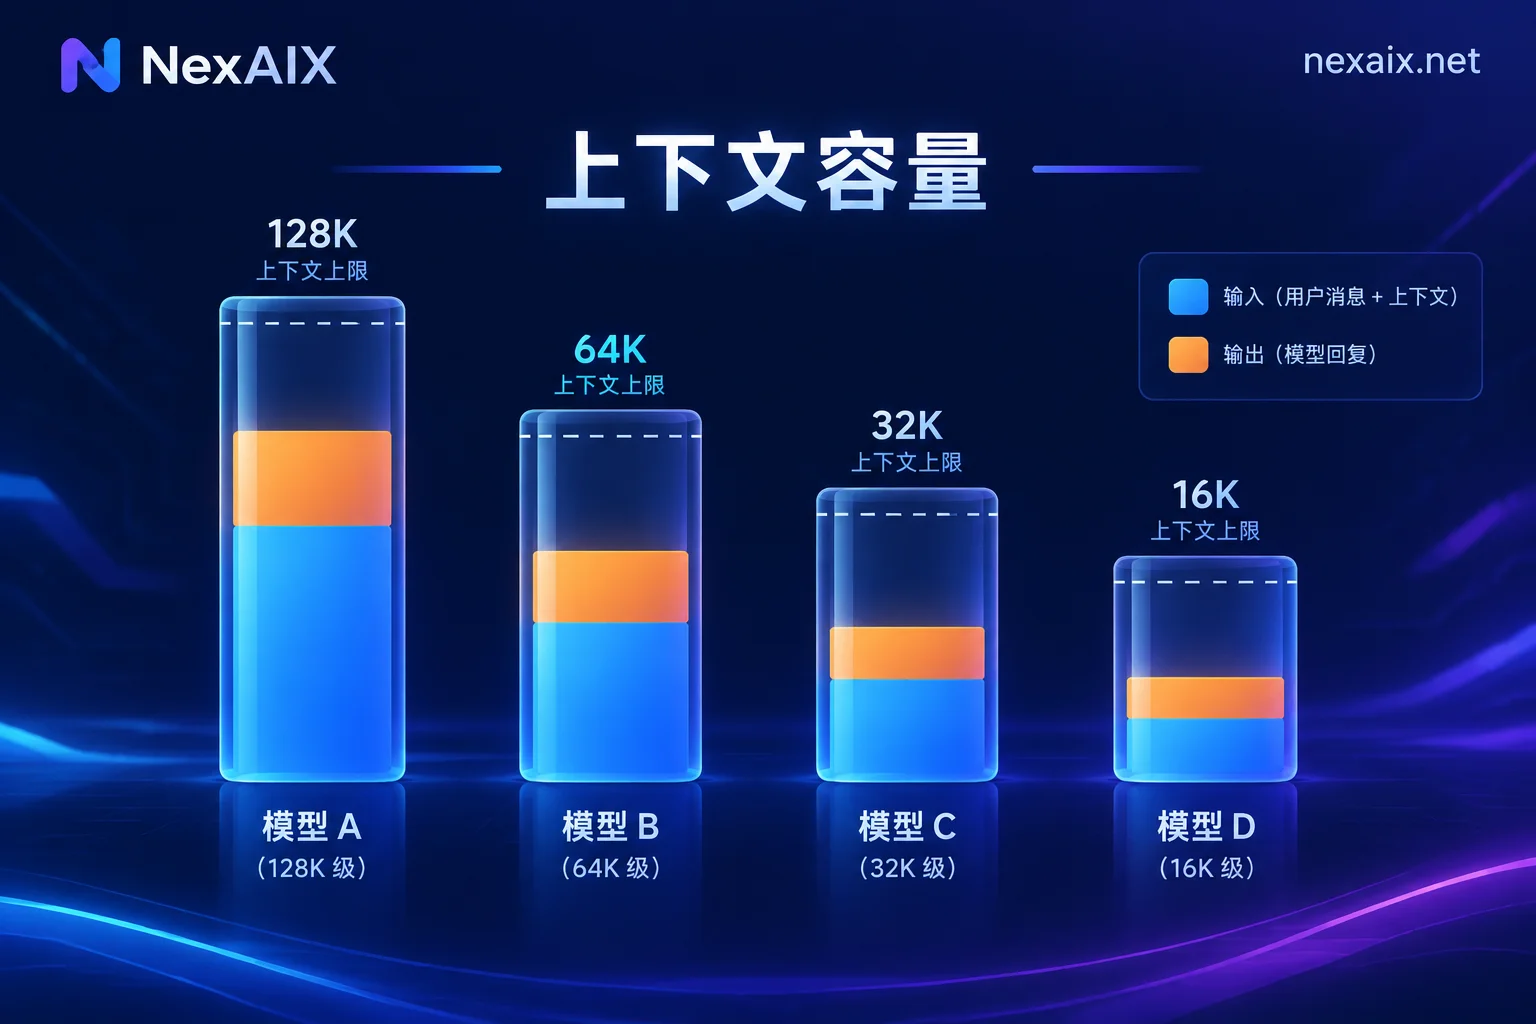
对比 GPT-4o、Claude 3.5 Sonnet、DeepSeek-V3、Gemini 1.5 等代表版本的上下文窗口与单次输出上限。本文说明如何按「输入 + 预留输出 ≤ 窗口」计算 token 预算,并按任务选择窗口档位。遇到输出截断时,可以用 finish_reason 和 usage 定位原因。文中也给出应对长上下文带来的延迟、注意力衰减和 TPM 限流的做法。
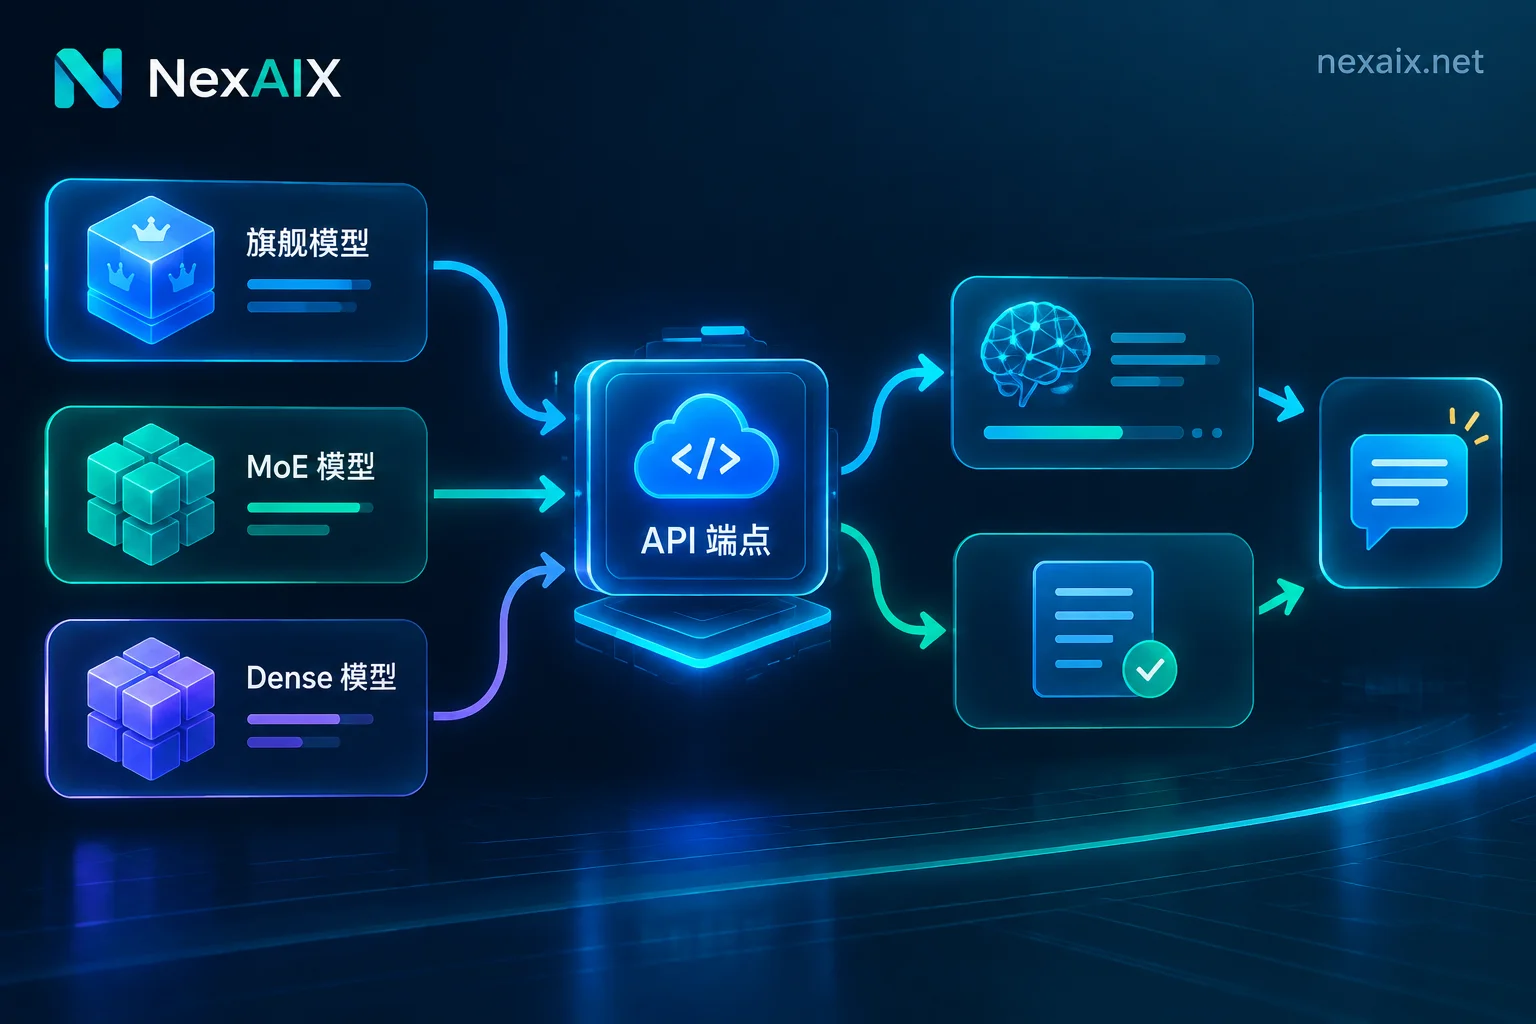
从手上的任务出发判断该用 Qwen3.6-Plus 还是 35B-A3B / 27B 开源版,给出 OpenAI 兼容端点的接入写法、思考模式开关与 reasoning_content 解析、工具调用与思考留存的注意点,以及上下文和降配的实测方法。
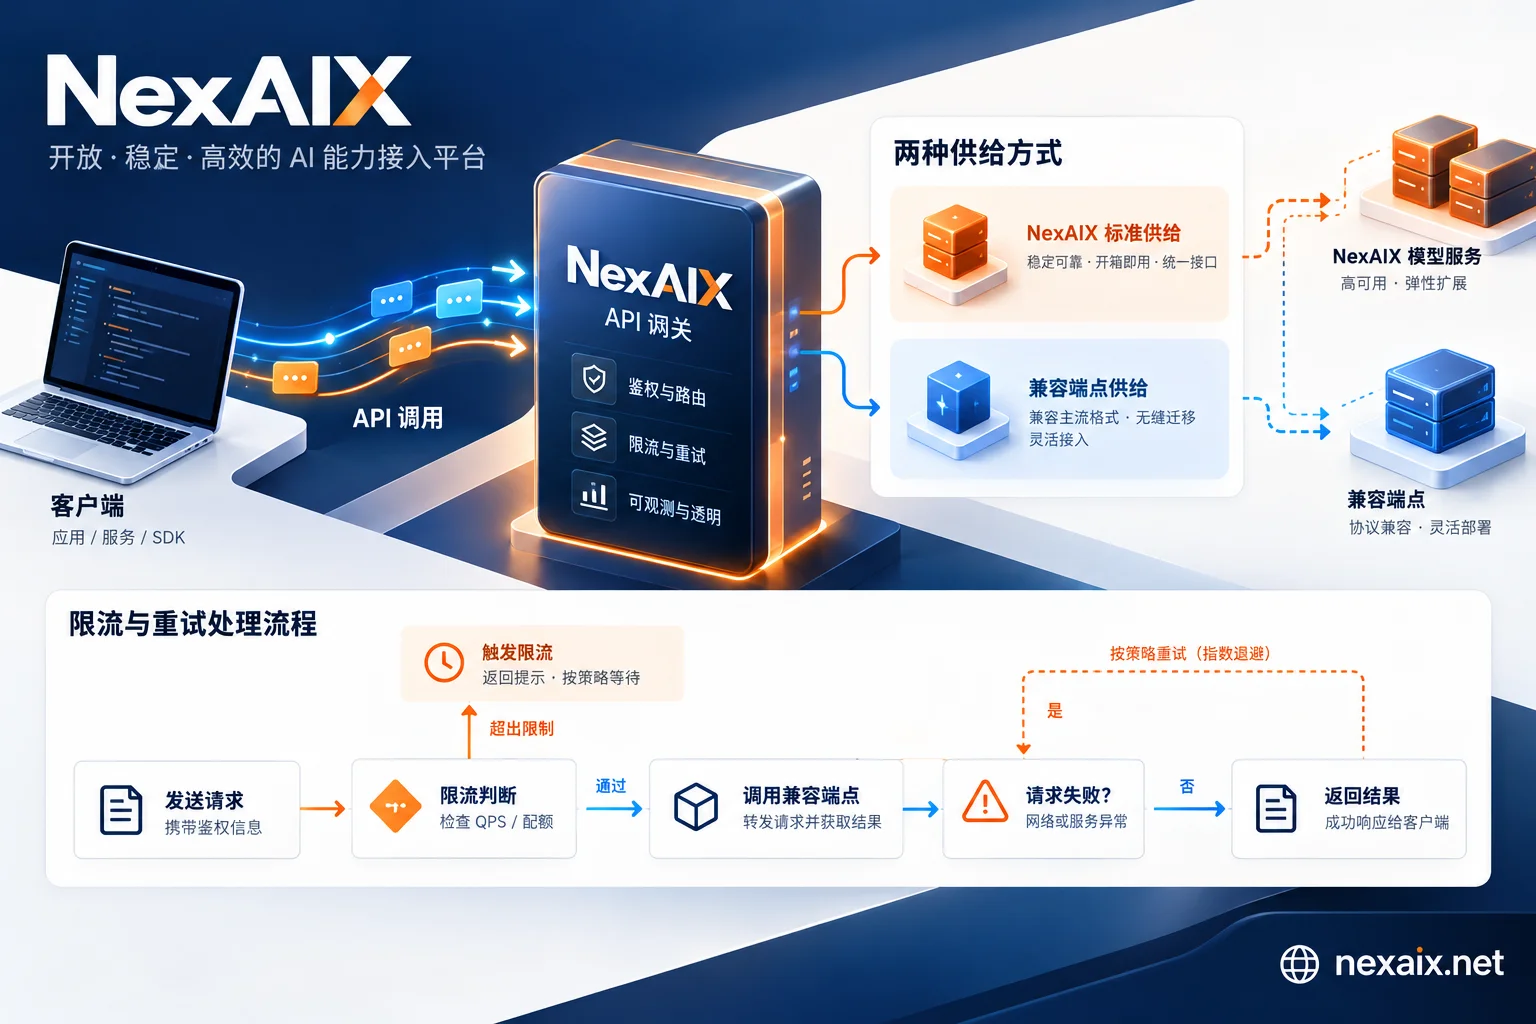
从手上的任务出发判断要不要用 Grok 4.5,再给出 OpenAI 兼容端点下的最小可用请求、reasoning_effort 档位与工具调用配置,以及长上下文、超时截断、限流重试的处理方式,最后用指纹、长文检索和 reasoning_tokens 三种方法验证拿到的是不是原生模型。
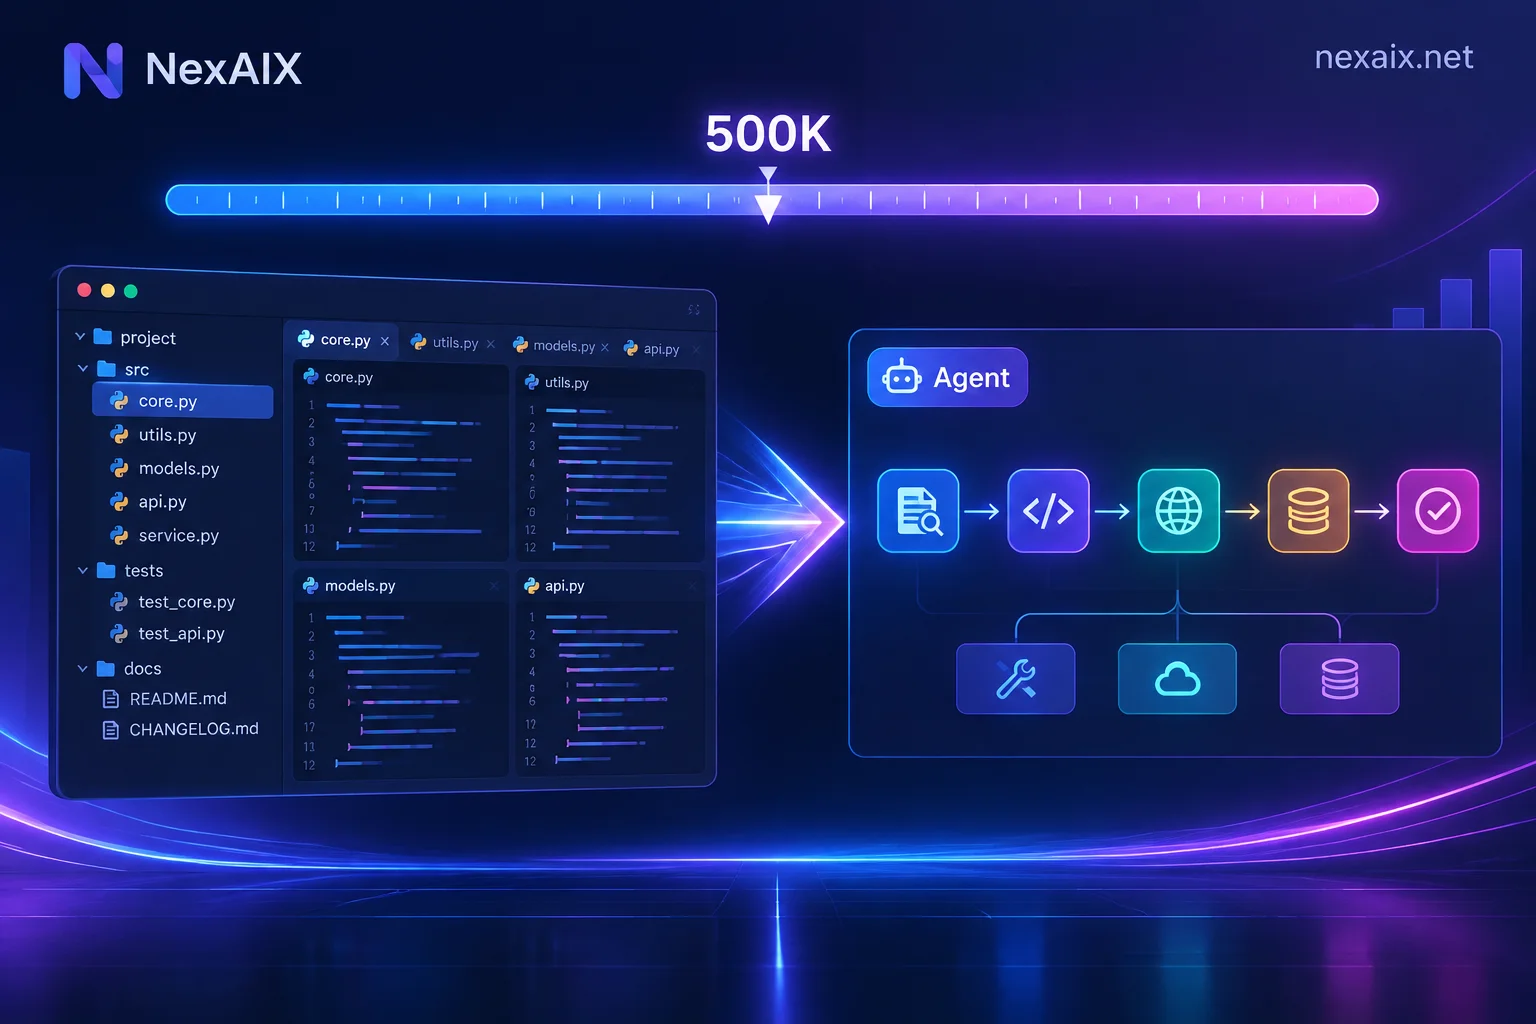
GLM-5.2 面向长程任务和智能体工程,1M 上下文、OpenAI 兼容接口。这篇讲清楚什么任务值得用它、Cursor 和 Claude Code 之类客户端怎么改配置、思考档位字段怎么试、1M 上下文下的超时与截断怎么排查,以及怎么确认你调到的确实是 GLM-5.2 而不是被转发或缩水的版本。
0 条留言
 NexAIX-官方博客