 NexAIX-官方博客
AI中转站掺水不是一种现象,而是四种可独立验证的形态:模型身份不符、规格降档、能力阉割、计费虚高。每种形态的侦测手段和判定阈值完全不同,用单一方法无法查全。社区从 2025 年 8 月起就在提醒低量化 Provider 的风险,2026 年 6 月 OpenRouter 又发布了服务端 Provider 路由与防降级文档——两条线索说明这已是行业共同课题。下文给出四套可复现探针,配合正常抖动排除表,让你能自己跑出结论。
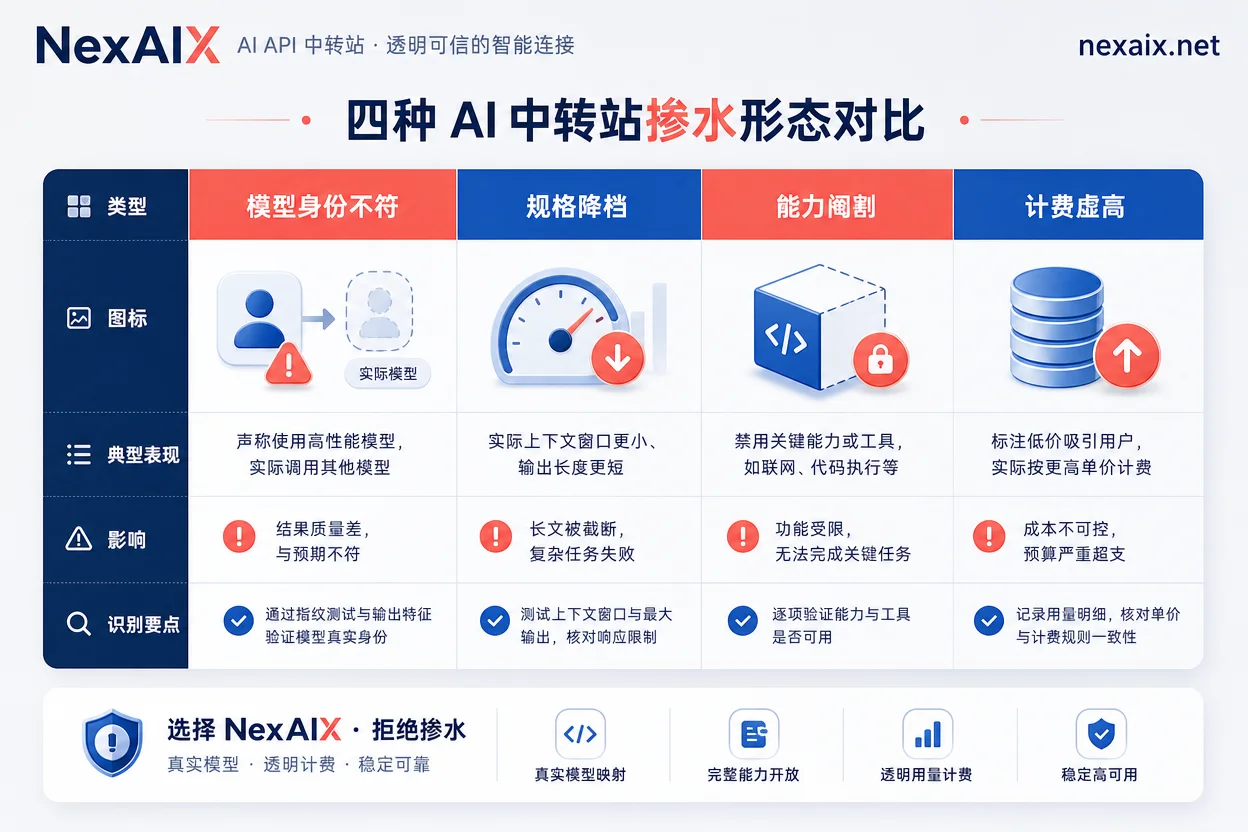
为什么中转链路上偷换模型在结构上是可能的
AI中转站掺水之所以在结构上可能发生,前提是代理层拥有改写空间。代理商可以在返回体中改写 model 字段、修改 usage 计数,甚至直接调用另一个模型,开发者只拿到最终文本。更隐蔽的是,部分低成本 Provider 为了在聚合网关中靠价格优势获取自动路由流量,会刻意降低量化精度(例如极端 low-quant),造成输出质量下降。2025 年 8 月,Reddit r/LocalLLaMA 社区就有开发者提醒“选择 OpenRouter 上的提供商需谨慎”。2026 年 6 月,arXiv 上的 Aegis 论文也明确指出,API Router 作为中间人,确有改写请求和偷换模型的隐患。
探针一:核对model字段与usage,先查模型身份不符
核对返回体中的 model 字段与 usage 结构,需与 OpenAI 兼容返回体结构逐字段比对。例如,官方 OpenAI 返回体中 model 字段是一个字符串,usage 包含 prompt_tokens、completion_tokens、total_tokens。你需要与官方渠道的返回体逐字段比对,重点看三点:
- 模型名:是否与你请求的一致,是否有多余空格或缩写。
- finish_reason:正常完成是 stop,若总是 length 可能被截断。
- usage 字段:
prompt_tokens、completion_tokens、total_tokens是否自洽(total = prompt + completion),以及是否存在prompt_tokens_details等结构。
如果 model 字段返回的模型名与实际执行模型不一致(比如你请求 claude-opus,但返回体里是其他 ID),或 usage 结构缺失关键字段,说明返回体声明的模型与实际执行模型可能不一致。若 model 字段在相同请求下随机变化,是需要立即向供应商要求解释的强信号,但仍需结合探针二、四交叉验证。这里也提供了 OpenAI兼容API 的参考实现,便于印证结构。
探针二:能力边界测试
能力阉割型掺水不改变模型名,但静默限制功能。测试方法如下:发送接近该模型官方宣称上下文上限 80% 长度的文本,具体长度以模型官方文档为准。可测试长上下文、工具调用、多模态等能力。
| 能力维度 | 测试方法 | 正常表现 | 异常信号 |
|---|---|---|---|
| 长上下文 | 发送接近官方宣称上限80%长度的文本并询问开头细节 | 能正确回捞 | 直接报错或忽略前文 |
| 工具调用 | 请求返回 function_call 结构 | 返回结构化工具参数 | 只返回文本或参数缺失 |
| 多模态 | 传入图片并提问 | 正常分析图像 | 报错或忽略图片 |
如果你的 API 声称支持多模态,但传图后报错,或工具调用参数不完整,那么能力被阉割的可能性很大。怀疑 GLM 旗舰被换成小参数版本时,这项测试最能出结论。
探针三:中转站用低量化模型怎么发现——确定性输出对照
对于规格降档(如量化精度下降),需要间接证据。方法:固定 prompt、温度设为 0,多次重采样(比如 20 次)。正常情况下相同输入应得到高度一致的输出;如果输出分布系统性偏移,比如逻辑不一致、常见错误增多,则可能运行的是低量化模型或小参数模型。结合探针一与探针二的结果,可以提高低量化部署判定的置信度——这也是排查“中转站是否换用低量化模型”时最实用的组合。这项测试的局限是:无法直接证明是哪种降档,只能作为间接信号。
探针四:账单核对
计费虚高是另一种掺水。核对方法:用本地分词器(如 tiktoken)对 prompt 和 completion 分词,统计 token 数,与 API 返回的 usage 值对比。5% 是本文建议的排查起点(不同分词器与特殊字符会造成天然偏差),不是官方判定标准。同时检查 prompt_tokens_details 中的 cached_tokens 字段:若缓存计数为 0,但请求中有大量重复前缀,则缓存扣费可能被夸大。
| 核对项 | 本地统计 | API usage 值 | 偏差率 | 判定 |
|---|---|---|---|---|
| prompt_tokens | 基于分词器 | 返回字段 | >5% | 需复核 |
| cached_tokens | 基于前缀 | 返回字段 | 自洽性 | 需复核 |
别急着下结论:这5类现象不是AI中转站掺水
判断AI中转站掺水前,先排除以下5类正常抖动。
| 现象 | 正常原因 | 与掺水的区别 |
|---|---|---|
| 偶尔输出差异 | 采样随机性 | 若固定温度仍大范围漂移才可疑 |
| 响应变慢 | 负载均衡 | 延迟波动不伴随质量变化 |
| 版本更新导致行为变化 | 官方模型升级 | 变化是全局性的,且官方有更新日志 |
| 系统提示差异 | 不同渠道可能附加 system prompt | 若去除系统提示后行为一致则正常 |
| 长文本被截断 | 上下文窗口限制 | 若低于官方宣称窗口则异常 |
例如,官方模型更新后,输出风格可能改变,但这不等于掺水。
行业正在怎么解:显式Provider路由、ZDR与TEE忠实转发
2026 年 6 月起,OpenRouter 官方推出服务端 Provider 路由与 Fallback 策略,允许开发者用 provider 对象显式排除劣质节点,并配置 ZDR(零数据留存)规则,防止隐蔽替代。这意味着开发者可以指定“只使用某个 Provider”,从而绕开低量化节点。同期,arXiv 的 Aegis 研究提出用可信执行环境(TEE)从硬件层面约束 API 网关的忠实转发,杜绝中间人改写。需要说明的是,这些机制目前并非行业强制标准,但为“防掺水”提供了可操作的方向。若要了解网关侧的可配置能力,可参考多模型API网关。
选型阶段该向供应商索取的承诺清单
在充值或签约前,可要求供应商就以下5条给出书面口径,并保留截图:
- 模型身份:返回体 model 字段必须与实际执行模型一致。
- 规格透明:是否使用量化模型、量化位宽是多少。
- 能力完整:工具调用、多模态、长上下文等能力不被静默关闭。
- 计费准确:token 计数与本地分词器偏差应在合理范围。
- 故障策略:负载过高时是返回标准 429 错误,还是静默切换模型。
其中与本文探针直接对应的两条是:model 字段对应实际执行模型、满载返回标准 429 而不静默切换;其余承诺(如规格透明、能力完整、计费准确)可要求供应商给出书面口径。你可以在其自有算力AI API上用文中同一套探针,通过 OpenAI 兼容接口 https://api.nexaix.net/v1 和测试额度自行复测这些承诺。NexAIX 也承诺只保留请求 ID、模型名、token 数、时间戳、状态码等元数据,不保留请求内容。
常见问题
我的探针结果能作为和客服对质的证据吗?
可以,但有限制。建议保留完整的请求日志、响应体、时间戳和账单截图。若发现 model 字段不一致或 token 计数偏差,可明确要求对方解释。注意,输出质量对比只能作为辅助信号,不能单独证明掺水。
正常抖动和掺水怎么区分?
正常抖动与AI中转站掺水的核心差别在于是否呈系统性偏差。正常抖动通常在固定输入下输出有波动,但整体逻辑一致;掺水则表现为系统性偏差,如复杂度高的任务频繁出错。可使用上文「正常抖动排除表」鉴别,若多次测试均出现一致的质量下降,才可怀疑掺水。
中转站 token 计数虚高怎么核对?
用本地分词器统计并比对。以 GPT-4 系列为例,使用 tiktoken 分词;GLM 系列则使用对应的分词器。若偏差超过 5%,建议检查缓存计费规则,并保留证据。
便宜的中转站一定有问题吗?
不一定。但价格过低(低于官方成本)时,很可能通过低量化或混用模型来压缩成本。建议用探针测试核心能力,并查看是否有透明度的承诺。
我能要求供应商提供模型指纹吗?
可以要求,但部分供应商可能无法提供。OpenRouter 的 provider 路由可让你指定特定节点,但这并非行业标准。若供应商拒绝提供任何验证手段,谨慎选择。NexAIX 在其 API 文档中说明会返回模型名与用量信息,你可自行核对。



评论(0)