 NexAIX-官方博客
2026 年 7 月,OpenRouter 与 LangChain 推出了官方维护的专用包 langchain-openrouter(PyPI)和 @langchain/openrouter(npm),同时 LangChain 官方文档明确了 ChatOpenAI 仅对齐官方 OpenAI 规范。这意味着 LangChain 接入统一AI API 的方式从“覆盖 base_url 的单一旧模式”变成了“两种官方路线”。本文事实以截至 2026-07-29 可查的官方文档口径为准,帮你决策:什么时候继续用 ChatOpenAI 覆盖 base_url,什么时候该引入 langchain-openrouter。结论前置:如果你的核心场景是基础对话、RAG、常规工具调用,且希望保留多供应商切流能力,请坚持 OpenAI 兼容接口的 base_url 写法;只有当你明确需要跨供应商路由策略、节点级故障转移或解析专有推理字段时,才引入专用包。下文将拆解能力边界、迁移成本与折中架构。
变更点:LangChain 接统一AI API,从覆盖 base_url 变成了“两条官方路线”
过去,LangChain 开发者接入统一AI API(如 OpenRouter)几乎只有一种做法:在 ChatOpenAI 中覆盖 base_url 并传入目标模型名。而 2026 年 7 月,据 OpenRouter 与 LangChain 官方文档(2026 年 7 月口径),双方推出了官方维护的专用包 langchain-openrouter(PyPI)/ @langchain/openrouter(npm),提供 ChatOpenRouter 类,原生支持跨供应商模型标识、端点路由策略与自动故障转移机制。与此同时,LangChain 官方 ChatOpenRouter 集成文档(python.langchain.com,2026 年 7 月)说明,ChatOpenAI 仅匹配 OpenAI 官方规范,对第三方 provider 扩展的非标字段(如 reasoning_content 这类推理内容输出)不会进行提取或保留。
这一变更的实质是:官方不再把 base_url 覆盖当作通向统一AI API 的唯一“民间偏方”,而是为需要供应商专有能力(路由、故障转移、专有字段解析)的场景提供了第一方支持。但官方也并未否定标准兼容写法——对于只需要标准 Chat Completions 能力的场景,ChatOpenAI 依然完全可用。先盘点你的链路是否用到路由策略、故障转移或专有推理字段;三项都没有,就不必迁移。
两种写法的能力边界对照:哪些参数只有专用包能表达
langchain-openrouter 与 ChatOpenAI+base_url 并非“新写法”与“旧写法”的简单替换,而是能力边界有差异的两条路线。下表基于官方文档已确认的信息,列出你在选型时必须检查的能力项:
| 能力维度 | ChatOpenAI + base_url(OpenAI 兼容) | langchain-openrouter / ChatOpenRouter |
|---|---|---|
| 初始化与凭据 | 通过环境变量设置 OPENAI_API_KEY、OPENAI_BASE_URL | 通常使用独立 API Key,凭据加载方式以官方文档为准 |
| 模型标识形式 | 按 OpenAI 规范传入完整模型名 | 支持跨供应商模型路由标识(具体格式以官方文档为准) |
| 流式输出 | 支持标准 SSE 流 | 支持流式输出,具体实现以官方包文档为准 |
| 工具调用 | 支持 OpenAI Chat Completions 的 Tool Calling 标准结构 | 支持标准 Tool Calling,以官方包文档为准 |
| 跨供应商端点路由策略 | 无内建支持,需自行在代码中实现 | 原生支持(据官方文档) |
| 自动故障转移 | 无内建支持,需依赖外部重试逻辑 | 原生支持(据官方文档) |
| 非标响应字段解析(如 reasoning_content 类) | 不提取、不保留(官方文档确认) | 官方文档指出需保留专有推理输出时应使用供应商专用包,具体保留字段以官方文档为准(本文推论:可保留) |
注意:上表中“以官方文档为准”的部分,并非含糊其辞——事实包中未给出具体参数名、版本号或安装命令,硬编码反而会误导读者。这类信息变化快,建议直接查阅官方仓库与文档。标注“推论”的行为本文基于官方口径的推断,落地前请自行实测。照表逐项打钩,只要有一项落在专用包独有列,再进入下一节的成本核算。
可移植性成本核算:换一家统一AI API 供应商,你要改多少行代码
评估统一AI API 供应商锁定深度时,最实在的问题是:如果明天换一家统一 AI API 提供商,我的代码要改多少?把迁移成本拆成四个改动面:
- 模型标识字符串:在
base_url写法中,模型名通常是一个字符串参数,换供应商只需改配置;而专用包可能要求不同的模型命名格式,改动会扩散到调用点。 - 客户端初始化与凭据:
ChatOpenAI的写法里,客户端构造是统一的;专用包则是另一套构造逻辑,替换时所有创建客户端的代码都要变。 - 供应商专有参数:若你用到了专用包的路由偏好、故障转移策略等,这些参数无法在 OpenAI 兼容接口中表达,一旦迁移就是删除或重写。
- 响应体非标字段解析:如果你的下游代码依赖
reasoning_content这类专有字段,而它只能通过专用包获得,那么迁移到base_url写法后,这些解析逻辑会失效。
一个粗略的估算指标:专有参数出现次数 × 调用点数量。如果你的代码中“供应商专有参数”出现 0 次,调用点 50 处,那么用 base_url 写法的迁移成本极低;反之,若你在 50 处调用中都传入了路由偏好参数,则使用专用包的锁定程度已经很高。建议每个项目用这个公式自测一下锁定深度。
专有能力放在哪一层:兼容层 + 可插拔适配器的折中架构
担心锁定,又不愿放弃供应商路由、故障转移等能力?可采用“兼容层 + 可插拔适配器”的折中架构:
- 核心链路(LangGraph 节点、RAG 检索、Agent 主循环)统一走 OpenAI 兼容的 Chat Completions 接口,只通过配置读取
base_url、api_key、模型名。这部分代码与具体供应商无关,可移植性最高。 - 供应商专有能力(如 OpenRouter 的路由偏好、故障转移策略)封装在独立的 provider 适配器接口中,由工厂函数根据配置装配。适配器可以内部使用专用包,但对外暴露统一接口。
- LangGraph 节点逻辑只依赖统一的 adapter 接口,不直接引用
ChatOpenRouter等供应商专用类,也不在节点内出现供应商专有参数字面量(具体类名与参数名以官方文档为准)。
下面架构图示意了数据流与依赖方向:
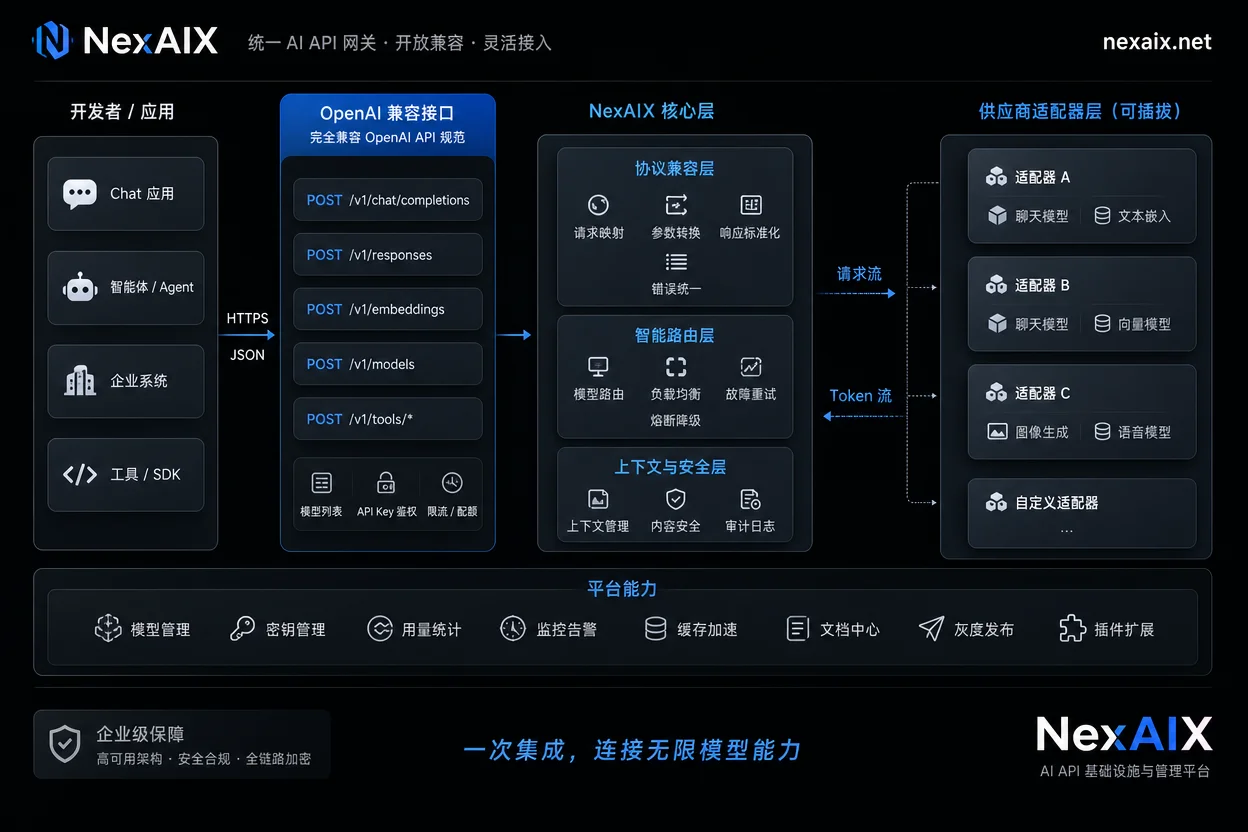
这种分层的好处是:核心链路保持可移植,专有能力被隔离在可替换的适配器中。当你需要切换供应商或评估新供应商时,只需新增一个适配器,无需改动核心节点。
别被误导:非标字段不解析 ≠ 流式或工具调用降级
社区中有种说法:用 ChatOpenAI + base_url 接入第三方聚合网关会导致流式传输静默降级。但该说法在 LangChain 官方文档中无对应表述,官方仅确认非标扩展字段不会被自动提取保留,而核心的 Chat Completions 流式输出与 Tool Calling 依然受标准 API 支持。也就是说,如果你的场景只依赖标准字段(如 choices、tool_calls 等),ChatOpenAI 的表现与专用包并无差别。
如果你不放心,可以用最小实验自行验证:同一 prompt、同一参数下,对比两种写法的首字延迟、chunk 数量、tool_calls 结构、finish_reason。记住,结论以你的实测为准,不要轻信无出处的传言。
LangChain 多模型 API 迁移清单:切换写法前要跑的 10 项回归
无论从哪个方向切换,切换前都应跑一遍这份回归清单,确保一致性:
- 流式增量与结束事件:测试流式输出,比较 chunk 内容与顺序,确认没有意外截断或重复。
- 工具调用参数 JSON 合法性与并行调用:确认
tool_calls中的参数能被 JSON 解析,且多个工具调用能正确触发。 - 多轮上下文与系统消息:验证多轮对话后的上下文保持,系统消息对回复的影响一致。
- 超时与重试配置:检查超时时间与重试次数是否按新写法正确传递。
- 429 退避与错误码映射:触发限流,观察错误码是否为标准 429,退避逻辑是否正常。
- token 计数与成本 delta:对比两种写法的 token 计数与估算成本,差异应在可接受范围。
- 非标字段是否被丢弃:如果需要
reasoning_content,确认专用包能否保留;若用兼容写法,确认下游不会因缺失而崩溃。 - 模型标识与返回体 model 字段一致性:请求中传入的模型名与返回体
model字段是否一致,这关系到日志与归因。 - 依赖版本锁定与破坏性变更监控:若引入专用包,锁定版本并关注其发布节奏,避免静默升级导致的不兼容。
- 回滚开关:确保新写法可配置化,出现问题时能一键切回原写法。
用同一套 OpenAI 兼容代码在多家统一AI API 上跑对照 eval
在上述架构下,保持兼容写法的最大收益是:可以用同一套链路代码在多家统一 AI API 之间做对照评测。做跨供应商对照时,必须固定这些变量:prompt 集、温度与最大输出、并发与重试策略、评分脚本;只变更 base_url 与模型名。这样,结果差异才能归因到模型本身。
以 NexAIX 为例,它提供 OpenAI Chat Completions 兼容接口(base_url 为 https://api.nexaix.net/v1),支持流式输出与函数/工具调用,因此你在 LangChain 中可以直接沿用 ChatOpenAI 标准写法,无需引入供应商专有包。更重要的是,它的满载返回标准 429 状态码与重试建议,不会静默切换为更廉价模型,且返回体 model 字段对应实际执行模型——这意味着你的评测结果可以准确归因到具体模型,成本核算也更可靠。具体可用模型与规格请以 NexAIX 模型页与文档为准。
如果你的供应商不满足这两点,请在 eval 中增加校验:逐条比对响应 model 字段是否与请求一致,记录 429 与重试次数,以便识别路由行为对结果的影响。
下面是根据路由需求、专有字段依赖、切流频率、维护成本四个维度给出的选型决策矩阵:
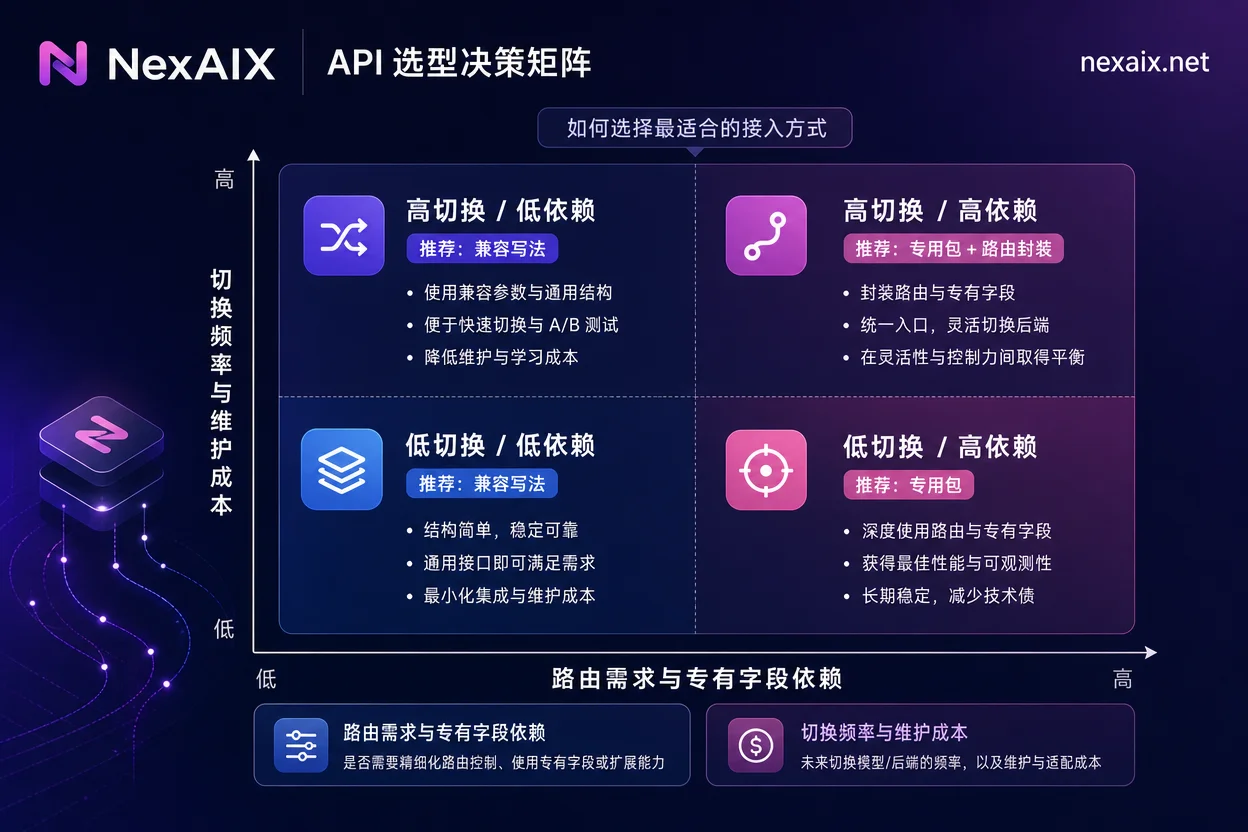
结论:什么场景值得上专用包,什么场景该坚持标准兼容写法
- 值得上专用包的场景:你明确需要跨供应商路由策略、节点级故障转移,或者必须保留
reasoning_content这类专有推理输出。 - 坚持兼容写法的场景:以基础对话、RAG、常规工具调用为主,且希望保留多供应商切流能力——此时
ChatOpenAI+base_url是低锁定、可移植的选择。 - 混合场景:按前文架构分层,核心链路保持兼容写法,供应商专有能力隔离在适配器里。
最后提醒:所有参数名、版本号与安装命令以官方文档为准,本文的判定标准基于 2026 年 7 月 29 日的官方文档口径。建议先用上述回归清单在你现有链路上跑一遍最小对照实验,再决策是否引入专用包。如果你需要在多家统一 AI API 间做同代码对照,可以到 NexAIX 文档与模型页核对当前可用模型与接口规格,用测试额度验证。



评论(0)