 NexAIX-官方博客
Agent 为什么对底层 API 要求更高
普通对话接口调一次模型就结束,Agent 不同:它把用户的一个指令拆成多轮「思考 → 调用工具 → 拿到结果 → 继续思考」的循环,直到任务完成。这个过程依赖底层模型的原生工具调用(Native Tool Calling)能力。模型本身不执行代码,而是根据你预设的 JSON Schema 输出结构化的 tool_calls 参数,客户端拿到后执行对应函数(比如查数据库、调第三方 API),再把执行结果以带 tool_call_id 的 tool 消息回传给模型,模型看到结果后决定下一步动作。
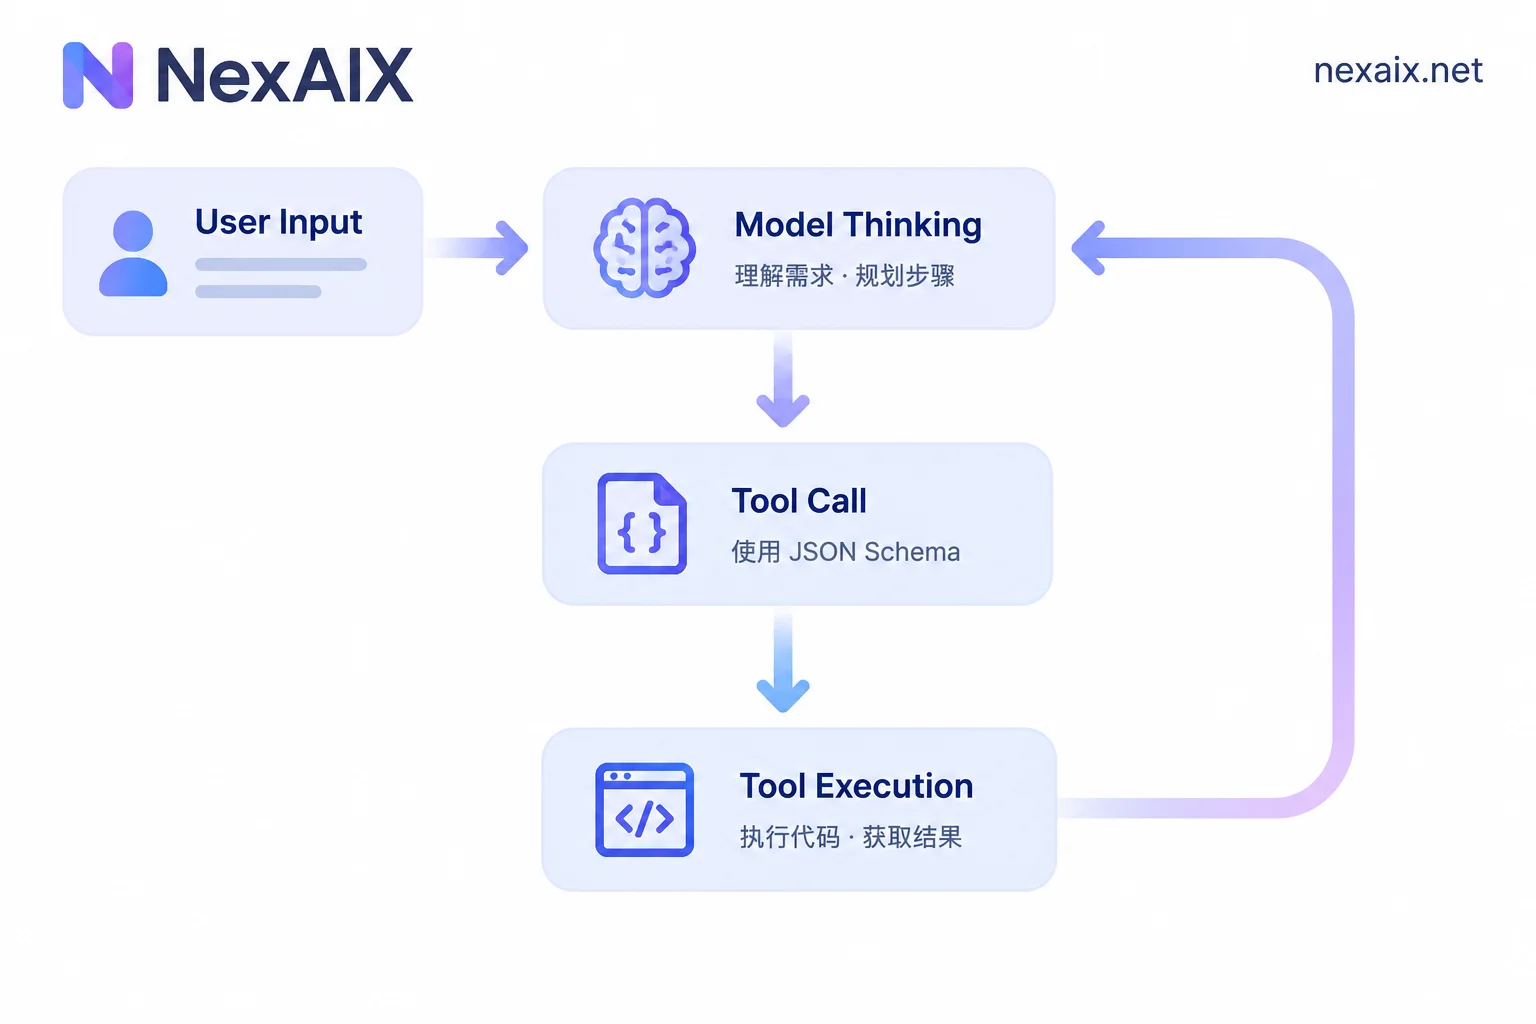
这个机制对 API 端点提出四个验证点:
- 工具调用参数的透传:端点必须完整支持
tools、tool_choice和strict: true,不能把这些参数吃掉或返回格式错乱的响应 - 长上下文的完整保留:每轮思考、工具入参、工具返回的大段文本都会累积在请求历史里,几轮下来就可能消耗掉几万 token,端点若隐式截断会让 Agent 丢失前面的任务记忆
- 明确的限流配额:Agent 完成单个用户指令可能连续发起十几次推理请求,端点的 RPM/TPM 限制必须公开且可预测,否则你会在生产环境遇到突发的 429 错误
- 工具返回后的状态追踪:多轮对话中每个
tool_call_id必须正确对应,端点若篡改或丢失 ID 会导致 Agent 死循环
如果你用的是 LangChain、CrewAI 这类框架,它们已经帮你封装了 ReAct 循环或多 Agent 协作的逻辑,你只需要提供一个可靠的底层模型 API。
在框架里改一行配置就能接入
主流 Agent 框架都兼容 OpenAI 的接口协议,对接第三方 API 只需修改 base_url 和 api_key,不需要换 SDK 或改业务代码。
LangChain 示例(Python):
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    base_url="https://api.nexaix.net/v1",  # 只改这一行
    api_key="your-api-key",
    model="gpt-4o"
)
框架会自动在 base_url 后追加 /chat/completions,你不用写完整路径。如果你的项目里用环境变量管理配置,改两个环境变量就行:
export OPENAI_BASE_URL="https://api.nexaix.net/v1"
export OPENAI_API_KEY="your-api-key"
CrewAI 示例:
from crewai import Agent, Task, Crew
import os

os.environ["OPENAI_BASE_URL"] = "https://api.nexaix.net/v1"
os.environ["OPENAI_API_KEY"] = "your-api-key"

researcher = Agent(
    role="Research Analyst",
    goal="Find and analyze data",
    llm="gpt-4o"  # 直接指定模型名
)
CrewAI 会读取环境变量里的 OPENAI_BASE_URL,你不用在每个 Agent 初始化时重复传参。
四个验证点的具体检查方法
1. 工具调用参数是否被完整透传
发一个带 tools 的测试请求,检查返回的 tool_calls 格式:
response = llm.invoke(
    messages=[{"role": "user", "content": "北京今天天气如何?"}],
    tools=[{
        "type": "function",
        "function": {
            "name": "get_weather",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {"type": "string"}
                },
                "required": ["location"]
            },
            "strict": True
        }
    }]
)
正常响应应该包含 response.tool_calls,里面有 id、function.name 和 function.arguments。如果端点不支持 strict: True,或者返回的 arguments 不是合法 JSON,说明这个端点对工具调用的支持不完整。
生产环境里建议开启 Strict Mode,它会强制模型输出严格符合 Schema 的参数,避免后续解析出错。
2. 长上下文是否会被隐式截断
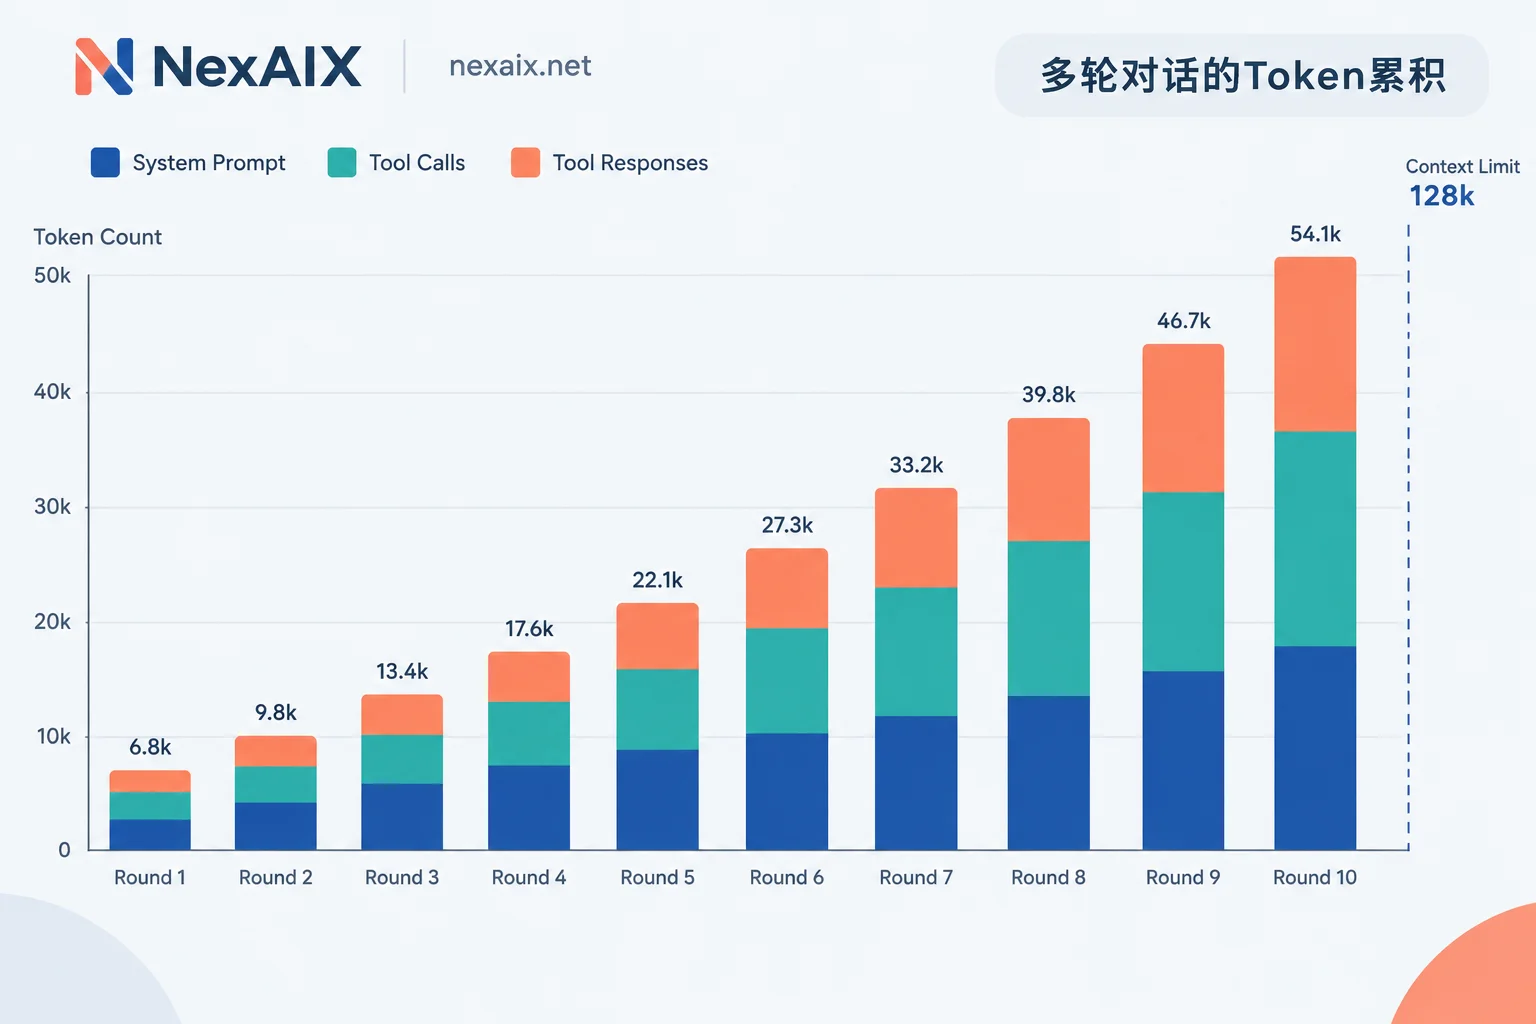
Agent 在多轮任务中会快速累积 token。假设每轮思考 + 工具调用 + 工具返回共消耗 5000 token,跑十轮就是 5 万 token。如果模型声称支持 128k 上下文,但端点实际只保留最近 32k,Agent 就会丢失前面的任务记忆,出现重复调用同一个工具或忘记用户初始指令的情况。
排查方法:
- 看返回的
usage字段:每次请求后检查prompt_tokens,它应该逐轮递增。如果某一轮突然减少,说明被截断了 - 在对话历史里埋标记:在前几轮的
system或user消息里加一段独特文本(比如[CONTEXT_MARKER_12345]),跑到第十轮时让 Agent 复述这段内容,看它能不能找到
如果你用的端点没有公开上下文窗口的实际保留策略,或者宣称支持 200k 但实测只能稳定处理 32k,那这个端点不适合跑长任务的 Agent。
3. 限流配额是否明确且足够
Agent 单次任务可能连续发起 10-20 次推理请求,每次请求间隔可能只有几百毫秒。如果端点的 RPM(每分钟请求数)或 TPM(每分钟 token 数)限制不透明,或者限流后返回的 429 响应里没有 retry-after 头,你的 Agent 就会频繁卡住。
检查清单:
- 端点是否公开每个模型的 RPM/TPM 配额
- 限流响应是否返回标准的
retry-after或x-ratelimit-reset-requests头 - 是否支持按 API Key 隔离配额(多个项目共用一个端点时必需)
如果你的 Agent 任务平均需要 15 轮推理,每轮消耗 8000 token,那单个任务就是 12 万 token。假设端点的 TPM 是 40 万,理论上每分钟只能跑 3 个这样的任务。如果你的应用有多个用户并发触发 Agent,这个配额会迅速打满。
生产环境里建议配合指数退避重试,但前提是端点的限流响应要规范。
4. 工具返回后的 ID 对应是否正确
这个问题通常出现在端点对 OpenAI 协议的实现不完整。模型返回的 tool_calls 里每个调用都有一个唯一的 id(格式类似 call_abc123),你执行完工具后必须在回传的 tool 消息里带上对应的 tool_call_id。如果端点在转发过程中篡改或丢失这个 ID,模型就无法匹配结果,会一直重复调用同一个工具。
测试方法:打印每轮请求和响应的完整 JSON,确认 tool_call_id 在往返过程中保持一致。
选择底层 API 时看什么
明确了验证点后,选择 Agent 的底层 API 就有了具体依据。除了模型本身的能力(推理质量、上下文长度),重点看三个工程属性:
供给方式的透明度:端点是直连模型厂商的官方 API,还是二次封装的代理层?如果是代理,它是用自有算力部署开源模型,还是转发闭源厂商的流量?这决定了你能否追溯到真实的模型版本和配置。像 NexAIX 这类中转站,每个模型页会标明是「开源权重自有算力部署」还是「闭源模型官方授权渠道」,你能清楚知道请求最终到哪一层。
是否承诺不降配:有些端点为了降低成本会偷偷换小模型、降精度或砍上下文窗口。验证方法在这篇文章里有详细说明,核心是对比官方接口的 model 字段、上下文实际保留长度和推理结果的一致性。如果端点公开承诺「不换小模型、不降精度、不砍上下文」且提供验证方法,可信度会高很多。
配额与限流的可见性:你需要知道每个模型的 RPM/TPM 是多少,以及是否按 API Key 隔离。按 Key 隔离意味着你的开发环境、测试环境、生产环境可以用不同的 Key,各自的配额和用量互不影响。如果端点只提供账号级别的总配额,多个项目会互相抢占,Agent 任务容易在高峰期被限流。
具体接入时,你可以先在 NexAIX 的模型清单里确认想用的模型属于哪种供给方式,再按接入文档里的示例改 base_url 和 api_key。注册后会送测试额度,可以先跑几轮 Agent 任务验证上面四个点。
排查 Agent 卡住或循环的常见原因
如果 Agent 在生产环境出现异常,按优先级检查:
- 看最近一次请求的
usage.prompt_tokens:如果接近模型的上下文上限,说明累积太多历史消息,需要在框架层做消息压缩或窗口滑动 - 检查工具返回的内容体积:有些工具(比如搜索 API)返回几千行 JSON,全部塞进对话历史会迅速耗尽上下文。生产实践是在工具层做截断,只保留关键字段
- 确认 429 响应的频率:如果每分钟出现多次限流,要么提高端点的 TPM 配额,要么在应用层加请求队列
- 验证
tool_call_id的对应关系:在框架的日志里打印每轮的tool_calls和回传的tool消息,确认 ID 匹配
对于多轮长任务,建议结合流式输出降低单次请求的等待时间,并在超时后用重试机制兜底。
小结
Agent 的稳定性直接取决于底层 API 对工具调用、长上下文和限流的支持质量。接入时改一行 base_url 只是第一步,关键是在测试阶段验证四个点:工具参数透传、上下文完整保留、限流配额公开、工具 ID 正确对应。选择端点时优先看供给方式是否透明、是否承诺不降配、配额是否按 Key 隔离,这些属性比单纯的价格或模型数量更影响生产可用性。



评论(0)