 NexAIX-官方博客
接入 API 中转站前,开发者与技术负责人必须确认三件事:供给来源是否透明可验证、客户端迁移是否能保持代码兼容、工程层面如何防范模型被偷换降配与排查限流截断。这三项直接决定生产环境的数据安全、成本核算与服务稳定性。
OpenAI 兼容端点的迁移配置
接入 OpenAI 兼容规范的中转站只需替换客户端的基础配置,保留原有请求与响应结构。核心配置项为三个:API 密钥、模型标识(Model ID)与 API Base URL。
最常见的配置错误是 Base URL 遗漏末尾版本路径。例如配置成 https://api.example.com 而非 https://api.example.com/v1,导致 SDK 拼装后的请求路径失效或回退到默认官方端点。Python SDK 示例:
from openai import OpenAI

client = OpenAI(
    api_key="你的密钥",
    base_url="https://api.nexaix.net/v1"  # 必须包含 /v1
)

response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "测试"}]
)
Node.js 与其他语言的 SDK 配置逻辑一致,只改 baseURL 与 apiKey 两项。中转代理在客户端与上游模型之间建立网络中转,处理层包括身份鉴权、速率限制、模型路由、缓存检查与失败重试,其网络延迟开销通常可控制在毫秒级(通常低于 50ms),下游的代码逻辑与响应解析流程保持一致。
供给来源透明度与数据安全风险
非正规或未经授权的灰色 API 中转存在两类严重风险:数据窃取与模型降配。
中转代理对请求提示词、思维链与生成输出具备完全明文可见性。部分中转站可能将这些数据用于窃取商业秘密或微调训练第三方模型。这在处理企业内部文档、客户数据、业务逻辑时构成严重的合规风险。
部分低质代理为削减成本,会在后台动态将高价值商业模型静默降配(Downgrade/Substitution)或路由到廉价开源小模型。开发者按 GPT-4 的价格付费,实际调用的可能是降精度版本或完全不同的模型。这种掺水行为会直接影响生成质量、业务决策准确性与用户体验。
正规中转站应明确标注每个模型的供给方式。以 NexAIX 模型清单 为例,开源权重模型部署在自有算力集群,闭源模型走厂商官方授权渠道,每个模型页会标明属于哪一种。这种透明度让开发者能够评估数据流向与质量保障。同时需确认中转站是否承诺不记录对话内容、请求结束即释放数据。
基于 Logprobs 的模型降配检测
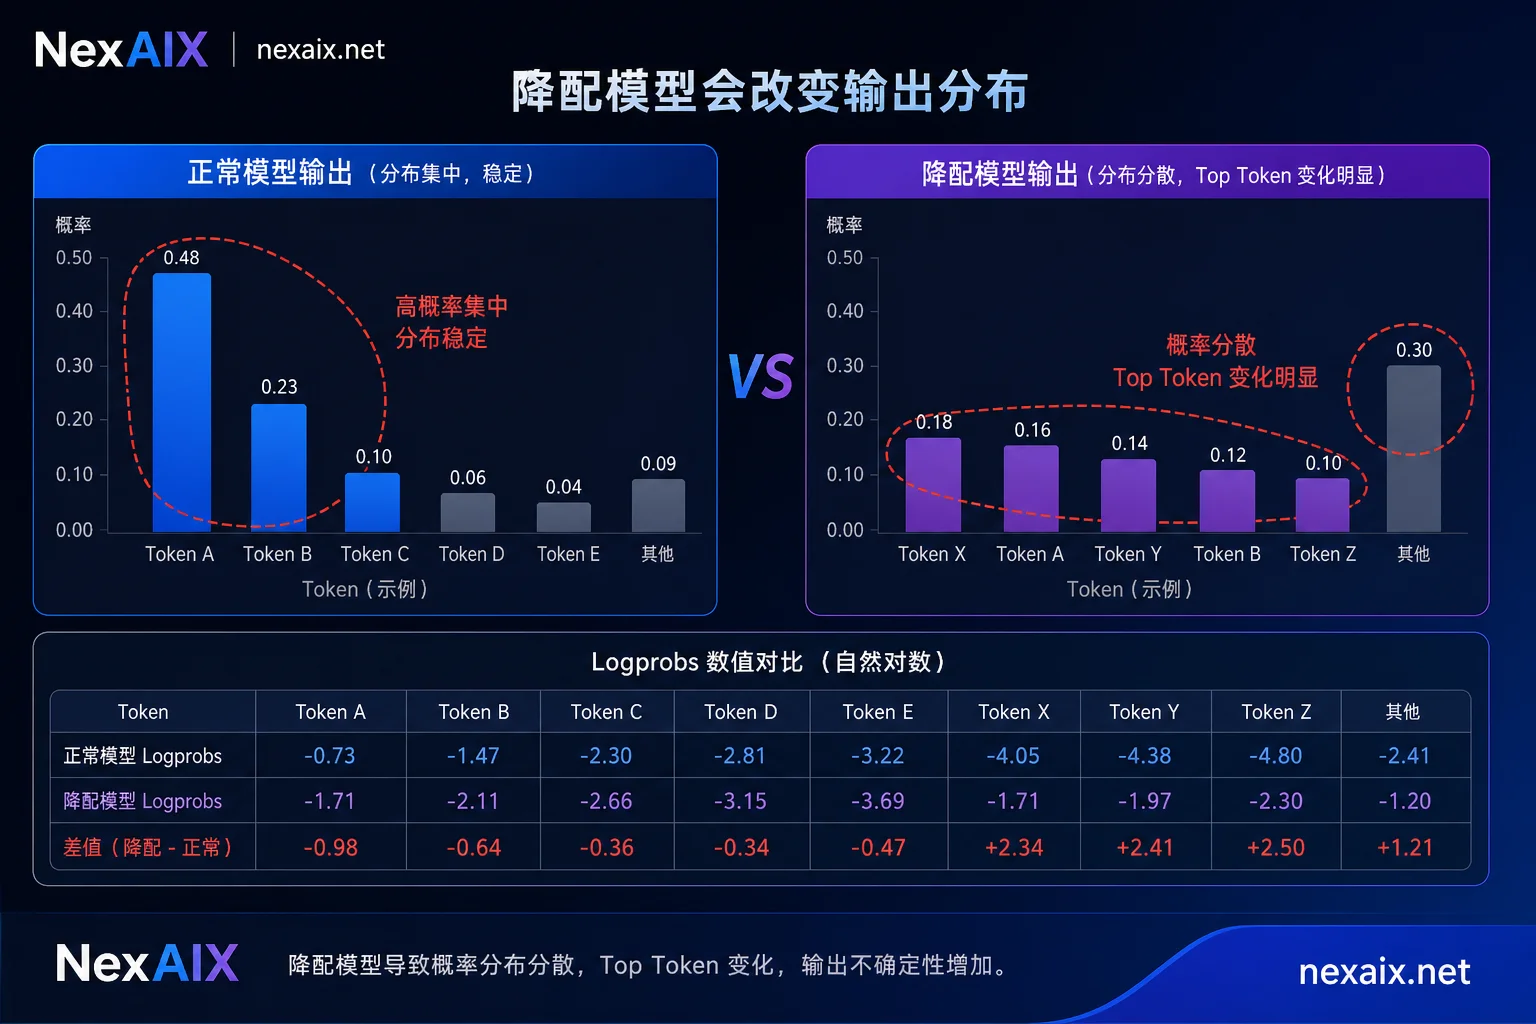
学术界与工程界提出了基于 Token 对数概率(Logprobs)的统计监测方案来验证模型是否被偷换或降配。由于不同规模或微调版本的模型预测分布差异显著,通过请求单 Token 的对数概率并进行统计学检验,能以极低算力成本高灵敏度检测出底层模型的细微变动与降配。
具体方法是在请求时启用 logprobs 参数,记录模型对特定输入的 Token 概率分布。相同输入在相同模型上应产生稳定的概率分布,如果分布突然变化,说明底层模型可能被替换。这个方法的优势在于不需要标注数据集或复杂的性能基准测试,只需对比历史概率记录。
在 OpenAI 兼容端点的请求中配置:
response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": "测试句子"}],
    logprobs=True,
    top_logprobs=5
)

# 记录并对比 response.choices[0].logprobs
将特定测试句的概率分布作为基线,定期发送相同请求对比概率变化。如果 Top-K Token 的概率分布出现显著偏移(例如标准差超过阈值),需要进一步验证是否模型版本变更或被降配。详细的验证方法可参考稳定 AI API 怎么选?版本标识与路由回退的核验方法与AI API中转站锁定模型关闭自动路由的请求配置与验证。
429 限流错误的分类处理
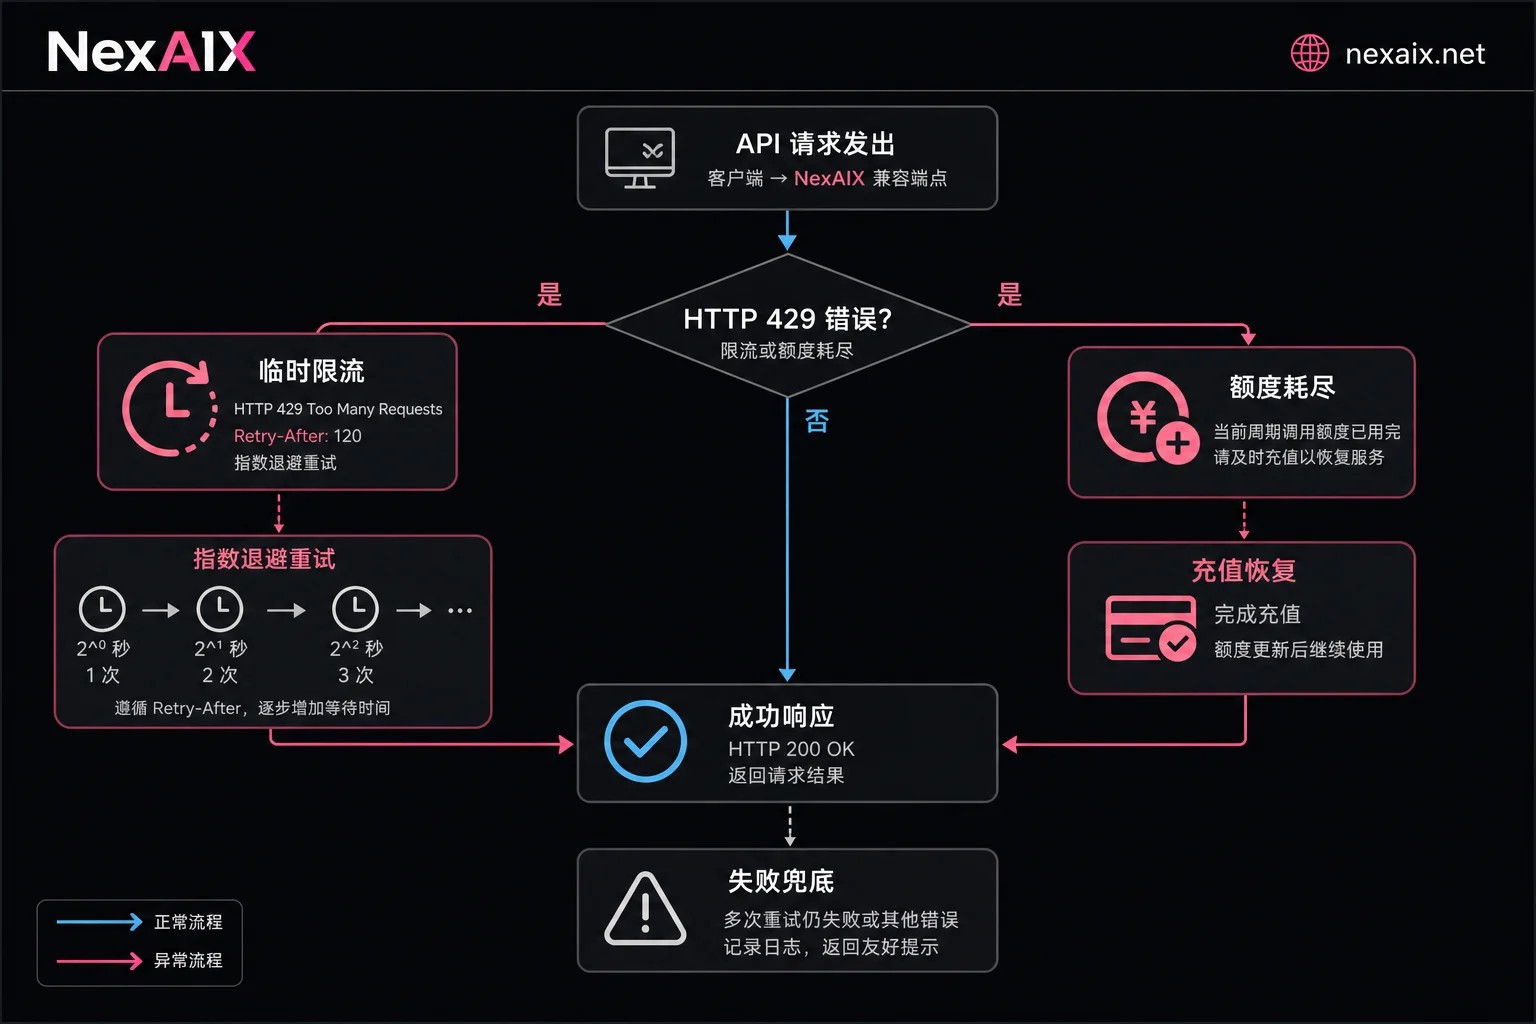
当调用遭遇 HTTP 429 错误时,需要区分临时突发速率限制(Rate limit reached/slow_down)与额度耗尽(credit_balance_exhausted/insufficient_quota)。
对于临时限流,官方 SDK 与网关通常支持读取响应中的 Retry-After 标头进行指数退避重试。这个标头给出了建议的等待秒数,直接循环重试会加剧每分钟限制耗尽并延长封禁。正确的处理方式:
import time
from openai import RateLimitError

try:
    response = client.chat.completions.create(...)
except RateLimitError as e:
    retry_after = e.response.headers.get('Retry-After')
    if retry_after:
        time.sleep(int(retry_after))
    else:
        # 指数退避:第一次等 1 秒,第二次等 2 秒,第三次等 4 秒
        time.sleep(2 ** retry_count)
如果错误信息明确指向额度耗尽(insufficient_quota),需要充值或检查账户配额,重试无效。正规中转站应公开配额与限速规则,例如按 API Key 隔离配额、明确每分钟请求数(RPM)与每天 Token 数(TPD)上限。更详细的重试策略见指数退避重试要等多久合适?先看 429 带不带 retry-after。
上下文长度超限的处理
与限流不同,context_length_exceeded(HTTP 400)属于单次请求大小超限而非频次超限。该错误发生在生成之前,不会消耗 Token 费用,指数退避无法解决该错误。
必须在客户端或中转预处理阶段通过以下方式处理:
- 提示词压缩:删除冗余上下文、使用摘要替代完整历史对话
- 上下文截断:保留最近 N 轮对话,丢弃过早的轮次
- 切换更大上下文窗口的模型:例如从 8K 上下文的模型切换到 128K 或 1M 上下文的版本
在请求前预估 Token 数量可以避免该错误。Python 使用 tiktoken 库:
import tiktoken

encoding = tiktoken.encoding_for_model("gpt-4o")
token_count = len(encoding.encode(prompt_text))

if token_count > model_max_tokens:
    # 执行截断或压缩
    prompt_text = compress_or_truncate(prompt_text)
不同模型的上下文窗口规格差异较大,需要在中转站的模型清单中确认具体限制。
选型建议与接入入口
选择 API 中转站时,优先核查供给方式标注、数据处理承诺与配额限速公开程度。如果中转站能标明每个模型是自有算力部署还是官方授权渠道,并承诺不记录对话、不降配、按 Key 隔离配额,可以降低数据泄露与质量风险。
接入时只需改一行 base_url,保持 OpenAI SDK 的代码结构不变。接入后通过 Logprobs 定期抽检模型稳定性,遇到 429 先读 Retry-After 再决定重试策略,遇到上下文超限则在客户端预处理或切换模型。
如果需要查看可用模型与供给方式,访问 NexAIX 模型清单;接入文档与获取测试额度见官网导航的「文档」与「获取 API Key」。



评论(0)