 NexAIX-官方博客
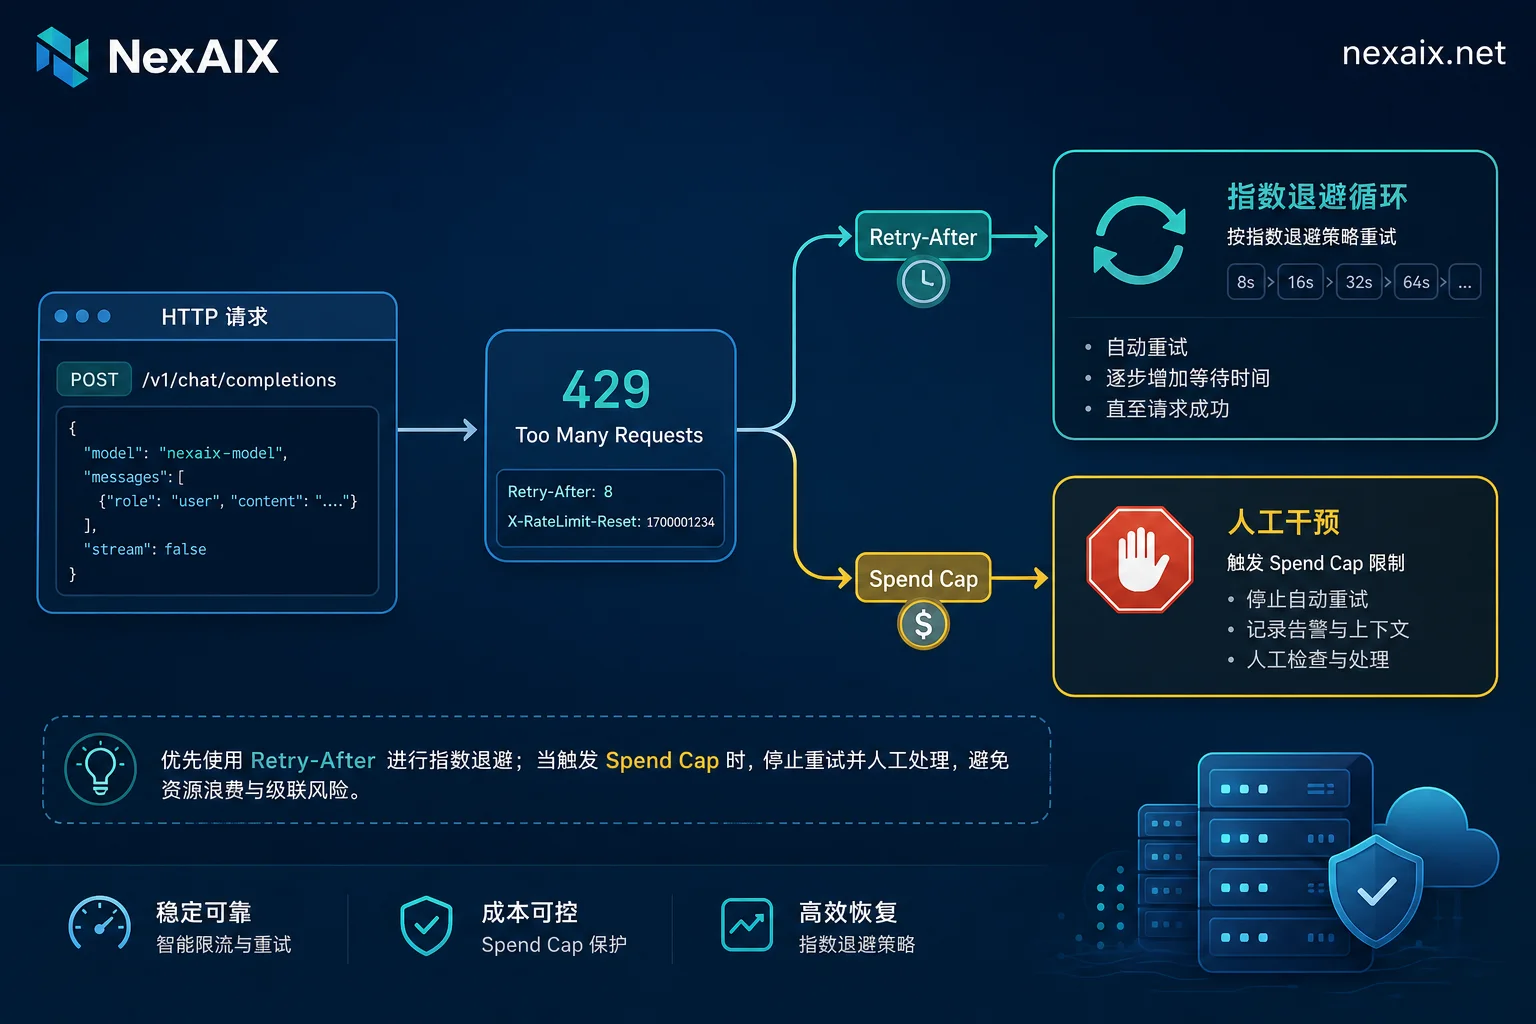
遇到429时,指数退避重试要等多久合适取决于响应元数据:若含 retry-after 标头则以该秒数为准;若无则需判断是否为支出上限导致的硬拒绝;仅当两者皆非时才启用本地退避参数。这一判定顺序直接决定了重试的有效性。
429的两类分支与应对策略
根据 Anthropic 官方接口规范(https://docs.anthropic.com/en/api/errors),rate_limit_error 分为速率超限与支出上限两类,二者处理逻辑截然不同。
| 429 错误类型 | 触发原因 | 关键响应特征 | 客户端应对策略 |
|---|---|---|---|
| 速率/并发超限 | 短时间请求过多或并发连接数超过阈值 | 响应头包含 Retry-After 字段,单位为秒 | 必须重试。严格遵循 Retry-After 指示的时间等待后重试 |
| 账户支出上限 | 账户月度消费达到预设限额 (Spend Cap) | 响应头无 Retry-After 字段,Body 含特定关键词 | 停止重试。重试只会消耗资源且必然失败,需人工充值或调整配额 |
许多开发者困惑于为什么一直重试还是429,往往是因为代码逻辑未区分这两种情况。当账户触发 Spend Limit 时,服务器明确拒绝任何新的计算任务,此时无论退避算法多么精妙,只要余额未补充,请求永远会被拦截。
速率超限:retry-after决定等待时长
确认错误类型为速率超限时,客户端应直接读取 Retry-After 标头。该数值由服务端根据当前负载动态计算得出,代表了资源释放的预期时间窗口。
如果忽略此标头而强行使用本地配置的固定退避间隔,可能导致两个极端后果:等待过短引发“惊群效应”,加剧服务端拥堵;等待过长则导致业务链路超时断裂。关于retry-after 标头没有怎么办的问题,若响应为 429 但缺失该标头,且排除支出上限因素,可视为服务端未提供精确预估。此时应回退至标准的指数退避算法,从较小的基数开始试探性等待。
支出上限:为何重试无效
针对账户级别的硬性限制,Fireworks AI 等服务商通过 Tier 分级管理实施控制(https://fireworks.ai/account/rate-limits)。这类 429 错误本质上是权限问题而非容量问题。
判定方法主要依赖响应体中的文本特征。由于各服务商字段命名不一致,应以自己所用平台的错误码文档为准,但跨厂商更稳定的首要判据是“是否携带 retry-after”。一旦确认为支出上限,应立即熔断当前的重试队列,并向监控系统发送告警。在此场景下讨论指数退避最大重试次数设几次毫无意义,因为唯一的解决方案是增加配额,而非优化算法。
退避参数取值依据
回到速率超限的场景,假设服务端未提供 Retry-After 或我们需要设计兜底策略,如何确定具体的退避参数?指数退避重试要等多久合适,需结合以下三个工程维度进行权衡(注:以下为工程经验取值,非厂商强制规范):
- 首包耗时量级(TTFT):退避基数不应小于模型的典型首包延迟。若 TTFT 为 2 秒,设置 1 秒的初始退避毫无意义,因为即使资源空闲,请求也需要排队处理。基数应略大于 P50 的 TTFT。
- 任务可丢弃性:对于实时聊天机器人,用户无法忍受超过 3-5 秒的总延迟,最大重试次数应设为 1-2 次,快速失败优于无限等待。而对于后台批量数据处理,任务允许延迟完成,可将最大重试次数放宽至 3-5 次。
- 并发窗口宽度:在高并发微服务架构中,多个实例同时收到 429 后若同步退避,会在同一时刻发起二次攻击。此时引入 Jitter(抖动)至关重要。
| 场景 | 初始基数 | 退避倍数 | 最大重试 | 最坏等待估算 |
|---|---|---|---|---|
| 交互式应用 | 1s - 2s | 2.0x | 1 - 2 次 | < 6s (含请求耗时) |
| 异步批处理 | 2s - 5s | 1.5x - 2.0x | 3 - 4 次 | < 30s (含请求耗时) |
关于重试加jitter有必要吗,答案是肯定的。在分布式系统中,Jitter 能将原本尖锐的重试峰值打散成平缓的长尾分布,显著提升整体系统的吞吐量恢复速度。
重试与超时预算
重试策略必须服从于全链路的超时预算。以最坏情况估算:假设初始退避 2 秒,倍数 2,最大重试 3 次。等待总时长 = 2 + 4 + 8 = 14 秒。加上每次请求本身的网络往返和处理时间(此处假设平均 2 秒为示例值,实际应替换为自己链路实测的 P99 单次耗时再重算),总耗时可能达到 14 + (3 × 2) = 20 秒。这还未计入首次请求前的准备时间。若业务要求响应必须在 15 秒内完成,则该配置显然不合理,需减少最大重试次数或降低初始基数。
RPM与TPM限制差异
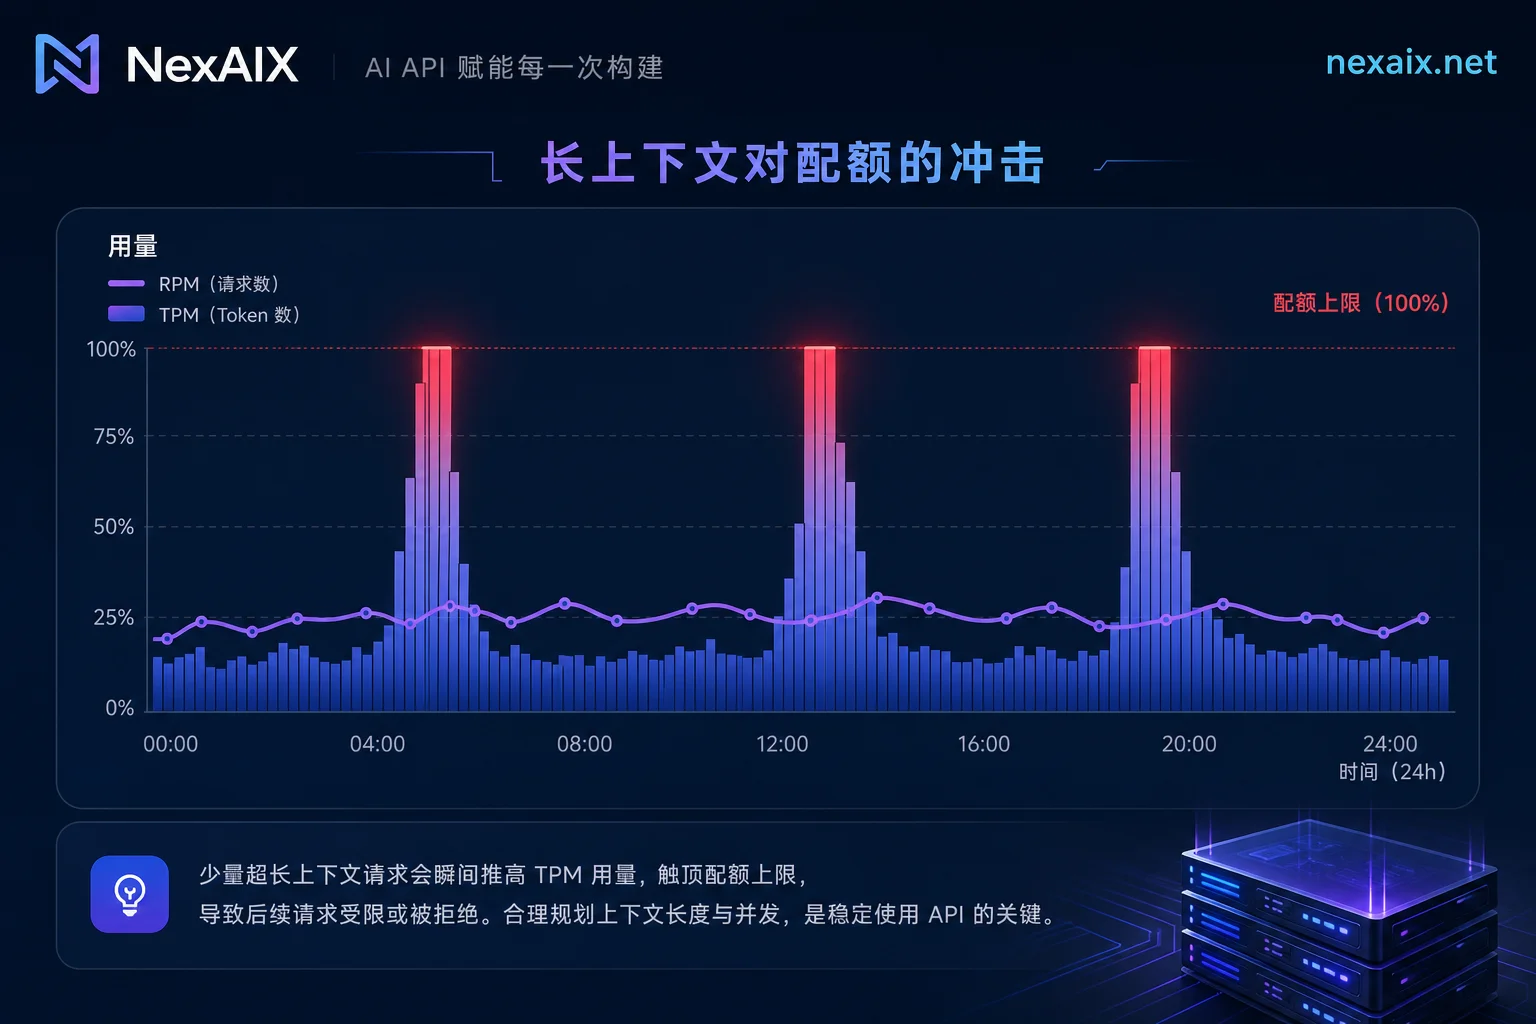
理解RPM和TPM限制有什么区别有助于精细化控制重试频率。RPM(Requests Per Minute)限制的是请求频次,TPM(Tokens Per Minute)限制的是 token 吞吐总量。
- 短请求场景:容易先触及 RPM 限制。此时单个请求消耗的 token 很少,但数量巨大。重试时应重点关注请求间的间隔时间。
- 长上下文场景:容易先耗尽 TPM 限制。一个携带 100k tokens 的请求可能瞬间吃光分钟级配额。此类场景下,简单的指数退避可能不够,建议采用令牌桶算法在客户端进行预排队,按 token 预算分批发送,而非依赖服务端的 429 反馈。
服务端行为约定
不同服务商在处理过载时的行为存在显著差异。部分中转平台可能在模型满载时静默切换至更便宜的备用模型,而不返回明确的 429 错误,这会导致客户端的退避逻辑完全失效,甚至产生计费争议。
在选型时,建议核查服务商是否承诺“透明化路由”。例如,NexAIX 在其公开文档中承诺,当上游模型满载时,会返回标准的 429 状态码及 Retry-After 标头,而不进行静默降级。这种确定性行为使得客户端能够依赖响应信号做出正确的退避决策,保障生产环境的稳定性。对于对输出一致性要求极高的 Agent 应用,稳定AI API 所强调的路由透明性是重要的考量指标。
此外,排查非 429 类的错误时,建立完整的错误码映射表至关重要,尤其是针对常见的输入格式错误,可参考 Claude API 400 的相关分析。
常见问题
429无retry-after该放弃吗?
不一定。首先需检查响应体是否包含支出上限相关语义,若是则确认为硬限制,必须停止重试并联系管理员。若非支出上限,可能是服务端未实现该标头,此时应启用保守的指数退避策略(如初始等待 1-2 秒,最多重试 2 次),并密切监控后续请求成功率。
最大重试次数设多少安全?
这取决于业务类型。对于实时交互类应用(如 Chatbot),建议设置为 1-2 次,以避免用户感知到明显卡顿;对于后台异步任务(如数据清洗、批量生成),可设置为 3-5 次。关键在于确保所有重试周期的总耗时不超过上游网关或负载均衡器设定的全局超时阈值(通常为 30-60 秒)。
频繁429且退避无效咋办?
可能的原因有三:一是触发了账户级的月度支出上限(Spend Cap),需充值解决;二是并发请求过于集中,缺乏 Jitter(抖动)导致同步重试风暴;三是 TPM(Token 每分钟限制)被长上下文请求迅速耗尽,需优化 Prompt 长度或采用分批排队策略,单纯调整时间间隔无效。
RPM和TPM报错有何不同?
RPM 限制报错通常发生在高频短请求场景,优化重点是合并请求或使用缓存减少调用次数;TPM 限制报错多见于长文本处理,优化重点在于压缩 Prompt、利用前缀缓存(Prompt Caching)或在客户端实现基于 Token 数量的滑动窗口排队,而非仅仅关注请求频率。
生产环境要加Jitter吗?
非常有必要。在没有 Jitter 的情况下,多个客户端实例可能在相同的退避时间点同时发起重试,形成“惊群效应”,再次压垮服务端。添加 ±20% 到 ±50% 的随机抖动可以平滑重试流量的峰值,显著提高系统在限流后的恢复速度和整体吞吐量。
最后,建议将 retry-after 判定和支出上限排查逻辑固化到你的错误处理中间件中。不要照抄框架的默认值,而是用实际的首包延迟(TTFT)和全链路超时预算倒推最适合你业务的退避参数。如需在不消耗生产配额的情况下验证复杂的重试逻辑,NexAIX 提供的测试额度和详细文档可作为可靠的沙箱环境。



评论(0)