GPT-5.6 API 怎么接:Sol、Terra、Luna 选型与推理参数配置

GPT-5.6 分 Sol、Terra、Luna 三个型号,全系支持 105 万 tokens 上下文与最高 12.8 万输出。接入只需改 base_url,通过 reasoning.effort 控制推理深度,用长上下文测试验证渠道是否降配。

Agent API 怎么接:从框架配置到工具调用的四个验证点

AI Agent 依赖底层模型的原生工具调用能力完成多轮推理,接入 OpenAI 兼容 API 时需要验证四个关键点:端点对 tools 参数的透传支持、长上下文的完整保留、明确的限流配额,以及工具返回后的状态追踪。本文从 LangChain 与 CrewAI 的实际配置出发,说明如何选择可靠的底层 API 并排查常见的截断与限流问题。
流式输出API怎么接:SSE 解析、Token 统计与代理卡顿排查

从一条能跑通的 curl 开始,讲清流式输出 API 的 SSE 报文结构、解析时容易漏掉的空 choices 与跨包问题、如何用 stream_options 拿到 Token 用量、反向代理缓冲导致「一次性吐出」的排查顺序,以及客户端断连时怎样中止上游请求。

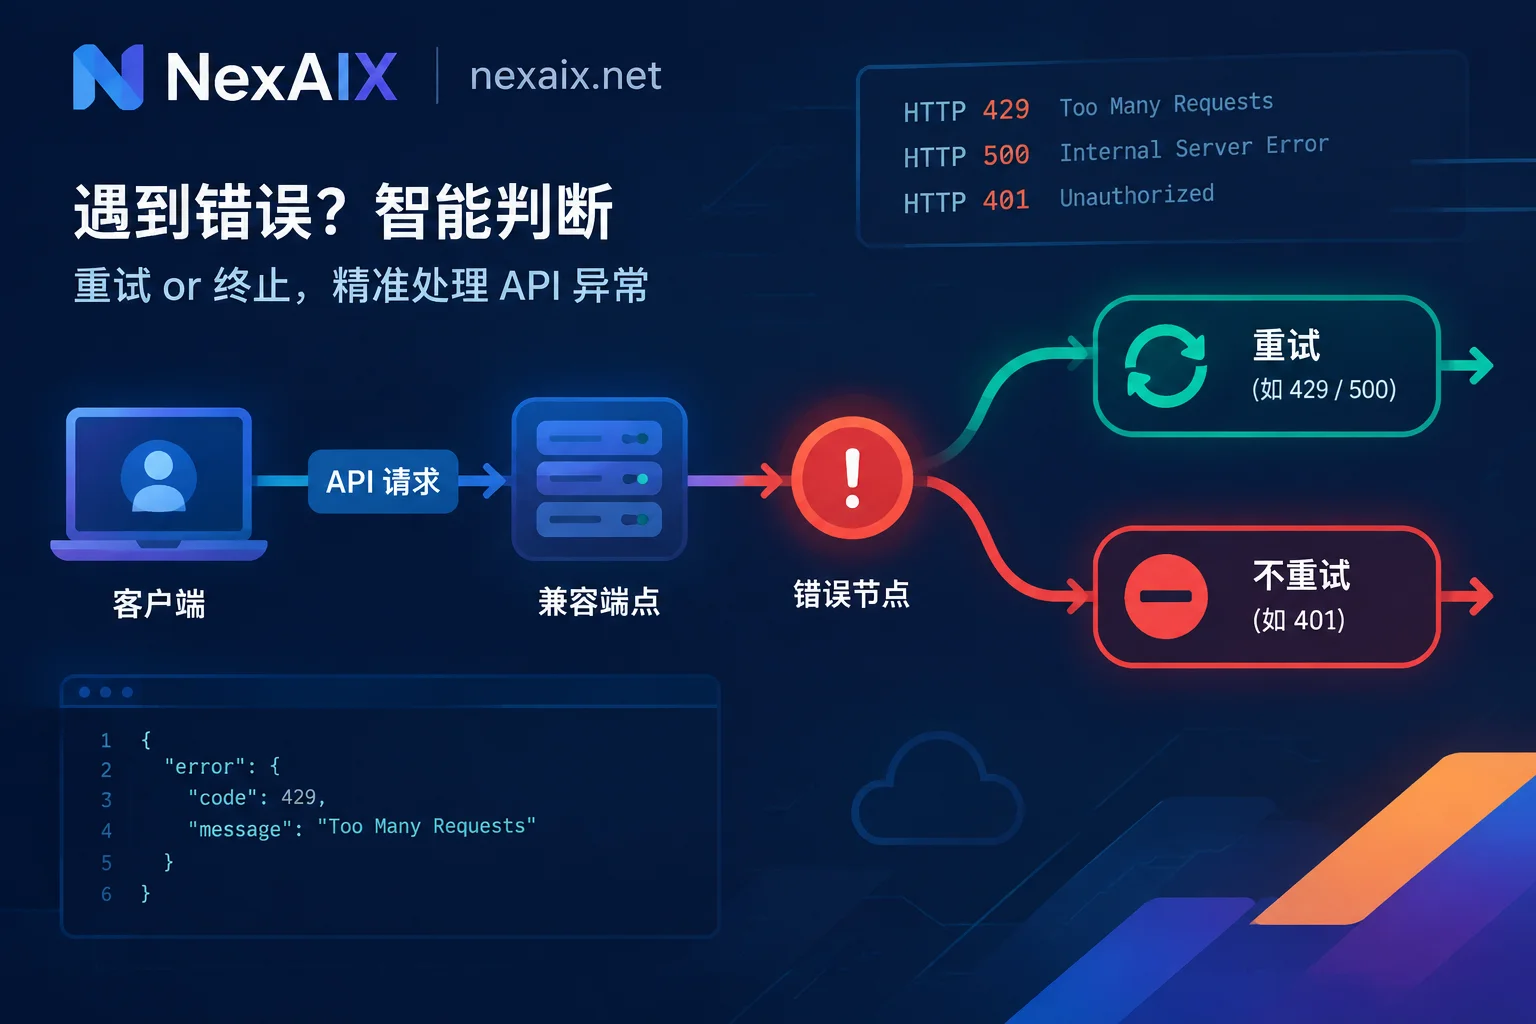
AI API 重试怎么设计:哪些错该重试、退避等多久、流式中断怎么办

把大模型调用的错误分成「可重试的瞬态故障」和「重试也没用的确定性故障」,给出 Retry-After 优先、带抖动指数退避的参数取法,以及流式中断、SDK 内置重试嵌套、工具调用副作用这三个容易踩坑的场景的处理方式。

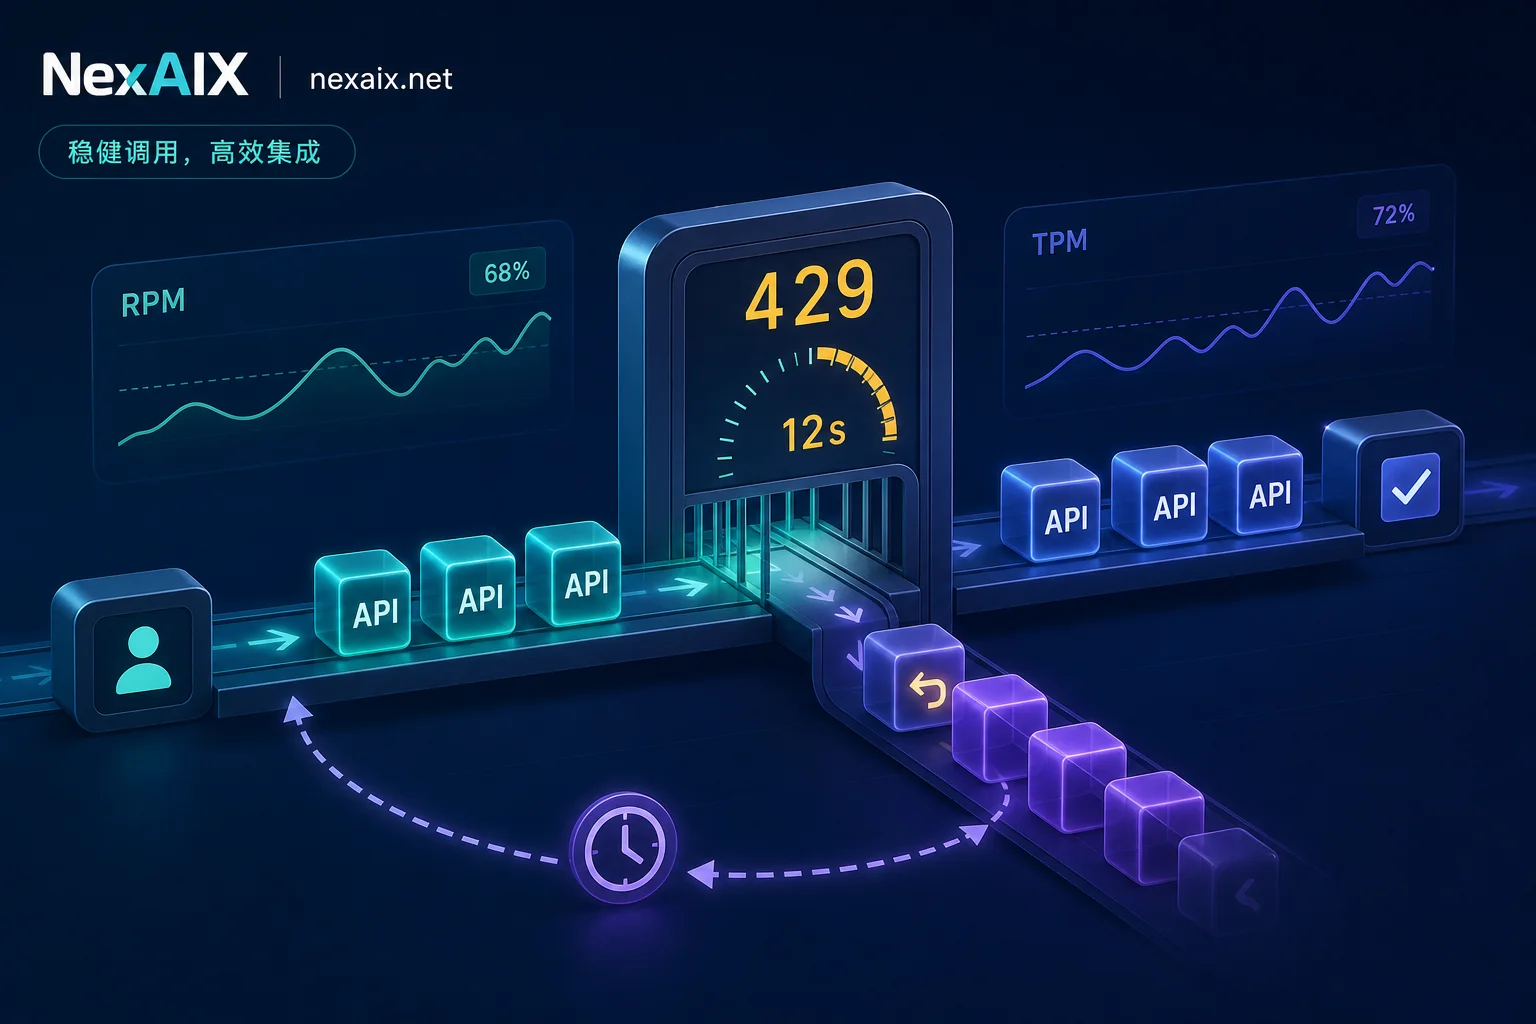
AI API 限流怎么处理?从 429 标头到退避重试与流量隔离

调用大模型 API 撞上 429 时,先看响应标头和 error code 再决定重试策略:带 Retry-After 就按它等,配额耗尽必须立刻停。文章给出限流的四个度量维度、六个余量标头的用法、带抖动的指数退避骨架,以及用令牌桶、max_tokens 收紧和按 Key 隔离在架构层规避限流的做法。