NexAIX-官方博客
Agent API 怎么接:从框架配置到工具调用的四个验证点
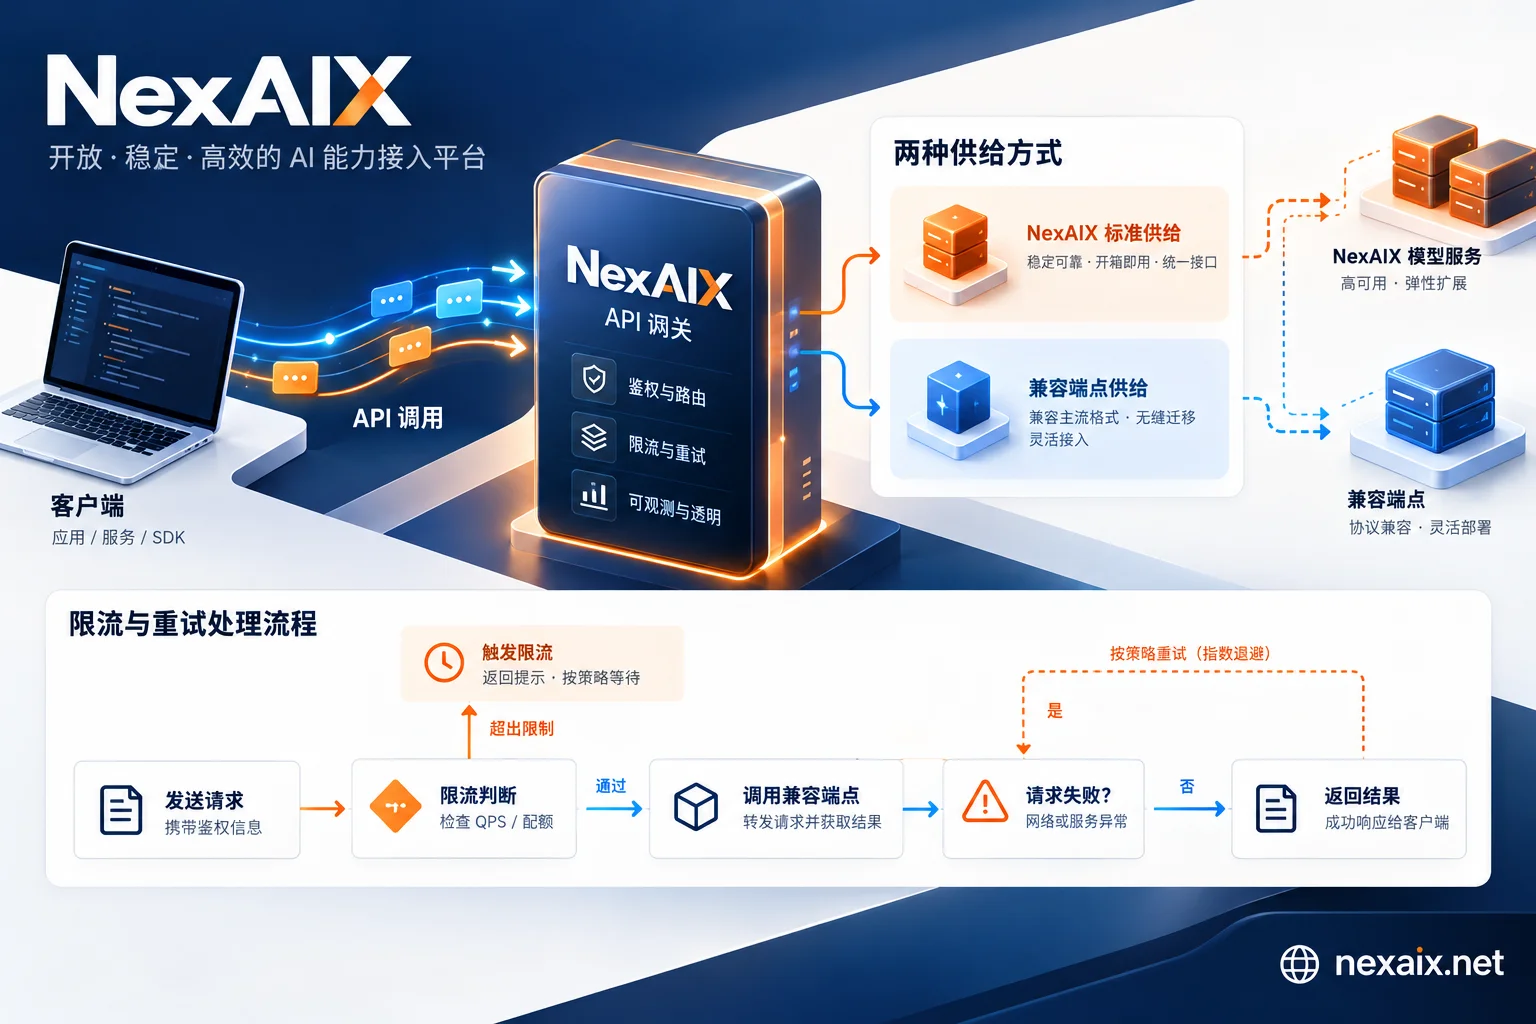
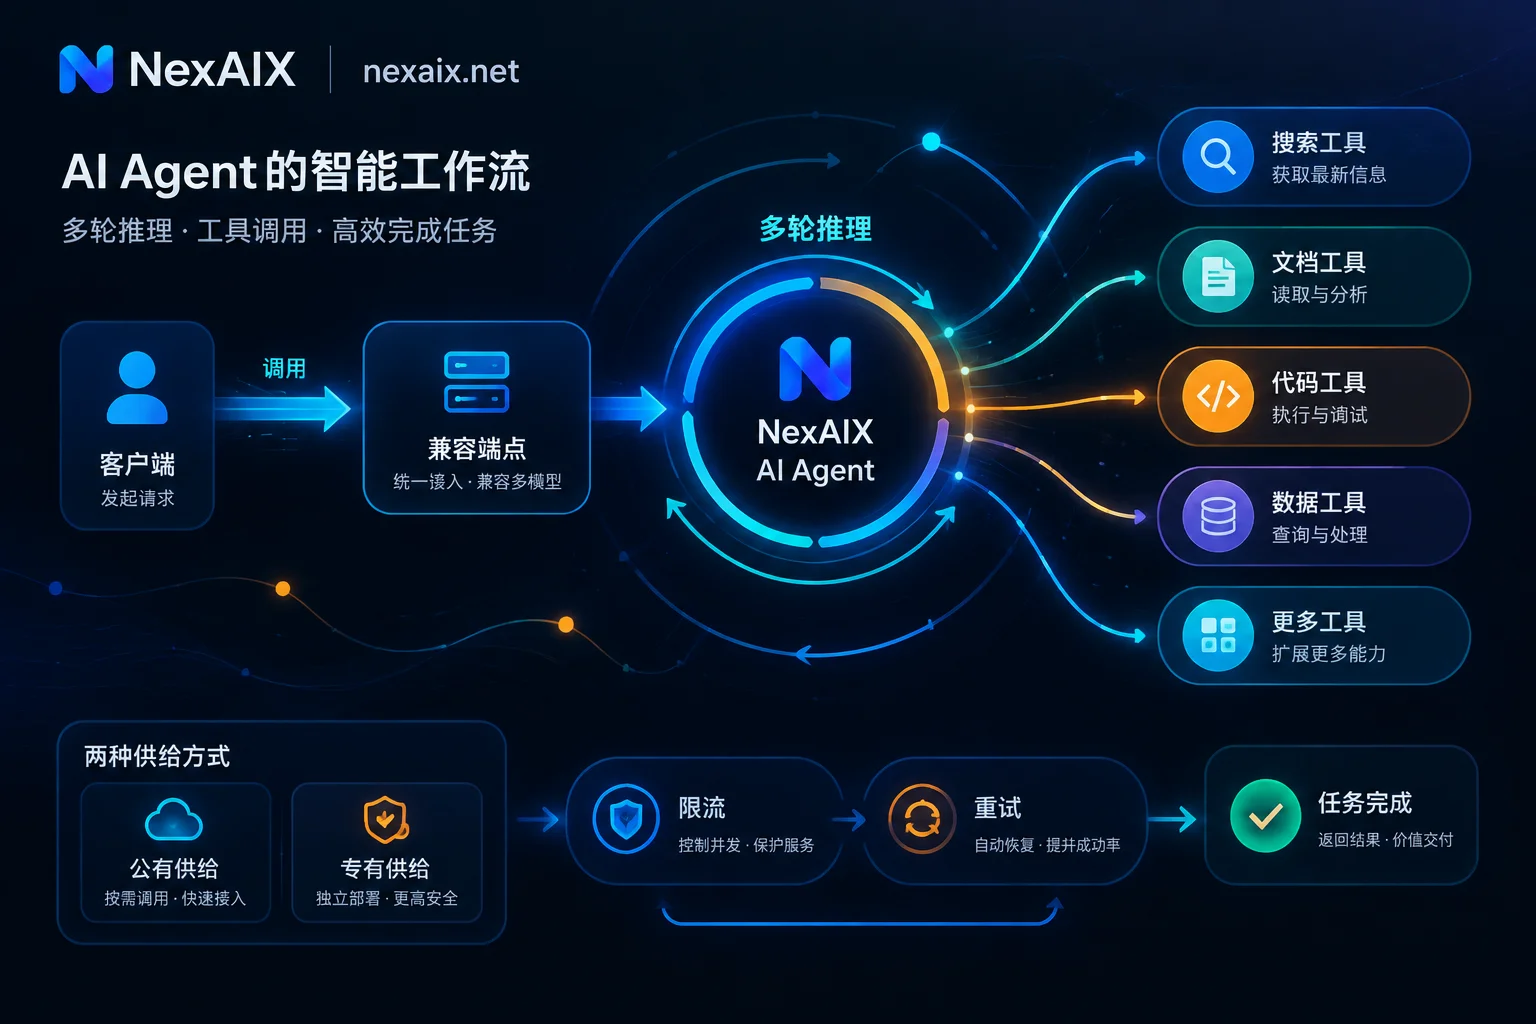
AI Agent 依赖底层模型的原生工具调用能力完成多轮推理,接入 OpenAI 兼容 API 时需要验证四个关键点:端点对 tools 参数的透传支持、长上下文的完整保留、明确的限流配额,以及工具返回后的状态追踪。本文从 LangChain 与 CrewAI 的实际配置出发,说明如何选择可靠的底层 API 并排查常见的截断与限流问题。

AI Agent 依赖底层模型的原生工具调用能力完成多轮推理,接入 OpenAI 兼容 API 时需要验证四个关键点:端点对 tools 参数的透传支持、长上下文的完整保留、明确的限流配额,以及工具返回后的状态追踪。本文从 LangChain 与 CrewAI 的实际配置出发,说明如何选择可靠的底层 API 并排查常见的截断与限流问题。