 NexAIX-官方博客
在 Dify 里给 LLM(Chat 模型)配置 OpenAI 兼容端点时,API endpoint URL 按这个格式填:协议 + 域名 + /v1,末尾不加斜杠,例如:
https://api.nexaix.net/v1不要只写域名 https://api.nexaix.net,也不要写成 https://api.nexaix.net/v1/,更不要把 /chat/completions 一起填进去。下面依次说明每个字段怎么填、为什么要带 /v1、哪些情况要去掉 /v1,以及点保存后报错时按什么顺序排查。
在哪里填,各字段怎么配
入口是 Dify 的「设置」→「模型供应商」→「OpenAI-API-compatible」。这个供应商以官方插件的形式提供,如果列表里找不到,先到插件市场安装 OpenAI-API-compatible。
点击添加模型后,必填字段如下:
- 模型类型(Model Type):对话模型选 LLM。Embedding、Rerank 等按实际用途选择,这几类的 URL 规则有例外,后文单独说明。
- 模型名称(Model Name):必须和服务商公布的模型标识完全一致,包括大小写、连字符和版本后缀。这里填的不是自己起的显示名,Dify 会把它原样放进请求的
model字段。 - API endpoint URL:有些版本里叫 API Base URL,两者是同一个字段。填法见开头。
- API Key:服务商发给你的密钥。
- 补全模式(Completion mode):通常选 Chat。
如果接的是 NexAIX,端点填 https://api.nexaix.net/v1。模型名称到模型清单里对应的模型页复制标识,不要凭印象手打。模型页上也写明了该模型的供给方式:开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道。API Key 在官网导航的「获取 API Key」里申请,注册后有测试额度,足够先把 Dify 这一步调通。
为什么必须带 /v1
Dify 在发请求时,会把你填的 URL 原样当作前缀,然后直接拼上 /chat/completions。
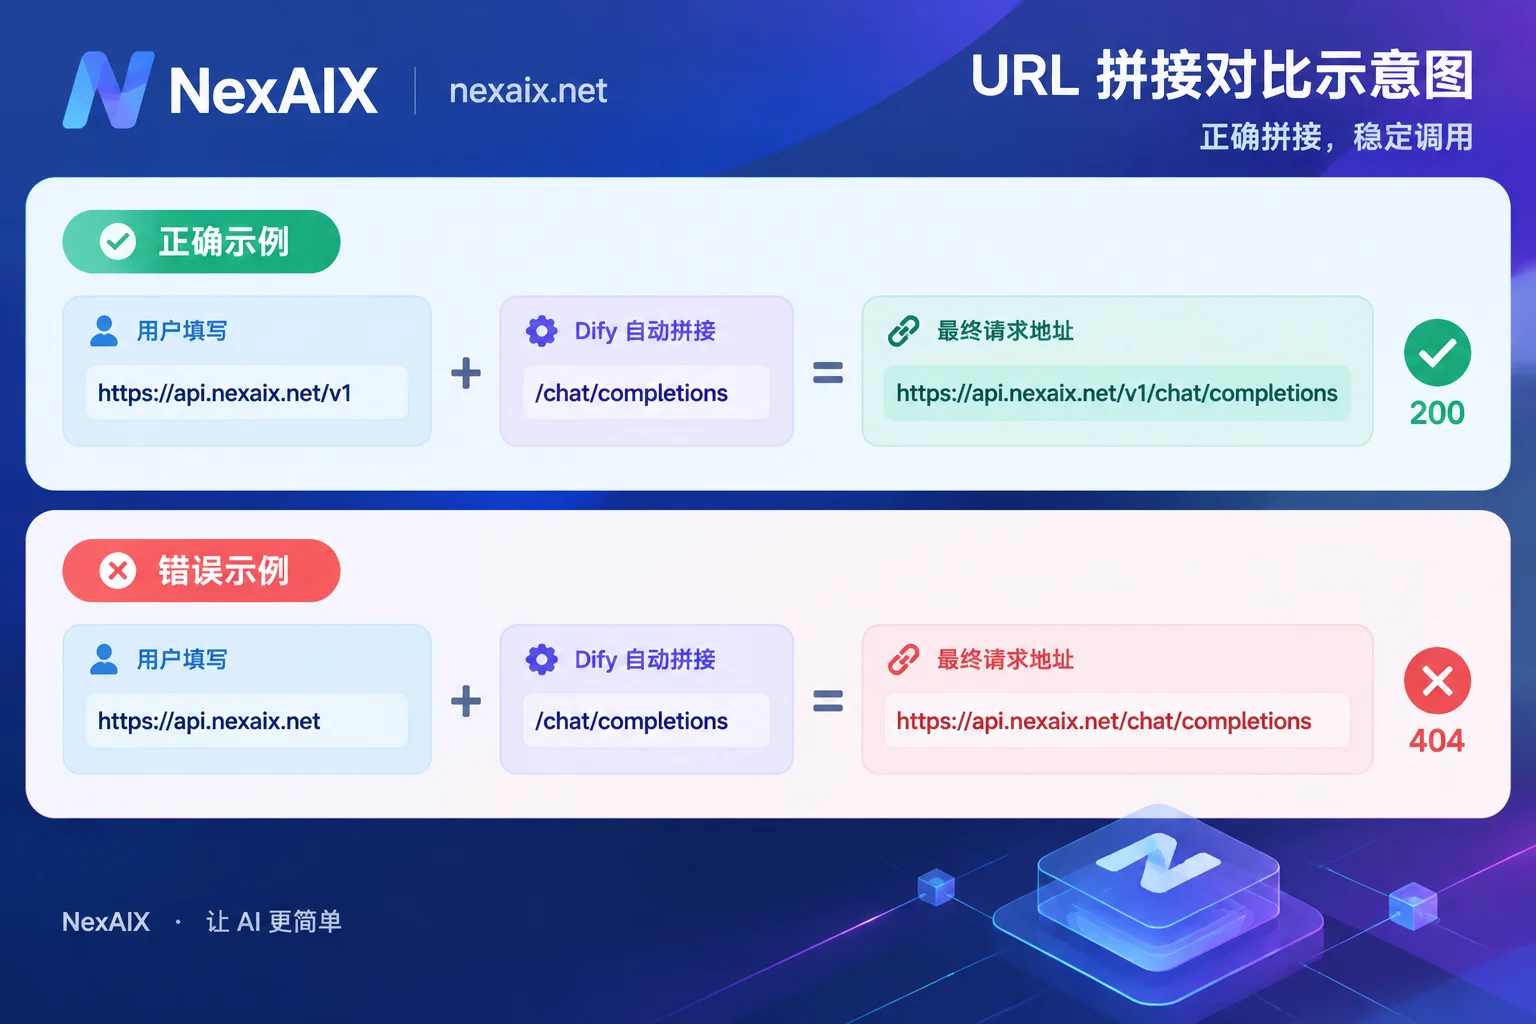
- 填
https://api.nexaix.net/v1,实际请求是https://api.nexaix.net/v1/chat/completions,路径正确。 - 填
https://api.nexaix.net,实际请求变成https://api.nexaix.net/chat/completions,少了版本号,服务端找不到这个路由,会返回 404。
末尾的斜杠也建议去掉。部分插件实现会自动删掉多余的 /,但不能保证每个版本都这样处理。写成 https://域名/v1 最稳妥,可以避免出现 //chat/completions 这类路径解析问题。
其他工具里的「base_url」大多是同样的逻辑。如果你在 SDK 或别的客户端里已经接过同一个服务,那边能用的 base_url 一般可以直接复制过来。改 base_url 的通用思路见 OpenAI 兼容接口怎么用。
例外:Embedding、Rerank 报 /v1/v1
上面的规则针对 LLM。在部分旧版插件里,Text Embedding、Rerank、语音转文字(STT)这些非 LLM 模型会在内部自动再追加一个 /v1。这时如果你照常填了 .../v1,实际请求会变成 .../v1/v1/embeddings,同样会报错。
处理方法:只有在非 LLM 模型的报错信息里明确看到 /v1/v1 时,才把这个模型的 URL 改成不带 /v1 的根域名,例如 https://api.nexaix.net。LLM 模型不受影响,仍然填带 /v1 的完整地址。不要为了统一,把所有模型的 /v1 都删掉。
点保存报错:按这个顺序查
Dify 保存模型配置时,会立刻用你填的参数发一次测试调用。报「Credentials validation failed」或 400,说明这次测试调用没有成功,不一定是 Key 写错了。建议按下面的顺序检查:
1. 先确认 URL 的形状。 检查四点:带 https://、带 /v1、末尾没有斜杠、没有多填 /chat/completions。如果报错是 404,大概率出在这里。
2. 再查模型名称。 名称和服务商公布的标识只要差一个字符,测试调用就会失败。最常见的是把显示名、旧版本名或别的平台的叫法填了进去。
3. 然后查 Key。 Key 必须有效,并且有调用这个模型的权限和剩余配额。如果你的服务按 Key 划分权限和额度(NexAIX 就是每把 Key 独立配额、权限和用量账单),要确认 Dify 里填的这把 Key 确实能调这个模型。Key 的分配和存放可以参考 AI API Key 怎么拿、怎么存、怎么分。
4. 最后查网络,主要针对 Docker 部署。 Dify 跑在 Docker 容器里时,URL 中的 localhost 或 127.0.0.1 指向容器自己,不是你的宿主机。所以连宿主机或局域网里的本地模型、代理服务时,会出现 Connection Refused。这种情况要改成 host.docker.internal 或宿主机的局域网 IP。如果调用的是公网 HTTPS 端点(比如 https://api.nexaix.net/v1),就不涉及这个问题。
排查时,可以先绕开 Dify,在命令行用同样的三样东西(URL、模型名、Key)直接发一次请求:
curl https://api.nexaix.net/v1/chat/completions \
  -H "Authorization: Bearer $YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"你在 Dify 里填的模型名称","messages":[{"role":"user","content":"hi"}]}'
根据结果判断问题出在哪一侧:
- curl 能返回正常回复,Dify 却保存失败:问题在 Dify 这一侧,比如字段填错,或者容器网络不通。
- curl 也报错:先看状态码。401 一般是 Key 有问题,404 是路径或模型名有问题,429 是限流或配额不足。各状态码的具体含义可以对照 AI API 错误码怎么看。
小结
LLM 填 https://域名/v1,不加尾部斜杠;只有非 LLM 模型报 /v1/v1 时才去掉 /v1;模型名称从服务商的模型页复制;Docker 里不要用 localhost 指向宿主机。保存成功后,在 Dify 里新建一个应用发几条消息,确认回复正常,就可以接到工作流里使用了。



评论(0)