 NexAIX-官方博客
调用模型 API 报错时,先别急着重试。判断顺序是:先看 HTTP 状态码,再看响应体里的 error.type 或 error.code,最后才看 message。按这个顺序,大部分错误都能归入两类:
- 改了请求才会好:400、401、404,以及 429 里的额度耗尽。重试多少次,结果都一样。
- 等一会儿可能就好:429 里的速率限制,以及 500、502、503、504 和 Anthropic 的 529。只有这类才值得退避重试。
把这两类分开,是写重试逻辑、配告警和排障的起点。
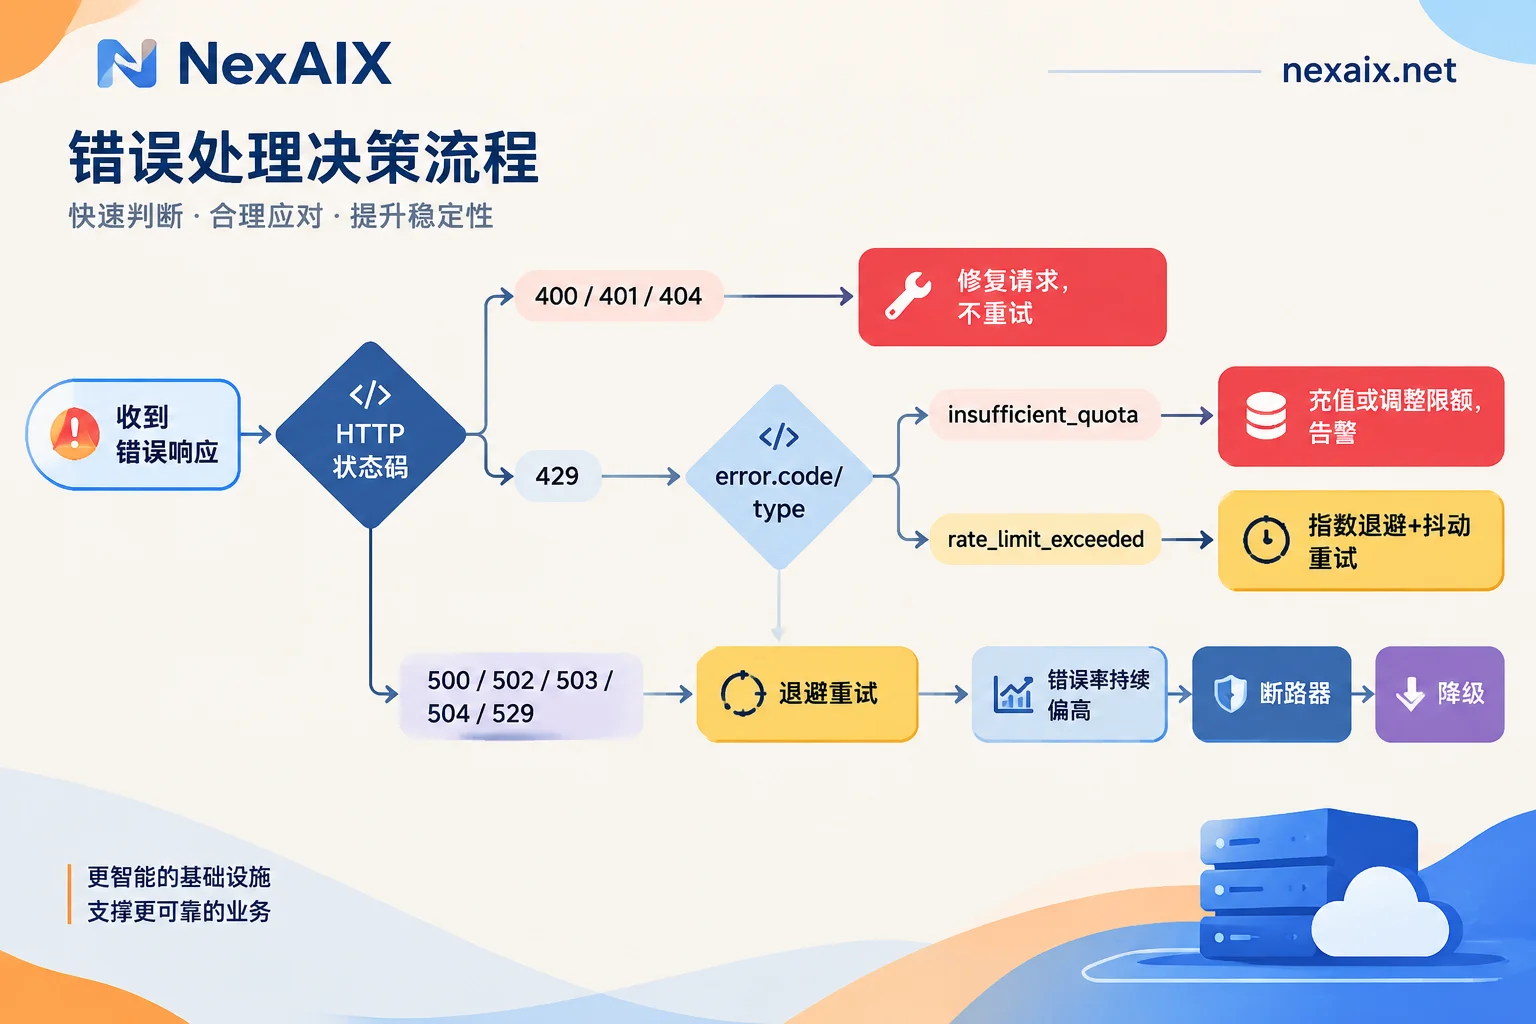
错误响应长什么样,代码该按什么分支
OpenAI 规范和 Anthropic 等厂商的错误返回格式大体一致,都是 HTTP 状态码加一个 JSON 结构体,常见形态如下:
{"error": {"message": "...", "type": "...", "code": "...", "param": null}}各平台的字段不完全相同,有的带 code,有的主要靠 type,但原则一样:分支判断基于状态码和 type/code,message 只用来给人看、写日志。message 的措辞可能随版本调整,拿它做字符串匹配,文案一改,重试逻辑就会悄悄失效。
还要考虑拿不到 JSON 的情况。502、504 这类网关错误的响应体可能是一段 HTML,也可能是空的。解析失败时别让异常处理本身崩掉,按状态码兜底即可。
逐个看:原因和处理
400:请求本身有问题
这类错误属于 invalid_request_error 一类,说明服务端认为请求不合法。常见原因有三种:参数名拼错;传了当前模型不支持的参数或调用方式;context_length_exceeded,即输入 tokens 加上预留的输出 tokens(如 max_tokens)超过了模型的上下文窗口。
处理方式是修请求。如果响应里有 param 字段,它往往直接指出是哪个参数出了问题,先看它。遇到上下文超限,可以用分词工具估算长度,然后截断或压缩历史消息,或者调小输出预留。窗口和输出上限的算法见模型上下文窗口对比。
401:鉴权失败
对应 authentication_error 或 invalid_api_key,这类错误不可重试。建议按下面的顺序查:
- 请求头是否写成
Authorization: Bearer <key>,前缀和空格有没有写错; - Key 是否复制完整,有没有多出换行或空格;
- Key 是否已经轮换或被删除;
- 代码读取的环境变量是否真的有值。本地能跑、部署后报 401,很多时候是容器或 CI 里没有注入变量。
404:找不到模型或路径
对应 not_found_error 或 model_not_found,常见原因有三个:
- 模型名写错,尤其是版本后缀、日期后缀对不上;
- 当前 Key 没有访问这个模型的权限;
- 端点路径不对,比如
base_url漏了/v1,或者多拼了一段路径。
迁移服务商时最容易遇到 404:base_url 换了,模型名却还沿用原平台的写法。
429:先分清是限流还是没额度了
同样是 429,背后可能是两件完全不同的事:
- 速率限制(
rate_limit_exceeded):短时间内的请求数(RPM)、Token 数(TPM)或并发数超了限额。这是临时状态,等一等再发就行。 - 额度耗尽(
insufficient_quota,或余额不足、触发消费上限之类的类型):这是计费问题,重试多少次都会失败,只能充值或调整限额。
不少重试逻辑写成“遇到 429 就重试”。结果额度用完后,程序一直在退避里空转,告警也没有触发。一定要按 code/type 把两者分开,额度耗尽时直接报错并通知人。具体的取值以你所用平台的文档为准。
如果速率限制频繁出现,说明并发设计和限额不匹配,光靠重试只能治标。可以参考AI API 吞吐量怎么测、怎么提来调整并发和请求节奏。
500、502、503、504、529:服务端临时故障
500 是服务端内部错误;502、504 通常出在上游网关或超时环节;503 和 Anthropic 的 529(overloaded_error)表示服务暂时不可用或过载。这些错误一般不是你的代码引起的,属于可重试错误。
不过,“可重试”不等于“立刻重试”。服务端过载时,如果所有客户端同时立即重发,只会把负载推得更高。504 和客户端自身超时怎么区分,见AI API 超时怎么解决。
重试怎么写才不添乱
- 只重试可重试的错误:速率限制类 429 和 5xx、529。400、401、404 和额度耗尽直接失败。
- 指数退避加随机抖动:等待时间按 1 秒、2 秒、4 秒递增并设上限,每次再加一点随机偏移,避免大量客户端在同一时刻一起重发。
- 优先听服务端的:如果响应头给了重试等待时间(如
retry-after),就按它等。 - 限制总次数和总时长:对用户在线请求,总等待时间要小于前端能接受的时长。
- 留意 SDK 自带的重试:官方 SDK 通常内置少量重试(如
max_retries参数)。自己再包一层,重试次数会相乘,所以两者选一,或者把 SDK 的次数调小。
下面是一个最小示例,以 httpx 发送请求:
import random
import time

import httpx

RETRYABLE_STATUS = {500, 502, 503, 504, 529}
QUOTA_CODES = {"insufficient_quota"}  # 按所用平台文档补充

def post_with_retry(client: httpx.Client, url, payload, max_retries=4, base=1.0, cap=20.0):
    for attempt in range(max_retries + 1):
        resp = client.post(url, json=payload)
        if resp.status_code < 400:
            return resp.json()

        try:
            err = resp.json().get("error") or {}
        except ValueError:
            err = {}  # 网关错误可能不是 JSON
        code = err.get("code") or err.get("type")

        if resp.status_code == 429:
            retryable = code not in QUOTA_CODES
        else:
            retryable = resp.status_code in RETRYABLE_STATUS
        if not retryable or attempt == max_retries:
            resp.raise_for_status()

        wait = resp.headers.get("retry-after")
        if wait and wait.isdigit():
            delay = float(wait)
        else:
            delay = min(cap, base * 2 ** attempt) * random.uniform(0.5, 1.0)
        time.sleep(delay)
连接超时这类网络层异常也应该纳入重试,示例里省略了这部分。
持续失败时:断路器和降级
退避重试解决的是偶发故障。如果一段时间内 5xx 或 529 的比例一直很高,继续重试只是浪费时间,还会加重拥堵。这时要用断路器:错误率超过阈值就断开,在一段时间内不再发请求,直接走降级逻辑;冷却后先放少量请求试探,确认恢复了再闭合。
降级方式按业务来定,可以切换到备用模型、返回缓存结果、把非实时任务放进队列稍后处理,或者给用户一个明确的提示。切换备用模型之前,要确认它的上下文窗口和参数支持与主模型兼容,否则降级路径本身就会撞上 400。
日志里记什么
每次失败至少记录这些信息:状态码、error.type、error.code、param、模型名、请求耗时,以及响应头里的请求 ID(如果平台有返回)。
告警按 type/code 分级处理:
- 401、404 一出现就该通知人,通常意味着配置变了;
- 429 额度耗尽要立即告警;
- 速率限制和 5xx 看比例和持续时间,偶发的可以只记录。
更完整的排障顺序,包括输出截断和怀疑模型被降配的情况,可以看AI API 故障排查。
迁到 NexAIX 后怎么对照排查
NexAIX 提供 OpenAI 兼容端点,迁移时只需把 base_url 改为 https://api.nexaix.net/v1,上面的错误分类和重试逻辑可以直接沿用。有几处需要对照一下:
- 遇到 404,先核对两处:
base_url是否带了/v1,模型名是否和模型清单上写的一致。 - 配额与限速是公开的,并且按 API Key 隔离,每把 Key 有独立的配额。多个服务共用一把 Key 时,会互相抢同一份限额;拆成多把 Key,限流就互不影响。
- 网关是否有自己的错误码或请求追踪头,以官网导航中的「文档」为准。



评论(0)