 NexAIX-官方博客
调用报错时,先不要急着换模型或改业务代码。排查顺序是:记下状态码和响应体里的错误字段 → 用最小请求复现 → 按错误类别处理。多数问题出在客户端配置层:Key、base_url、模型 ID 或超时设置。剩下的集中在限流、长文本超时和上下文长度。如果怀疑模型被“掺水”,需要另外做一套验证。
先做两件事:保留现场,缩小范围
第一,完整记录错误信息。只记“报错了”没法排查。需要保留这几样:
- HTTP 状态码;
- 响应体中的
error.type、error.code和error.message; - 响应头,包括请求 ID 和限流相关字段(如果服务方返回)。
同样是 429,错误类型不同,处理方式完全相反。
第二,绕开框架,用 curl 发一个最小请求。
curl $BASE_URL/chat/completions \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model":"<模型ID>","messages":[{"role":"user","content":"ping"}],"max_tokens":16}'- curl 能通、代码不通:问题在你的客户端、框架或中间代理。
- curl 也不通:按下面的状态码逐项查。
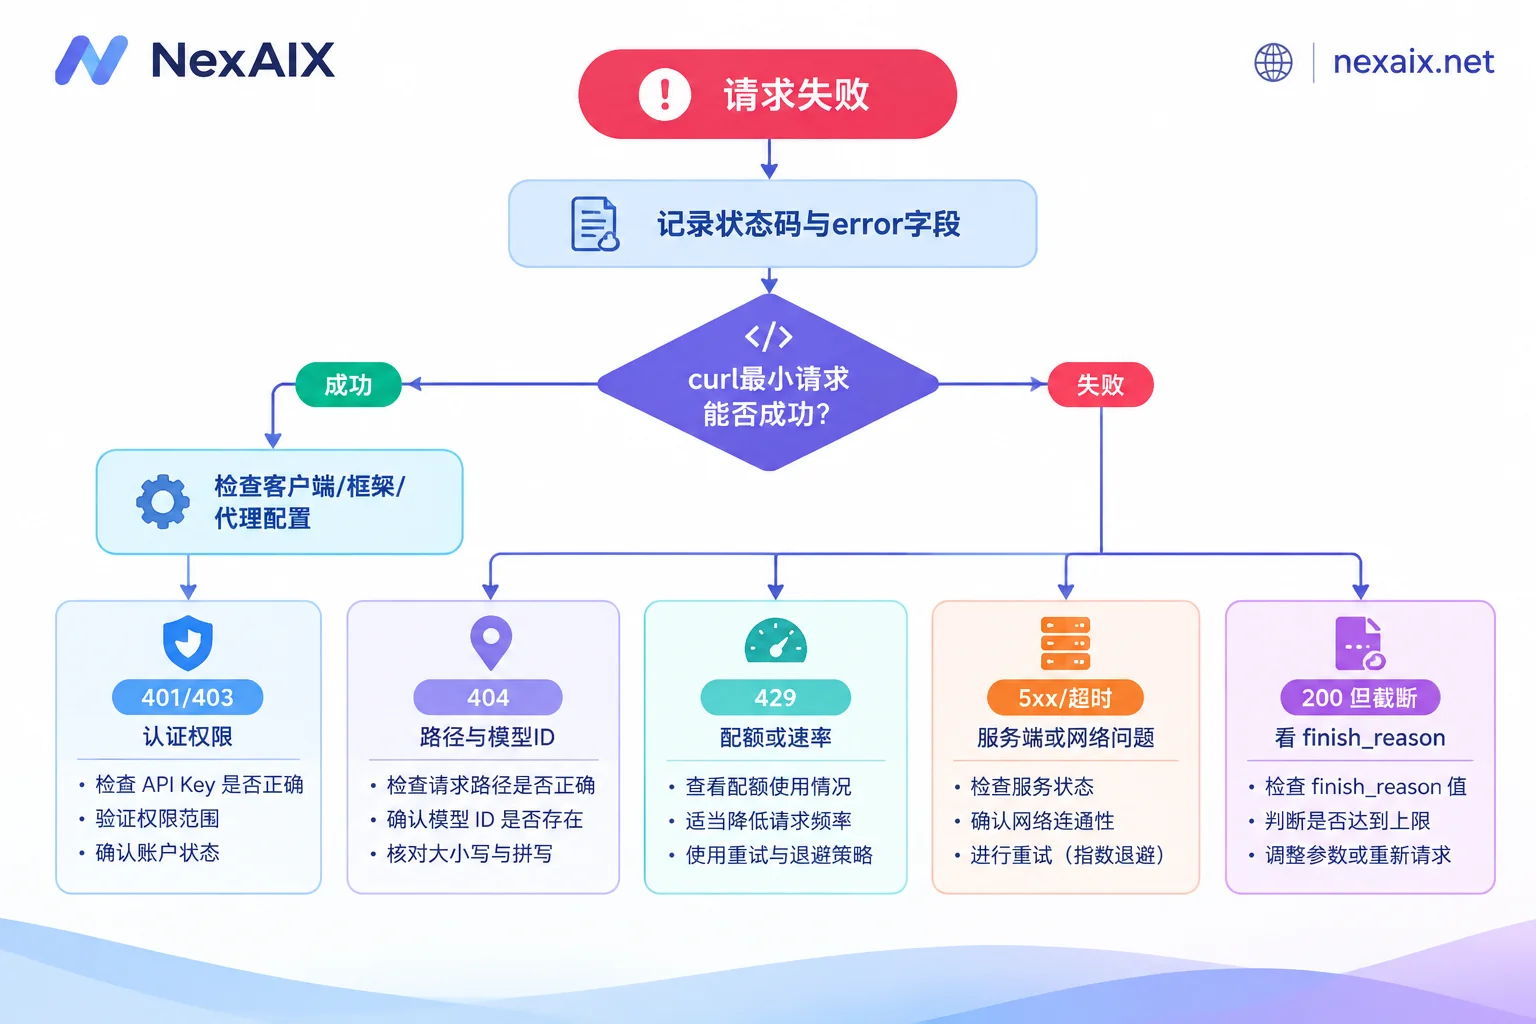
401 / 403:先怀疑 Key 本身和它的“归属”
401 通常是凭证没被认出来。按这个顺序检查:
- 请求头格式。应为
Authorization: Bearer <API_KEY>。常见错误是漏了Bearer,或者 Bearer 后面没有空格。 - 环境变量被污染。从
.env、CI 变量或配置面板复制 Key 时,容易带进首尾空格、不可见的换行符或引号。可以打印一下 Key 的长度和首尾几个字符,读取时顺手做一次strip()。 - Key 和 base_url 是否属于同一个平台。这类错误很常见:原厂 Key 发到了中转服务的端点,或者反过来。每个平台的 Key 只在自己的端点有效。
- Key 是否处于激活状态。确认它没有被停用或删除。
403 更多是权限问题。Key 本身有效,但无权访问这个模型或这个功能。如果平台按 Key 分配权限,就去对应 Key 的设置里看它能调用哪些模型。
404 / model_not_found:路径拼错,或模型 ID 不对
用 OpenAI 兼容接口时,404 基本就是两个原因。
原因一:base_url 填错了。大多数 OpenAI 兼容 SDK 会在 base_url 后面自动追加 /chat/completions 这类路径,所以 base_url 应该填到版本号为止:
- ✅
https://api.example.com/v1 - ❌
https://api.example.com:缺了/v1,拼出来的路径不存在。 - ❌
https://api.example.com/v1/chat/completions:SDK 再追加一次,路径就重复了。
少数工具要求填完整路径,以它自己的文档为准。
原因二:模型 ID 不匹配。同一个开源模型,不同服务商的命名可能不一样,版本后缀、大小写、组织名前缀都可能有差异。不要凭记忆填,也不要从别家文档里复制,要到当前服务商的模型清单里核对确切的 ID。
如果你是往 NexAIX 迁移,只需要把 base_url 改成 https://api.nexaix.net/v1,其余调用代码不动。模型 ID 以 NexAIX 模型清单 为准。每个模型页也标明了供给方式:开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道。
429:先分清“没额度了”还是“太快了”
429 不能一律重试。先解析响应体里的错误类型:
- 配额或余额耗尽,例如
insufficient_quota、credit_balance_exhausted这类。重试不会恢复,只会白白浪费请求。应该去检查额度或余额,并在代码里把这类错误直接抛给上层,不要进入重试循环。 - 速率限制,即 RPM(每分钟请求数)或 TPM(每分钟 Token 数)超限。这类可以重试,但要按规矩来:先读响应头里的
Retry-After或x-ratelimit-*字段;没有这些字段时,用带随机抖动的指数退避。
import random, time

def call_with_backoff(fn, max_retries=6):
    for i in range(max_retries):
        try:
            return fn()
        except RateLimitError as e:  # 只捕获速率类 429,配额耗尽不要进来
            wait = min(60, (2 ** i)) + random.uniform(0, 1)
            time.sleep(wait)
    raise RuntimeError("重试次数用尽")
抖动的作用是避免大量请求在同一时刻一起重试,再次撞上限流。限流头的字段名因平台而异,以你所用服务的文档为准。
如果 429 频繁出现,说明并发设计和配额不匹配,光靠重试解决不了。可以参考 AI API 吞吐量怎么测、怎么提,把并发数、RPM/TPM 和延迟放在一起重新规划。
500 / 502 / 503 / 504 与超时:看是不是长文本非流式
500 / 503 多是服务端瞬时抖动或模型暂时过载,属于可重试错误。官方 SDK 默认会对这类错误做有限次数的自动重试。如果某个模型持续返回 503,先降低请求频率,再观察一段时间。
502 / 504 或客户端 Read Timeout 要重点看任务类型。它们高发于非流式的长文本生成:模型要生成几千个 Token,可能耗时几分钟,而 HTTP 客户端或中间的反向代理(Nginx、Cloudflare 等)默认读超时常在 30 到 60 秒,时间一到就直接断开连接。模型其实还在生成,只是结果没能送回来。
两种解决办法:
- 调大超时。客户端和你自己控制的每一层代理都要调,比如调到 180 秒以上。只改客户端不改代理,问题依旧。
- 改用
stream: true。通过 SSE 流式传输,Token 会陆续返回,连接一直有数据流动,不容易被当成空闲连接切断。这也是长输出任务更推荐的做法。
开了流式以后,如果输出时断时续或者一次性吐出来,检查中间的 Nginx 是否开启了响应缓冲。流式接口通常要关闭 proxy_buffering。
截断:区分“超长报错”和“正常写满”
400 context_length_exceeded:输入 Token 加上你设置的 max_tokens,总和超过了模型的上下文窗口。解决办法是压缩输入(裁剪历史消息、做摘要),或者调小 max_tokens。注意,max_tokens 设得过大本身就可能触发这个错误。
返回 200,但内容戛然而止:先看响应里的 finish_reason。
length:输出达到了max_tokens,或者达到模型单次回复长度上限。这不是网络问题,需要调高max_tokens,或者让模型分段输出。stop:模型正常结束。- 流式传输中途没有收到带
finish_reason的结束块:这才更像连接中断,回到上一节排查超时和代理。
不同模型的窗口和输出上限差别很大,具体怎么算可以看 模型上下文窗口对比。
怀疑模型被降配:用可复现的测试说话
“感觉变笨了”不能当证据,需要做对比测试:
- 看元数据。部分接口会返回
system_fingerprint,它的变化说明后端配置有调整。但字段不变并不能证明没问题,而且不是所有模型和服务方都返回这个字段。如果支持 logprobs,也可以把 Token 概率分布作为辅助参照。 - 建一套固定的探针用例。挑选小模型大概率答错的题目,比如有陷阱的代码题、多步推理的数学题。在相同参数(包括固定的 temperature)下多次运行,与官方渠道或你早期留下的基线结果对比正确率,不要只看单次结果。
- 做长上下文“大海捞针”测试。在很长的文本深处埋一条信息,然后让模型检索。如果在某个长度之后召回率突然断崖式下跌,而同一模型在官方渠道没有这种现象,就可能是上下文被裁剪了。
这套方法对任何服务商都适用。NexAIX 公开了不换小模型、不降精度、不砍上下文等承诺,并配套了可自行验证的方法,详见 四条承诺与验证方法。建议你在接入初期就跑一遍基线并保存结果,以后出现疑问时才有对照。
一张速查清单
- 401:Bearer 格式、Key 里的空白字符、Key 与端点是否同一平台
- 403:这把 Key 有没有该模型的权限
- 404:base_url 是否只写到
/v1,模型 ID 是否来自当前服务商的清单 - 429:配额耗尽就停止重试;速率超限就按 Retry-After 或指数退避加抖动重试
- 5xx 与超时:500/503 可以重试;502/504 先查长文本非流式,调大各层超时或改用流式
- 截断:400 查窗口总和;200 截断看
finish_reason - 降配:固定探针集加大海捞针测试,与基线对比



评论(0)