 NexAIX-官方博客
先说结论:Node.js 18 及以上版本有两种调用方式。大多数项目直接用官方 openai npm 包,把 baseURL 和 apiKey 换成服务商给的值,其余代码不用动。如果你不想引入依赖,或者运行在只支持标准 Web API 的环境里,可以用全局 fetch。这种写法下,流式解析、超时和重试要自己处理。
下面按“接通 → 流式 → 超时重试 → 错误处理”的顺序给出两种写法的代码。
SDK 还是 fetch:怎么选
- 用 SDK:做正式业务、需要流式输出、希望有自动重试和结构化错误类型时选它。SDK 对 429 和部分 5xx(500/502/503/504)内置了指数退避重试,错误也已分好类。
- 用 fetch:适合一次性脚本、对包体积敏感的场景,或者你想完全掌握请求细节。代价是 SSE 解析、超时中断和重试逻辑都要自己写。
如果拿不准,先用 SDK。
用 openai SDK 接入兼容端点
npm install openai接入 OpenAI 兼容端点时不需要换 SDK,实例化客户端时传入 baseURL 和 apiKey 就够了。以 NexAIX 为例,端点是 https://api.nexaix.net/v1,需要改的就是这一行:
// index.mjs(使用顶层 await 需 .mjs 后缀或在 package.json 中设置 "type": "module")
import OpenAI from 'openai';

const client = new OpenAI({
  apiKey: process.env.NEXAIX_API_KEY,
  baseURL: 'https://api.nexaix.net/v1',
  timeout: 60000,   // 毫秒
  maxRetries: 2,    // 自动重试次数
});

const res = await client.chat.completions.create({
  model: 'your-model-id',
  messages: [{ role: 'user', content: '用一句话解释什么是 SSE' }],
});

console.log(res.choices[0].message.content);
有三点要注意:
- Key 放在环境变量里,不要写进代码或提交到仓库。本地、测试和生产环境最好各用一把 Key,具体做法可以参考 AI API Key 怎么拿、怎么存、怎么分。
model必须填服务商实际提供的模型 ID。不同模型对max_tokens、temperature等参数的支持范围可能不同,以模型详情页为准。在 NexAIX 的模型清单里,每个模型页都标明了供给方式:开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道。页面上也列出了该模型的规格。baseURL末尾要带/v1。SDK 会在后面自动拼上/chat/completions。如果少写或多写一段路径,最常见的结果是 404。
流式输出:先让用户看到第一个字
输出较长或者面向终端用户时,建议开启流式。总耗时不会减少,但首字出现得早得多。在请求体里加上 stream: true,返回的对象可以用 for await 逐块读取:
const stream = await client.chat.completions.create({
  model: 'your-model-id',
  messages: [{ role: 'user', content: '写一段 200 字的产品介绍' }],
  stream: true,
});

let full = '';
for await (const chunk of stream) {
  const delta = chunk.choices[0]?.delta?.content ?? '';
  full += delta;
  process.stdout.write(delta);
}
这里的 ?. 不能省。有些分块的 choices 是空数组,或者没有 content 字段,直接取值会报 undefined 错误。
另外,流开始后如果在中途断开,已经输出的内容无法通过自动重试“续上”。业务层要决定怎么处理:整段重来,还是保留已输出的部分并提示用户。
不用 SDK:原生 fetch 写法
非流式请求
请求用 POST 方法,带上 Authorization: Bearer <KEY> 和 Content-Type: application/json 两个请求头,body 是序列化后的 JSON。超时用 AbortController 控制:
async function chat(messages) {
  const controller = new AbortController();
  const timer = setTimeout(() => controller.abort(), 60000);
  try {
    const resp = await fetch('https://api.nexaix.net/v1/chat/completions', {
      method: 'POST',
      headers: {
        Authorization: `Bearer ${process.env.NEXAIX_API_KEY}`,
        'Content-Type': 'application/json',
      },
      body: JSON.stringify({ model: 'your-model-id', messages }),
      signal: controller.signal,
    });
    if (!resp.ok) {
      const err = new Error(`HTTP ${resp.status}: ${await resp.text()}`);
      err.status = resp.status;
      throw err;
    }
    const data = await resp.json();
    return data.choices[0].message.content;
  } finally {
    clearTimeout(timer);
  }
}
遇到非 2xx 响应时,记得把响应体文本一起抛出来。服务端返回的错误说明通常就在里面,比只看状态码更容易定位问题。
流式请求:自己解析 SSE
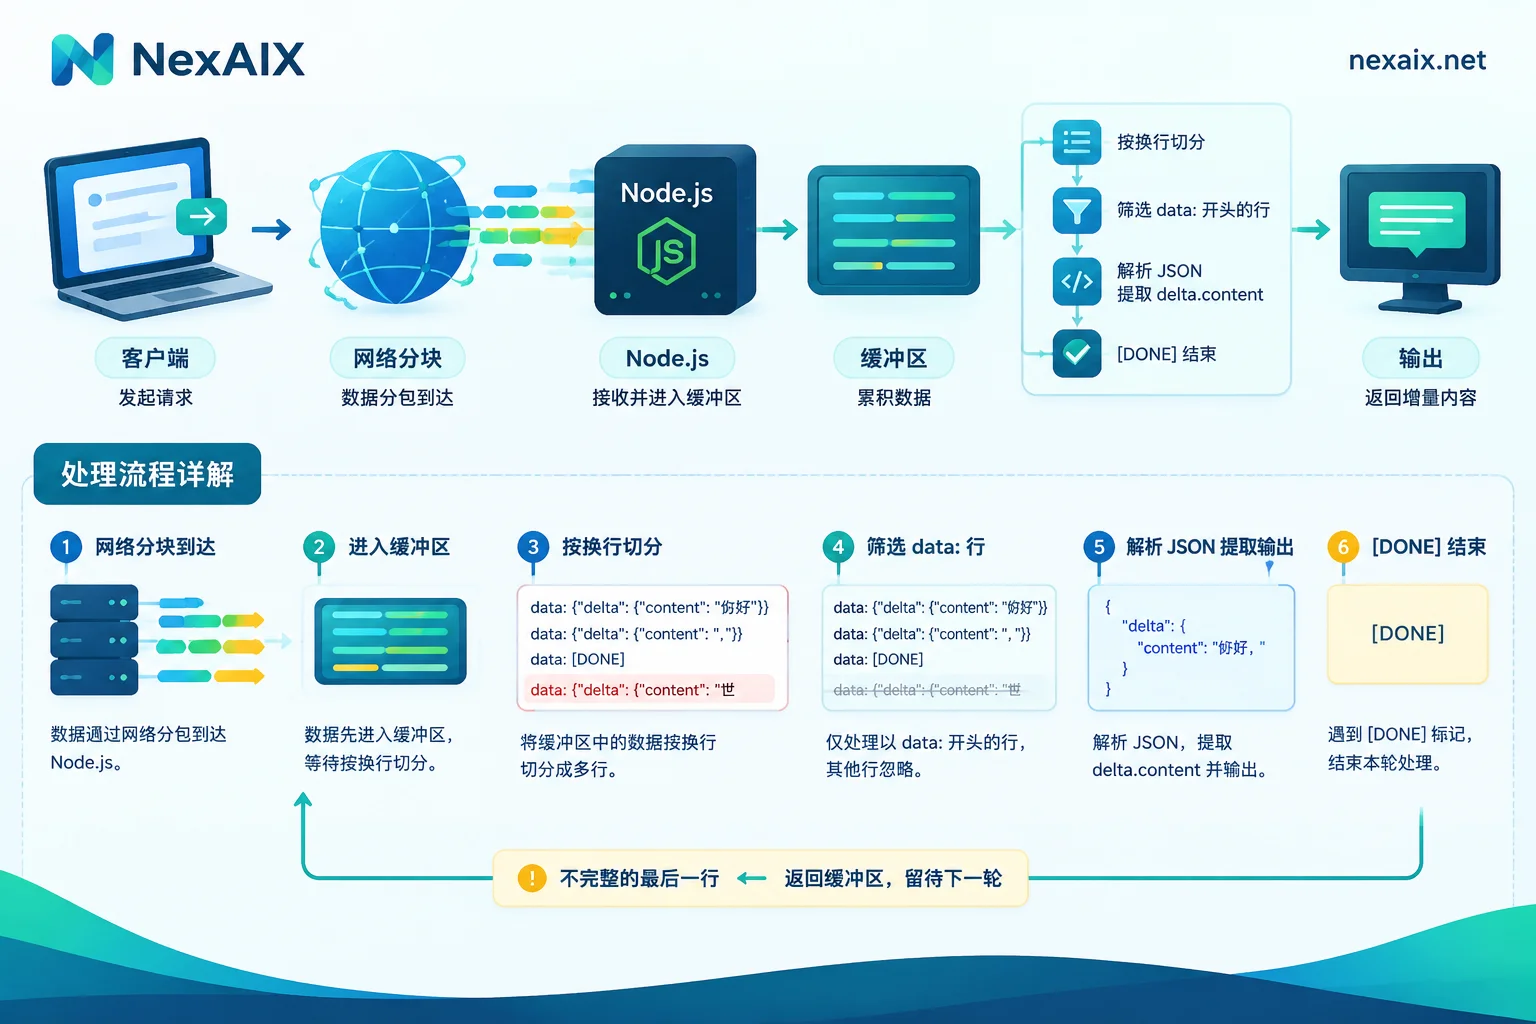
流式响应遵循 Server-Sent Events 格式:每条数据以 data: 开头,最后以 data: [DONE] 结束。解析时最容易出错的地方是,一个网络分块不一定正好对应一行,所以必须先缓冲,再按换行切分:
async function streamChat(messages, onDelta) {
  const resp = await fetch('https://api.nexaix.net/v1/chat/completions', {
    method: 'POST',
    headers: {
      Authorization: `Bearer ${process.env.NEXAIX_API_KEY}`,
      'Content-Type': 'application/json',
    },
    body: JSON.stringify({ model: 'your-model-id', messages, stream: true }),
  });
  if (!resp.ok) throw new Error(`HTTP ${resp.status}: ${await resp.text()}`);

  const decoder = new TextDecoder();
  let buffer = '';
  for await (const part of resp.body) {
    buffer += decoder.decode(part, { stream: true });
    const lines = buffer.split('\n');
    buffer = lines.pop(); // 最后一段可能不完整,留到下一轮
    for (const line of lines) {
      const trimmed = line.trim();
      if (!trimmed.startsWith('data:')) continue;
      const payload = trimmed.slice(5).trim();
      if (payload === '[DONE]') return;
      const json = JSON.parse(payload);
      onDelta(json.choices[0]?.delta?.content ?? '');
    }
  }
}
流式请求的超时不要设成整个请求的固定时长,否则长回答会被误杀。更合适的做法是“空闲超时”:每收到一个分块就重置计时器,只有连续一段时间没有数据才 abort()。
超时与重试:只重试该重试的
SDK:timeout 和 maxRetries 既可以在构造客户端时全局设置,也可以在单次调用时覆盖。比如对一个特别长的生成任务单独放宽:
await client.chat.completions.create(params, { timeout: 120000, maxRetries: 1 });SDK 已经对 429 和部分 5xx 做了指数退避重试,不要在外面再套一层循环重试,否则重试次数会成倍叠加,反而更容易撞上限速。
fetch:需要自己写重试,原则是按状态码区分:
- 400、401、403、404:请求或配置本身有问题,重试多少次结果都一样,应该直接报错。
- 429、500、502、503、504 以及网络中断:可以退避后重试。如果响应头带了
Retry-After,优先按它给的时间等待。
async function withRetry(fn, retries = 3) {
  for (let i = 0; ; i++) {
    try {
      return await fn();
    } catch (err) {
      const retryable = !err.status || err.status === 429 || err.status >= 500;
      if (!retryable || i >= retries) throw err;
      const wait = 2 ** i * 1000 + Math.random() * 300; // 指数退避加抖动
      await new Promise((r) => setTimeout(r, wait));
    }
  }
}

const answer = await withRetry(() => chat([{ role: 'user', content: '你好' }]));
超时之后具体是哪一段链路慢(客户端、网关还是模型生成),排查方法见 AI API 超时怎么解决。
错误分类处理
SDK 抛出的是结构化错误。因为子类都继承自 APIError,判断时要先检查具体类型,最后再兜底:
try {
  const res = await client.chat.completions.create(params);
} catch (err) {
  if (err instanceof OpenAI.AuthenticationError) {
    // 401:Key 错误、失效或没有权限,应该报警,不要重试
  } else if (err instanceof OpenAI.RateLimitError) {
    // 429:可能是触发了限速,也可能是额度不足,要看 err.message 区分
  } else if (err instanceof OpenAI.APIConnectionError) {
    // 连接失败或超时:检查网络、代理和 baseURL
  } else if (err instanceof OpenAI.APIError) {
    console.error(err.status, err.message);
  } else {
    throw err;
  }
}
生产环境里至少要把 err.status 和 err.message 记进日志。同样是 429,限速和额度用完的处理方式完全不同:前者降低并发或排队,后者需要充值或切换 Key。NexAIX 的配额与限速规则是公开的,具体的错误返回结构以接入文档为准。各状态码的完整含义和降级思路可以看 AI API 错误码怎么看。
上线前的自检
- 用一个最短的非流式请求确认能接通:拿到 200,并且
choices[0].message.content有内容。 - 再测一次流式请求,确认分块能连续输出,并且收到了结束标识。
- 故意填错 Key,确认 401 被正确识别,而且没有触发重试。
- 用并发压一下,观察 429 是否按退避策略恢复,以及日志里能否区分限速和额度不足。
这几步走通后,就可以接入真实业务。如果你还没有 Key,可以在 NexAIX 官网导航的「获取 API Key」注册,领取测试额度后用上面的代码直接验证。如果项目里同时有 Python 服务,可以对照阅读 Python 调用 AI API,两边的配置思路是一致的。



评论(0)