 NexAIX-官方博客
大模型 API 超时,多数情况下网络并没有真的断开。常见的情况是模型还在生成,链路上某一层的等待时间先到了上限。长 Prompt 的预填充(Prefill)要花时间,逐个 Token 的解码耗时又会随输出长度增加,而 SDK、Nginx、Cloudflare 的默认超时一般只有几十秒到一百秒左右。
建议按这个顺序处理:先确认断在哪一层 → 开启流式输出 → 给客户端分段设置超时 → 调整代理配置 → 限制重试次数和输出长度。多数项目做完前两步,超时就会明显减少。
第一步:确认是哪一层超时
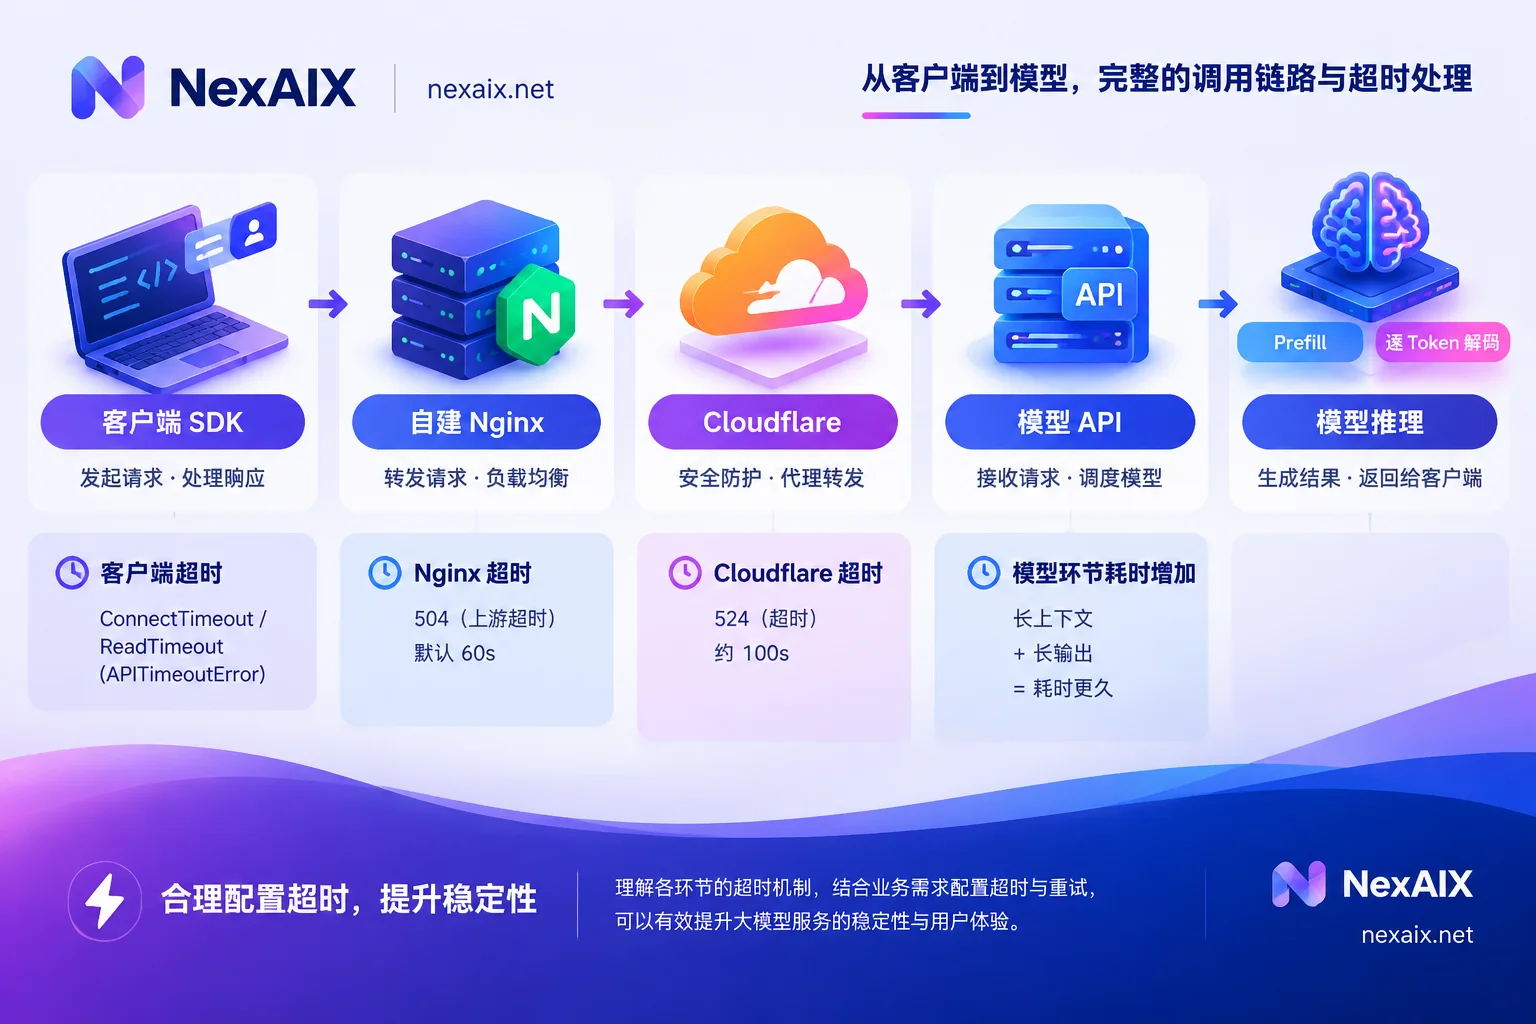
不同的报错对应不同的断点,先对号入座:
| 现象 | 通常断在哪 | 先查什么 |
|---|---|---|
| 连接阶段就失败,报 ConnectTimeout 或连接错误 | 本地到服务端的建连 | DNS 解析、本地代理、防火墙、base_url 是否写对 |
APITimeoutError、httpx.ReadTimeout | 客户端等待响应时超过了 read 上限 | Prompt 是否过长、输出是否过长、是否没开流式 |
| HTTP 504 | 中间的反向代理(常见的是自建 Nginx) | proxy_read_timeout、代理缓冲 |
| HTTP 524 | Cloudflare 等待源站响应超时 | 是否没开流式、任务总耗时是否过长 |
断开的时间点也很有参考价值。建议在日志里记录每个请求的发出时间、首个 Token 到达时间和结束时间。如果失败总是卡在 60 秒左右,先怀疑 Nginx 的默认值;如果在 100 秒上下,先看 Cloudflare;如果刚好等于你在代码里设置的 timeout,问题在客户端。这些只是排查线索,最终以各层日志为准。
另外,429 属于限流,不是超时。401、404、429 这类错误的定位方法,可以参考AI API 故障排查:从 401、404、429 到超时、截断。
第二步:长输出任务开启流式
非流式请求要等整段回答生成完才开始返回数据。输出一长,很容易超过 30~60 秒的默认阈值。开启 stream=true 后,服务端会通过 SSE 一块一块地返回 Token,这样有两个好处:
- 用户更早看到第一个字,首 Token 延迟(TTFT)的体感会好很多;
- 连接上一直有数据在传,中间代理不会因为长时间没有数据而把连接当成闲置断开。
如果业务上需要拿到完整结果再处理,也不必改回非流式。Anthropic 官方 SDK 的建议是:内部仍然用流式请求,再通过 SDK 提供的方法收集最终消息。这样既能拿到整包结果,又避开了非流式 HTTP 长时间阻塞导致的超时。用 OpenAI 兼容接口时也可以这样做,在代码里把各个 chunk 拼起来即可。
第三步:客户端分段设置超时
OpenAI Python SDK 的底层是 HTTPX,超时可以分成建连、读取、写入几段分别设置。建连失败通常是网络问题,这一项设短一些,可以尽快失败;读取留得长一些,给模型足够的生成时间。
import httpx
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nexaix.net/v1",  # 直连官方端点时删掉这一行
    api_key="YOUR_API_KEY",
    timeout=httpx.Timeout(120.0, connect=5.0, read=120.0, write=5.0),
    max_retries=0,  # 重试交给下文的自定义逻辑
)

stream = client.chat.completions.create(
    model="your-model",
    messages=[{"role": "user", "content": "..."}],
    stream=True,
    max_tokens=2000,
)

parts = []
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        parts.append(chunk.choices[0].delta.content)
result = "".join(parts)
设置 read 时要注意两点:
- HTTPX 的 read 超时,计算的是“等待下一块数据”的最长时间,不是整个请求的总时长。所以开了流式之后,总生成时间长一点也不会触发它。
- 首个 Token 出来之前的这段等待也算在 read 里。长上下文的 Prefill,或者推理类模型在输出前的思考,都可能在这里停顿较久,read 需要留出足够的余量。
如果你是把现有应用迁到 NexAIX,只需要改 base_url 这一行,上面的超时和流式写法都不用动。NexAIX 的端点兼容 OpenAI 协议,配额和限速都已公开。网关的具体空闲时长请以接入文档为准,并建议用自己业务里耗时最长的那类请求实际测一遍,再确定 read 的数值。选模型时,可以先在模型清单里查看各模型的上下文规格和供给方式。
第四步:检查自建代理和 Cloudflare
Nginx。 proxy_read_timeout 默认是 60 秒,长时间生成的请求很容易被它断开,返回 504。代理流式接口时还要关闭缓冲。否则 Nginx 会先把 SSE 数据存在缓冲区里,下游客户端迟迟收不到数据,反而会触发客户端自己的读取超时。
location /v1/ {
    proxy_pass https://your-upstream;
    proxy_http_version 1.1;
    proxy_buffering off;
    proxy_cache off;
    proxy_read_timeout 300s;
    proxy_send_timeout 300s;
}
300~600 秒是常用范围,具体取值应略大于你业务里最长请求的实际耗时。如果 Nginx 前面还有负载均衡或 Ingress,它们也各有自己的超时设置,需要逐层检查。
Cloudflare。 经过 Cloudflare 代理时,读取超时大约在 100 秒上下,超过就返回 524,请求会被直接截断。可行的做法主要有两种:一是开启流式,让数据持续返回;二是把批量长文生成、整本文档处理这类离线任务改成异步执行,先返回一个任务 ID,结果由后台生成后,客户端再通过轮询或回调获取。
第五步:控制重试次数和输出长度
重试本身有用,但配错了会让问题更严重。超时设得太短时,SDK 的自动重试会在模型快生成完的时候断开连接,再从头发起一个新请求。等待时间更长,费用也会重复计算。
更稳妥的做法是:只对偶发超时和连接错误重试,最多重试 2~3 次,每次间隔按“指数退避 + 随机抖动”计算,避免大量请求同时重试把服务压垮:
import random, time
from openai import APITimeoutError, APIConnectionError

def call_with_retry(fn, attempts=3, base=1.0, cap=20.0):
    for i in range(attempts):
        try:
            return fn()
        except (APITimeoutError, APIConnectionError):
            if i == attempts - 1:
                raise
            time.sleep(random.uniform(0, min(cap, base * 2 ** i)))
如果流式请求在中途断开,重试会从头开始生成。前端要处理好已经显示出来的那部分内容,比如清空后重新展示,或者提示用户“重新生成中”。
还要从源头控制耗时。给 max_tokens 设一个合理的上限,防止模型输出过长导致耗时失控;对不需要的历史消息和冗长的系统提示做裁剪,Prefill 时间会随之缩短。输入长度、输出上限和延迟之间的关系,在模型上下文窗口对比中有更详细的计算方法。
按顺序自查
- 从日志中的断开时间点判断是客户端、Nginx 还是 Cloudflare 超时;
- 输出较长或推理较重的任务改用流式,需要整包结果时在代码里拼接;
- 客户端设置分段超时:connect 设短,read 按最长请求的实测耗时留足余量;
- 自建代理调大
proxy_read_timeout并关闭proxy_buffering;经过 Cloudflare 的长任务,改用流式或异步; - 重试限制在 2~3 次并使用退避加抖动,同时设好
max_tokens、精简上下文。
如果高并发时才出现超时,同时伴随 429,那么瓶颈更可能在吞吐量和限速上,而不是超时配置,可以接着看AI API 吞吐量怎么测、怎么提。



评论(0)