 NexAIX-官方博客
生产环境里说吞吐量不够,通常是三类问题混在一起:模型生成得慢,客户端并发开得不对,或者撞上了供应商的限流。建议这样处理:
- 衡量:用系统每秒输出词元数(TPS)和每秒完成请求数(RPS)衡量吞吐量,同时记录每个请求的首字时间(TTFT)。
- 定并发:在限流额度内逐步加并发,停在 TPS 不再明显增长、TTFT 开始恶化的拐点之前。
- 降成本:通过连接复用、Prompt 缓存和控制词元用量,降低每个请求的开销。
- 处理 429:优先读取
retry-after,再用带随机抖动的指数退避重新调度,不要立刻重发。
吞吐量和延迟是两笔账
单个请求的端到端延迟可以拆成:
E2E 延迟 = TTFT + TPOT × 输出词元数
- TTFT(首字时间):主要花在 Prefill 阶段。模型要先读完整段输入,这一步受算力限制,输入越长通常越慢。
- TPOT(每个输出词元的时间):属于逐字生成的 Decode 阶段,主要受显存带宽限制。
系统吞吐量要看整体。并发请求越多,服务端越能把请求合并成批处理(Continuous Batching),GPU 利用率和总 TPS 都会上升,直到算力或显存带宽饱和。代价是请求要排队,单个请求的 TTFT 会变长。
所以要先按场景定目标:
- 在线对话、实时代码补全:用户在等屏幕上的第一个字,应该守住 TTFT,并发宁可保守。
- 离线批处理、文档处理、Agent 自动循环:看的是整批任务多久跑完,可以把并发推高,用排队时间换总 TPS。
先测出自己的数字
别人的基准数据只能参考。你的输入长度、输出长度和模型都会改变结果。建议用真实业务的 Prompt 做阶梯压测:
- 固定一组有代表性的请求,输入和输出长度按线上分布抽样。
- 并发数按 1、2、4、8、16、32……逐级提高,每级至少跑几十个请求。
- 每个请求记录三个值:TTFT(流式响应收到第一个内容块的时间)、总耗时、输出词元数(优先取响应里的 usage)。
- 每级汇总:TTFT 的 p50 和 p95、系统 TPS(总输出词元数 ÷ 墙钟时间)、429 出现次数。
TPOT 可以用(总耗时 − TTFT)÷ 输出词元数近似。流式响应里怎么拿首字时间和 usage,可以参考流式输出API怎么接。
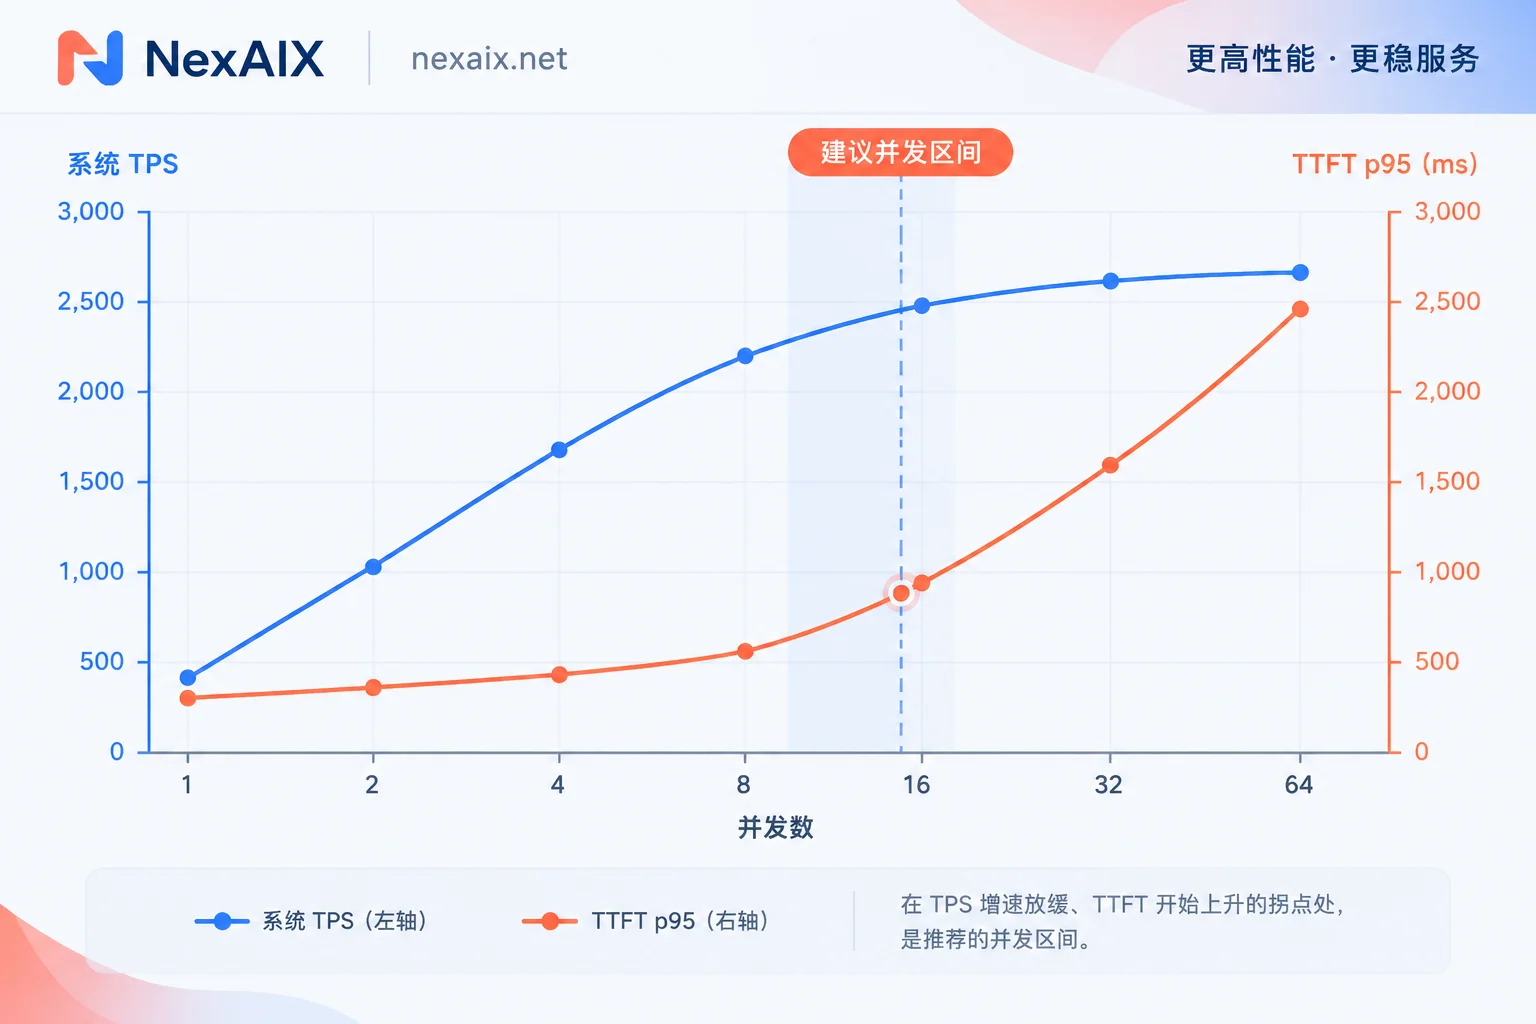
把各级结果画在一起,通常会看到这样的趋势:TPS 先快速上升,然后变平;TTFT 在平台期开始明显上扬。交互场景取拐点前一档,批处理场景可以取拐点附近。如果 429 在拐点之前就频繁出现,瓶颈在限额,不在模型。
并发数要同时对着延迟和限额算
主流模型 API 一般在四个维度独立统计限流:
- 每分钟请求数(RPM)
- 每分钟词元数(TPM),部分厂商还会拆成输入 ITPM 和输出 OTPM
- 每天请求数(RPD)
- 每天词元数(TPD)
多数采用滑动窗口统计,任何一项超限都会返回 HTTP 429。估算时两项都要算:
- 请求维度:所需并发 ≈ 目标 RPS × 平均单请求耗时(秒)。例如平均一个请求 20 秒,想要每秒完成 3 个,同时在途的请求大约 60 个。再换算成每分钟请求数,看是否超过 RPM。
- 词元维度:每分钟请求数 × 单请求平均(输入 + 输出)词元数,看是否超过 TPM。长输入场景往往先撞 TPM,而不是 RPM。
两项里先触顶的那个就是你的上限。继续加并发只会换来更多 429。
代入计算的限额要以你实际调用的那个端点为准。在 NexAIX 上,配额与限速是公开的,可以先在模型清单进入对应模型页,确认规格和供给方式,再把数字代入上面的估算。NexAIX 按 API Key 隔离,每把 Key 有独立的配额、权限和用量账单。在线对话和离线批处理可以分开用不同的 Key,批量任务就不会吃掉交互业务的额度。接入时只需把 base_url 换成 https://api.nexaix.net/v1,其余调用代码不用动。
让每个请求更“便宜”
限额固定时,单请求占用越少,能跑的量就越多:
- 复用连接:整个进程共用一个客户端实例,保持 HTTP/TLS 连接池。每次新建连接要多付 1~3 次往返的握手开销。
- 利用 Prompt 缓存:把系统提示、固定示例这类不变的内容放在最前面,变化的部分放在后面,让支持上下文缓存的服务能复用前缀,减少 Prefill 耗时。各家缓存的触发条件不同,要看具体模型的文档。
- 控制词元数:精简提示词,给
max_tokens设一个贴合任务的上限,直接降低 TPM 占用。上限设得太紧又会导致截断,窗口和输出上限怎么权衡,见模型上下文窗口对比。
并发闸门和 429 退避
遇到 429 就立刻重试,或者按固定间隔重试,会让大量请求在同一时刻再次打上去,形成“惊群”,把配额耗得更快。下面是一个最小可用的写法:用信号量卡住在途请求数,429 时优先按 retry-after 等待,没有这个头再做指数退避,并且都加上随机抖动。
import asyncio, random, time
from openai import AsyncOpenAI, RateLimitError

# 全进程共用一个客户端以复用连接;关闭 SDK 自带重试,避免和下面的重试逻辑叠加
client = AsyncOpenAI(base_url="https://api.nexaix.net/v1", api_key="YOUR_KEY", max_retries=0)
sem = asyncio.Semaphore(16)  # 用压测得到的并发拐点替换

async def call(model, messages):
    async with sem:
        for attempt in range(6):
            try:
                t0, ttft, out = time.perf_counter(), None, 0
                stream = await client.chat.completions.create(
                    model=model, messages=messages, max_tokens=800,
                    stream=True, stream_options={"include_usage": True})
                async for chunk in stream:
                    if ttft is None and chunk.choices and chunk.choices[0].delta.content:
                        ttft = time.perf_counter() - t0
                    if chunk.usage:
                        out = chunk.usage.completion_tokens
                return ttft, time.perf_counter() - t0, out
            except RateLimitError as e:
                ra = e.response.headers.get("retry-after")  # 这里假设值为秒数
                wait = float(ra) if ra else min(60, 2 ** attempt)
                await asyncio.sleep(wait + random.uniform(0, wait * 0.5))
        raise RuntimeError("重试次数耗尽")
补充几点:
- 如果端点不返回 usage,可以改用分词器估算输出词元数。
- 如果 SDK 自带重试,要么关掉,要么只保留一层,否则实际重试次数会成倍增加。
- 多实例部署时,每个进程各自的信号量加起来可能超出 Key 的限额。这时应把限流前移到网关层,用统一的令牌桶和队列主动控速,不要等上游返回 429 再处理。
- 交互请求和批量请求最好分成两条队列,保证交互请求优先出队。
上线后盯这几项
- TTFT 的 p50 和 p95:看用户体感有没有变差。
- 系统 TPS 和 RPS:看是否接近压测时的平台值。
- 429 比例和重试次数:比例持续走高,说明并发或词元用量超出了限额。
- 限流相关响应头:比如 OpenAI 风格的
x-ratelimit-remaining,可以用来提前降速。不同服务的头名称可能不同,以实际响应为准。
流量形态变了,比如输入明显变长,或者换了模型,就重新跑一遍阶梯压测。没有现成环境的话,可以在官网导航的「获取 API Key」注册,用赠送的测试额度按上面的步骤先测出自己的拐点。



评论(0)