 NexAIX-官方博客
线上跑着的模型调用挂了,最省事的做法是外面套一层 retry(3)。这行代码能救一部分请求,也能在流量高峰把你的 Key 彻底打死——因为它对所有错误一视同仁,包括那些重试一万次也不会成功的。
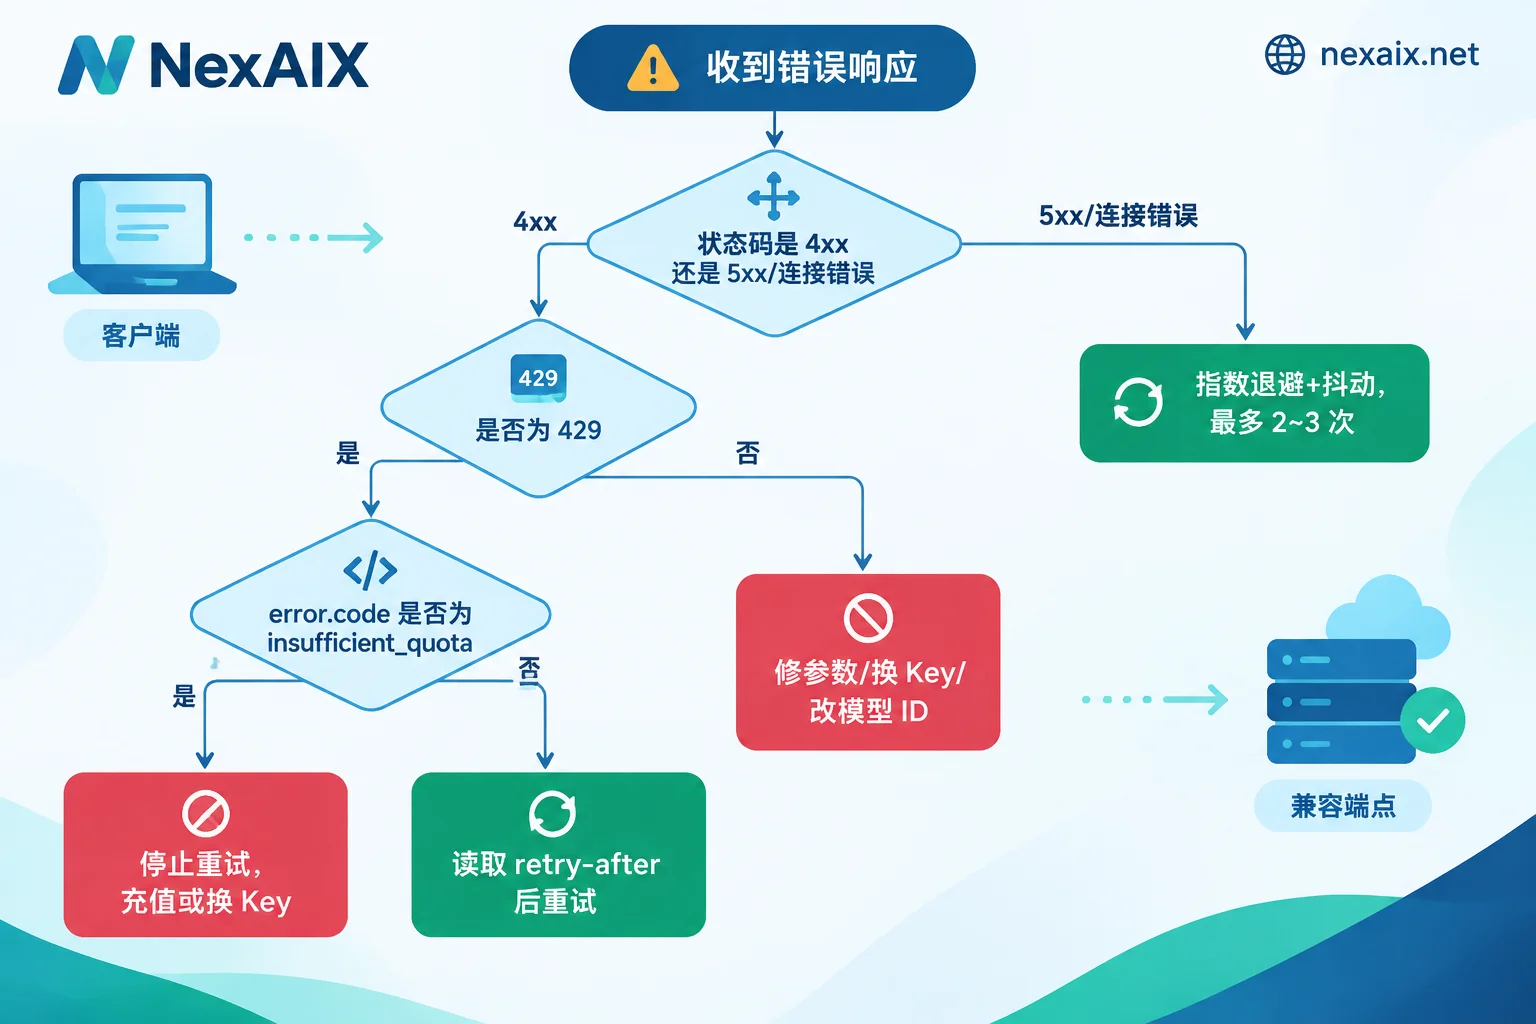
先给结论:重试机制的第一步不是选退避算法,是判断这个错误值不值得重试。判断错了,后面的参数调得再精细也没用。
第一步:把错误分成两堆
把错误按「服务端过一会儿能不能自己好」来分,而不是按状态码大小。
可以重试的(瞬态故障):
429且错误码是速率类的,比如rate_limit_exceeded、slow_down——你在这一分钟内挤占了太多并发或 token 配额,等窗口滚过去就行500内部错误、502网关错误、503服务不可用(server_is_overloaded)、529overloaded_error——上游容量临时打满408请求超时- 连接层失败:TCP 断开、DNS 抖动、TLS 握手失败,在 SDK 里通常表现为
APIConnectionError
不要重试的(确定性故障):
400:参数缺失、JSON 结构不对、context_length_exceeded上下文超长。请求本身有问题,重发一百次还是同一个错401:Key 缺失、写错、已注销403:权限不足或越权访问某个模型404:模型 ID 拼错,或端点路径不对
最容易搞混的是 429。同样是 429,错误码为 insufficient_quota 时表示账户额度耗尽,不是限速,等多久都不会恢复,只能充值或换 Key。如果你的重试逻辑只看状态码不看 body 里的 error.code,余额一见底就会变成对着上游猛刷无效请求,日志里全是 429,真正的原因反而被淹掉。
所以判定函数至少要长这样:
RETRYABLE_STATUS = {408, 409, 500, 502, 503, 504, 529}

def should_retry(status, body):
    if status == 429:
        code = (body.get("error") or {}).get("code")
        return code != "insufficient_quota"
    return status in RETRYABLE_STATUS
400 这一类不该进重试队列,该进告警和参数校验。Claude 侧 400 的细分排查可以参考四类参数拦截对照。
第二步:等多久——先看响应头,再算退避
拿到一个可重试错误后,优先读响应头里的 retry-after。服务端明确告诉你窗口什么时候滚动,这个值比任何本地算法都准。有些实现给的是秒数,有些给的是 HTTP 时间戳,解析时两种都要兼容,并且加一点随机偏移,避免一批请求卡着同一秒集体涌回去。
没有这个标头时,用带完全抖动的指数退避(Exponential Backoff with Full Jitter):
import random

def wait_seconds(attempt, retry_after=None, base=1.0, cap=20.0):
    if retry_after is not None:
        return min(retry_after + random.uniform(0, 0.5), cap)
    ceiling = min(cap, base * (2 ** attempt))
    return random.uniform(0, ceiling)
关键是最后那行的随机取值,不是 base * 2**n 本身。纯指数退避在多客户端场景下会让所有实例在同一时刻重试,形成惊群效应,第二波冲击往往比第一波更猛。取 0 到上限之间的随机数,把重试摊到一段时间里,恢复速度反而更快。
参数上给几个可用的起点:初始 1 秒、上限 20 秒左右、总重试次数控制在 2~3 次。别把次数堆到 5 次以上——大模型请求本身就慢,5 次重试加上退避等待,用户那边可能已经等了两分钟,还不如早点失败降级。更细的等待时长取舍可以看指数退避重试要等多久合适。
比次数更值得设的是总时间预算。给整个调用(含所有重试)一个上限,比如 90 秒,超过就放弃,不管还剩几次机会。这样面向用户的接口延迟才是可控的。
第三步:别让重试次数相乘
这是生产环境里最常见的隐形放大器。
OpenAI 和 Anthropic 的官方 SDK 默认就带重试,通常对连接错误、408、409、429 和 5xx 做 2 次左右的指数退避。如果你在外面又套了 Tenacity、axios-retry,或者把任务丢进 Celery、Sidekiq 这类带自动重投的队列,实际重试次数是相乘的:SDK 3 次 × 框架 3 次 × 队列 3 次 = 27 次请求。一个偶发 503,被放大成对自己 TPM 配额的定向攻击。
处理方式二选一,别两头都开:
- 交给 SDK:设
max_retries=2,外层框架只做业务级失败处理,不重发请求; - 自己控:把 SDK 的
max_retries设成 0,退避逻辑写在自己这一层,好处是能读到retry-after、能按错误码做分支、能打自己的埋点。
同时给每个请求设 timeout。长输出任务的超时要按预期生成时长估,不要用默认的几十秒一刀切;但也不能不设,否则一个卡住的连接会一直占着并发额度,把后面的请求全拖进 429。
重试耗尽时,抛出带上下文的异常——哪个模型、哪次尝试、最后的状态码和 request id——而不是一个光秃秃的 RetryError。排查的时候这几个字段能省掉大半时间。
第四步:流式输出不能盲目重放
标准重试逻辑只在流建立之前成立。一旦服务端开始吐 token、客户端已经消费了若干个 chunk,这时候断线或中途报错,后台静默重发整条请求再把新内容拼到旧输出后面,结果一定是重复段落或者语义断裂。
按「首个 token 是否已经到达」分两种处理:
- 首 token 之前失败(连接没建起来、握手阶段 5xx):等同于普通请求失败,可以静默重试,用户无感知;
- 首 token 之后失败:不能拼接。要么清空这一轮已渲染的内容、整轮重新生成并替换,要么在界面上明确标出「生成中断」并让用户决定是否重来。
实现上,客户端需要维护一个「本轮是否已产出内容」的标志位,重试装饰器读这个标志位决定走哪条路。另外,流式请求的超时不该按总时长设,更合理的是按chunk 间隔设——两个数据块之间超过 N 秒没动静才判定为断流,否则长回答会被自己的超时误杀。
第五步:有副作用的调用要保幂等
重试的是 HTTP 请求,但服务端可能已经把活干完了——响应在回程路上丢了,你这边看到的是超时。对纯文本生成,重发一次最多是多花一次 token;但在 Agent 场景里,如果上一次请求返回的 tool call 已经被执行(下过单、发过邮件、写过库),重放就会产生第二次副作用。
所以工具执行那一层要自己做幂等:为每轮调用生成业务侧的幂等键,执行前检查是否已完成。别指望模型 API 层面帮你兜住这件事。
在中转端点上,多确认两件事
如果你的请求不是直连厂商,而是走 OpenAI 兼容的中转端点,重试逻辑要多验一步:错误是网关产生的还是上游透传的,retry-after 标头有没有被保留,error.code 的字段结构是否和你代码里的判断一致。最稳妥的做法是在测试阶段故意打满配额、故意用错模型 ID,把完整的响应头和 body 打印出来看一遍,再照着写判定分支——不同实现的错误体结构差异不小,照搬别家文档的字段名容易漏判。
配额口径也值得先看清楚。NexAIX 是单一端点、单一供应方的中转,模型页会标明这个模型是开源权重自有算力部署还是闭源官方授权渠道,配额与限速公开可查,接入时只改 base_url,重试和退避代码一行不用动。按 Key 隔离这一点在重试设计上很实用:把批量离线任务和在线用户请求拆成两把 Key,离线任务的激进重试撞到限速时,不会把在线请求一起拖进 429——这比在代码里写优先级队列省事得多。
还有一个容易被忽略的排查方向:如果重试成功了但输出质量忽高忽低,先别急着调退避参数,确认一下响应是不是被静默换成了小模型或砍了上下文。NexAIX 在四条承诺与验证方法里写了不换小模型、不降精度、不砍上下文以及对应的自查方式;更通用的核验思路可以参考供给透明度与模型降配检测。
一份可以照着抄的默认配置
- 判定:只重试 408/409/5xx/529、连接错误,以及
code != insufficient_quota的 429 - 等待:有
retry-after就听它的,否则 full jitter 指数退避,初始 1s、上限 20s - 次数:2~3 次,同时设总时间预算
- 层级:SDK 内置和外层框架二选一,绝不叠加
- 超时:非流式按预期生成时长设;流式按 chunk 间隔设
- 流式:首 token 后失败一律不静默重放
- 收尾:失败时抛出带 request id 和状态码的异常,并对 429 的两种含义分开计数告警
最后提醒一句,重试是止血手段不是治疗方案。如果 429 在日志里占比持续偏高,说明并发模型或配额档位本身需要调整,靠退避只是把排队挪到了客户端。限流侧的系统性处理可以接着看从 429 标头到退避重试与流量隔离。



评论(0)