 NexAIX-官方博客
GLM-5.3 API接入的第一天,绝大多数存量OpenAI兼容调用只需把 model 字段换成 glm-5.3 就能跑通;唯一会让老代码当场报错的是你在请求体里显式透传了 thinking.type: 'disabled'。官方开放文档在2026年8月14日更新中明确,GLM-5.3 强制开启深度思考,废弃 disabled 选项,沿用旧写法会直接触发参数异常。下面按「先判断、再改参、后验证」三步走,帮你把迁移成本压到最低。
GLM-5.3 API接入先判断:哪些调用换个 model 名就能跑,哪些会当场报错
先对号入座:你的请求体里有没有写过 thinking 这个字段?没写过——恭喜,基本安全,把 model 改成 glm-5.3 即可;写过且值是 disabled——必报错,属于此次唯一破坏性变更;写过但值是 enabled——不报错,但建议按下文新档位重新调优。
| 请求体现状 | 是否阻塞 | 处理动作 |
|---|---|---|
未显式传 thinking 字段 | 否 | 直接换 model 为 glm-5.3,跑通后再考虑调档 |
显式 thinking: {type: 'disabled'} | 是 | 删除该字段或改为 enabled,否则报参数异常 |
显式 thinking: {type: 'enabled'} | 否 | 可继续用,但建议改用 reasoning_effort 控制强度 |
不传 thinking 但设了 reasoning_effort | 否 | 新参数已生效,按场景选 low/high/max |
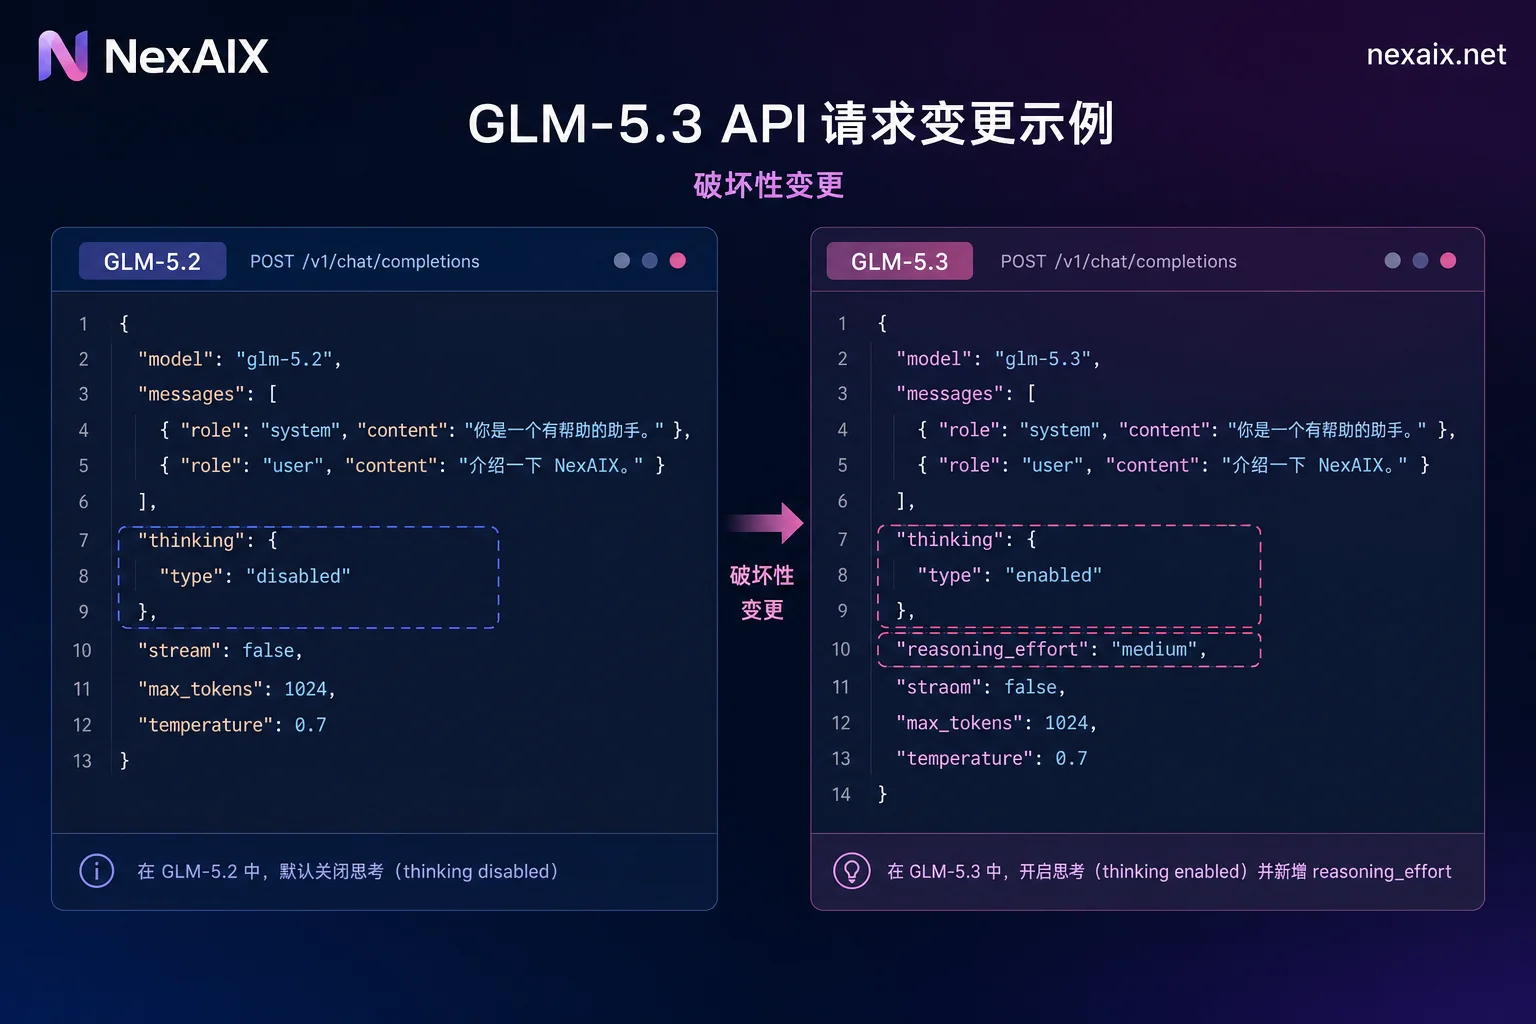
破坏性变更详解:thinking.type='disabled' 废弃后,low/high/max 三档怎么对应原来的开关逻辑
过去在 GLM-5.2 上,你想省 token 或降延迟,会显式传 thinking.type: 'disabled' 关掉思考。到了 GLM-5.3 这条路彻底堵死——模型强制常驻深度思考,你只能通过 reasoning_effort 在 low/high/max 三档之间调节算力投入,官方文档已明确原 disabled 选项不再支持。
从二值开关迁移到三档强度,建议按场景映射:低延迟交互(如简单问答、分类)用 low,常规编程补全、Agent 工具调用用 high,复杂长链路推理(多步规划、深度调试)用 max。注意:档位越高,首 token 延迟和思考 token 消耗通常越大,但官方并未给出各档位具体毫秒数或 token 倍率,需要你按任务实测。另外,推理内容与最终回答是分离返回的,你的解析逻辑要能正确区分这两部分,避免把思考过程混进最终输出。
GLM-5.3 支持 OpenAI 兼容接口吗:三种协议端点的迁移成本对照
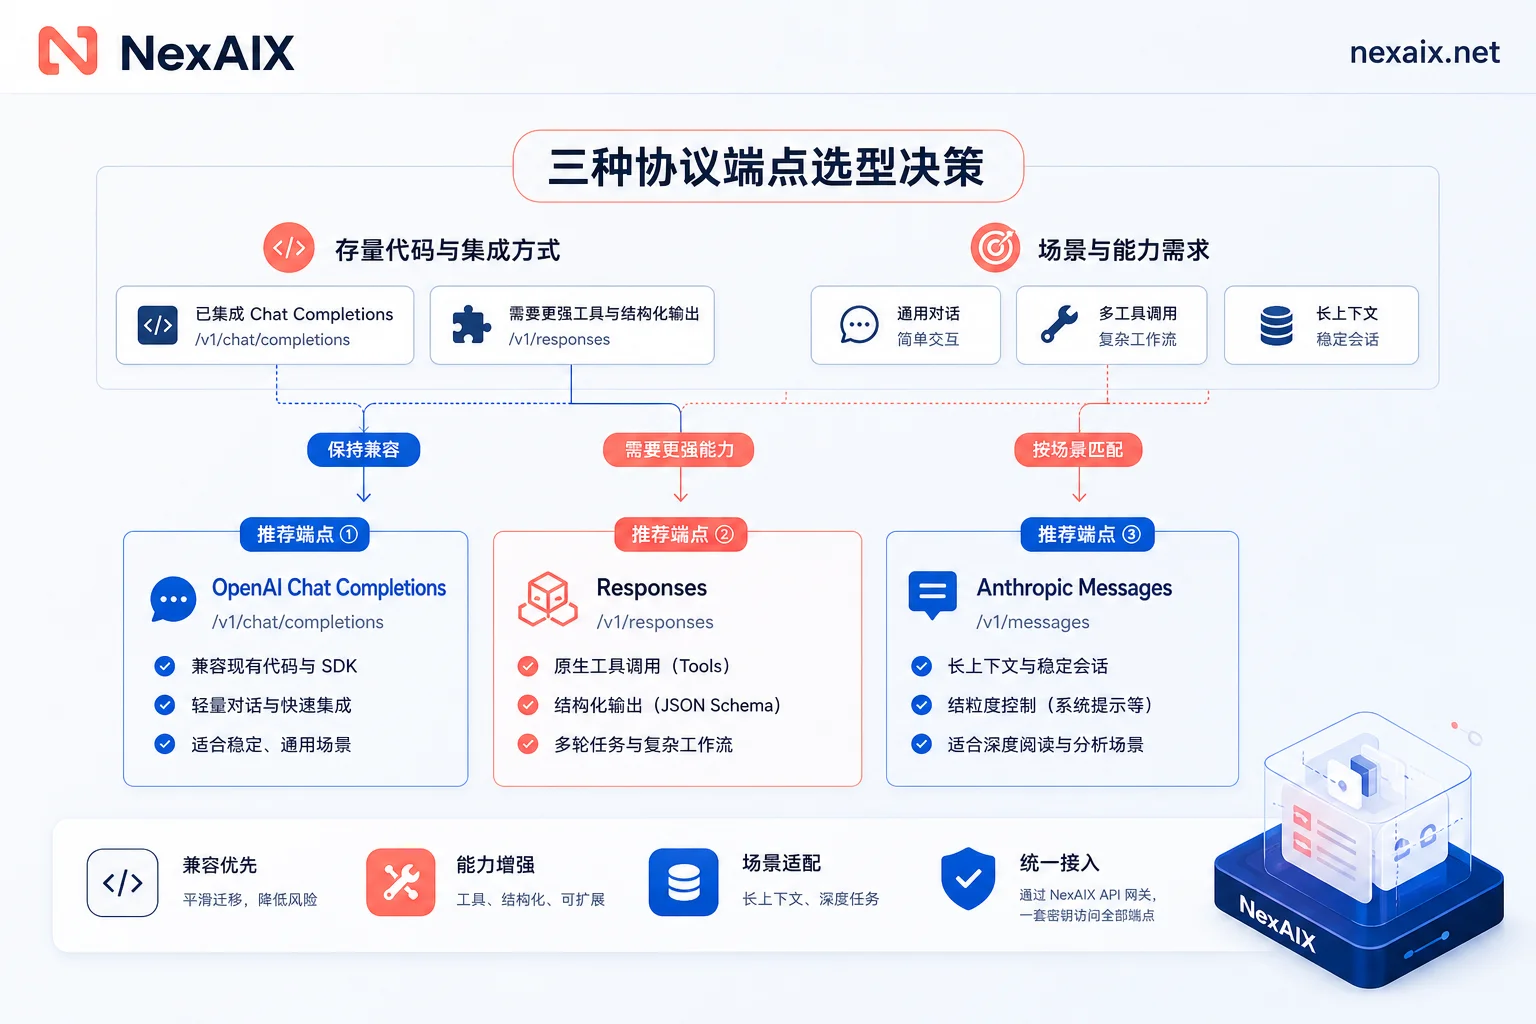
GLM-5.3 官方提供了三条通路,选哪条取决于你的存量代码和团队习惯。原则是:不要为了尝鲜同时换协议和换模型,否则一旦出错,你很难定位是协议适配问题还是模型行为变化。
| 端点类型 | 适用场景 | 主要改动点 | 注意点 |
|---|---|---|---|
| OpenAI Chat Completions | 存量 OpenAI SDK / 代码库 | 仅换 base_url 与 model,兼容性最好 | 推理内容分片处理,工具调用需验证 arguments 解析 |
| OpenAI Responses | 新项目,需更结构化推理过程 | 请求/响应结构有差异,需调整 SDK | 适合想深度利用推理过程做编排的团队 |
| Anthropic Messages | 已用 Claude SDK 或 Agent 框架 | 需适配消息格式与工具调用规范 | 若框架不支持流式推理,需降级处理 |
三种端点的 tool calling 与流式支持细节各有差异,建议先在官方文档确认你要用的特性在目标端点是否可用。如果团队里多种协议并存,GLM-5.3 API接入时尽量统一入口,降低后续维护成本。
1M 上下文与 128K 输出下的 token 预算控制:强制思考会怎么改变你的账单
GLM-5.3 支持 1M 上下文与 128K 最大输出,听起来很爽,但强制常驻思考意味着思考 token 也会计入消耗——以前靠 disabled 压成本的办法彻底失效。官方发布日(2026-08-14)公布的数据显示,编程任务平均单任务约消耗 5 万 token。这个量级直接决定你的预算上限。
控制预算的三个动作:第一,按场景设置合理的 max_tokens,别让单次请求无限膨胀;第二,按 reasoning_effort 分场景路由——轻任务用 low,重任务才升到 high 或 max;第三,切换前后各跑一组典型任务,对比单请求 token 数与耗时,算出成本 delta。要提醒的是,按量计费单价官方尚未公示,当前只能通过积分额度估算相对成本,长期预算得等定价页更新后再精算。
获取路径的现实边界:Coding Plan 积分制、非高峰折扣、按量计费与两周开源缓冲期
回答「现在到底怎么调用」:8月14日首发,GLM-5.3 通过 GLM Coding Plan 订阅制(个人版/团队版)全量开放,当日 13:00 全员额度重置;非高峰时段(含周末)调用享受 50% 积分折扣。按量计费的商业 API 正分批上线,但具体每百万 token 单价还没公示。第三方聚合平台(如 SiliconFlow、OpenRouter)适配排期不一,目前主要靠官方订阅通道或已集成方(如 OpenClaw 的 provider)中转。模型完整权重计划在安全加固后两周内开源,想自建部署就得等权重放出——所以现阶段如果你的团队已有 Coding Plan,可以直接小流量试点;若依赖按量计费或自建,建议等官方计费上线和权重释放后再全量切。
值不值得切:用基准与单任务 token 消耗做量级判断,而不是直接采信
GLM-5.3 与 GLM-5.2 同为约 7430 亿参数同基座,性能提升全部来自后训练 Scaling(强化学习与 IndexShare、SAO、Slime 框架)。发布方公布 Z.ai Code Bench 较前代提升 50%、High 档准确率 31.4%,Terminal-Bench 3.0 / DeepSWE v1.1 / Agents Last Exam 三项均刷新开源模型纪录(2026-08-14 官方数据)。
要提醒的是,这些基准属于发布方自建,不是独立第三方评测结果,只能作为量级参考。正确做法是用你自己的任务集跑对照 eval,重点关注单任务 token 消耗与准确率两个维度。按官方口径,5 万 token 对 12 万 token,意味着同样的预算能跑 2 倍以上的任务,这是最值得验证的增量点。
接入后必跑的回归清单:工具调用、流式输出、长上下文截断、错误码与成本 delta
迁移不是改完参数就结束,下面这份清单建议逐项验收:
- [ ] 不带
thinking字段的普通请求,返回是否正常 - [ ] 分别用不传 thinking 与传 enabled 两种写法各发一次请求,确认均不报错
- [ ]
reasoning_effort三档(low/high/max)各跑一组,记录首 token 延迟与总 token 数 - [ ] 工具调用场景,检查
arguments解析是否完整、工具选择是否正确 - [ ] 流式输出分片中,推理内容与最终回答的边界是否清晰可辨
- [ ] 接近 1M 上下文的长输入,确认截断行为是否符合预期
- [ ] 超时与限流错误码分支是否已处理(建议参考 AI API 429 排查)
- [ ] 切换前后各跑 10 个典型任务,对比单请求 token 数与耗时,算成本 delta
这份清单能帮你在上线前发现绝大多数兼容性问题,避免把故障带到生产环境。
用同一套 OpenAI 兼容代码在多模型间跑对照 eval
第三方平台适配排期不一,工程上更稳妥的做法是把 base_url 与 model 字段做成配置项,用统一的 OpenAI 兼容入口(如 NexAIX 的 https://api.nexaix.net/v1)在 GLM、DeepSeek、Kimi 等模型间跑同一份回归集,避免每换一个模型重写一次客户端。这样切换成本最低,也方便做横向对比。关于 OpenAI兼容API 的 model 迁移路径 可参考这篇实操笔记;在做成本评估时,AI API成本优化 也能帮你建立更细的预算模型。
提醒一句:上线前务必到 NexAIX 模型页与更新日志核对 GLM-5.3 的当前可用性、上下文规格与计费口径,发布日基准不代表长期承诺。
常见问题
GLM-5.3 thinking disabled 报错怎么解决?
把请求体里 thinking: {type: 'disabled'} 整段删掉,或改为 enabled。GLM-5.3 强制开启思考,旧值已废弃,不删必报参数异常。改完重启客户端,再用普通请求验证。
GLM-5.3 reasoning_effort 怎么设置?
三档:low 适合低延迟简单任务,high 适合常规编程与Agent,max 适合复杂推理。按场景路由,轻任务别用 max,否则 token 和延迟都上去了。官方未公布各档具体数值,建议实测后定策略。
GLM-5.2 换 GLM-5.3 要改哪些参数?
核心只改 model 字段为 glm-5.3,删掉 disabled 的 thinking 配置,并按需新增 reasoning_effort。其余 OpenAI 兼容字段基本不变,但你的解析逻辑要兼容推理内容分离返回。
GLM-5.3 支持 OpenAI 兼容接口吗?
支持,官方提供 OpenAI Chat Completions、Responses 和 Anthropic Messages 三种端点。存量 OpenAI SDK 用户改 base_url 和 model 即可,兼容性最好。
GLM-5.3 上下文和最大输出是多少?
官方开放文档显示支持 1M 上下文与 128K 最大输出。但实际输出长度还受 max_tokens 设置影响,长上下文输入要注意截断行为验证。
GLM-5.3 什么时候开源权重?
官方计划在完成安全加固后两周内开源,即约 2026 年 8 月 28 日前。第三方平台多在权重释放后上线自建节点,目前主要走官方 Coding Plan 通道。



评论(0)