 NexAIX-官方博客
2026 年 7 月 24 日,DeepSeek 正式停用了 deepseek-chat 与 deepseek-reasoner 两个历史 API 别名;一周后的 7 月 31 日,官方上线了 DeepSeek-V4-Flash-0731 公测版,并宣布其原生支持 Responses API。对于所有通过 OpenAI兼容API 接入生产环境的团队而言,这意味着调用链路上 model 参数必须同步更新,否则将遭遇 404 或 Invalid Model 错误。本文将这次变更拆解为一次典型的破坏性升级,从故障定位、配置收敛、接口形态取舍到回归验证,提供一条可执行的 OpenAI兼容API 迁移路径。
别名退役与 0731 公测:这次变更到底影响了谁
先明确时间线:7 月 24 日,deepseek-chat 和 deepseek-reasoner 两个历史别名正式从 DeepSeek API 中移除,官方要求开发者将其替换为 deepseek-v4-flash 与 deepseek-v4-pro。7 月 31 日,DeepSeek-V4-Flash-0731 公测版上线,官方称其在 Coding 与 Agent 任务上表现提升,并支持 Native Responses API 与 OpenAI Chat Completions 双协议。以上时间线与能力信息依据 DeepSeek 官方 API Change Log(2026-07-31)与 Developers Digest 的迁移报道(2026-07-25)。本文事实边界截至 2026 年 7 月,价格、上下文长度、限流与 benchmark 数值均未在文中给出。
受影响最直接的是三类调用路径:
- 使用 OpenAI SDK(如
openaiPython 包)并在model参数中硬编码deepseek-chat的代码; - 在 Agent 编排框架(如 LangChain、LlamaIndex 或自研框架)中,将
deepseek-reasoner绑定为推理模型的任务配置; - 依赖统一网关或中转层(如自建 One-API、Nginx 代理)统一改写模型名的团队,若网关内部仍映射旧别名,同样会中断。
无论哪类路径,本质都是 model 字符串失效,而非调用格式整体不兼容。下面从排查开始,一步步完成迁移。
先定位再动手:从错误码和返回体判断问题出在哪一层
接到线上告警时,先别急着改代码。根据返回的错误类型,快速定位故障层:
- 404 / Invalid Model:大概率是
model名未更新。例如请求deepseek-chat,返回体中通常会带有错误类型与错误信息字段,具体字段名与取值以 DeepSeek 官方文档为准(通用工程判断)。此时只需将model改为deepseek-v4-flash(或deepseek-v4-pro),base_url保持不变。 - 行为变化但请求成功:若原
deepseek-reasoner已映射到deepseek-v4-flash,且未配置推理参数,响应可能不再包含思考过程。需要显式设置reasoning_effort等参数(具体取值以官方文档为准),才能开启思考链。 - 请求格式不兼容:例如向 Chat Completions 接口发送了 Responses API 特有的结构,或反之。此类问题一般返回 4xx 并提示请求参数无法识别,具体文案以实际返回体为准。
一个实用技巧是检查响应体中的 model 字段:它回显的字符串能直接确认实际执行的是哪个模型。这比依赖日志里的请求参数更可靠。
第一步收敛:把硬编码 model 字符串变成一处可切换配置
在大多数团队中,model 字符串可能散落多处:业务代码里指定 deepseek-v4-flash,Agent 框架的工具调用节点又写了一份 deepseek-chat,网关配置还藏着旧映射。这种分散是迁移的隐形炸弹。
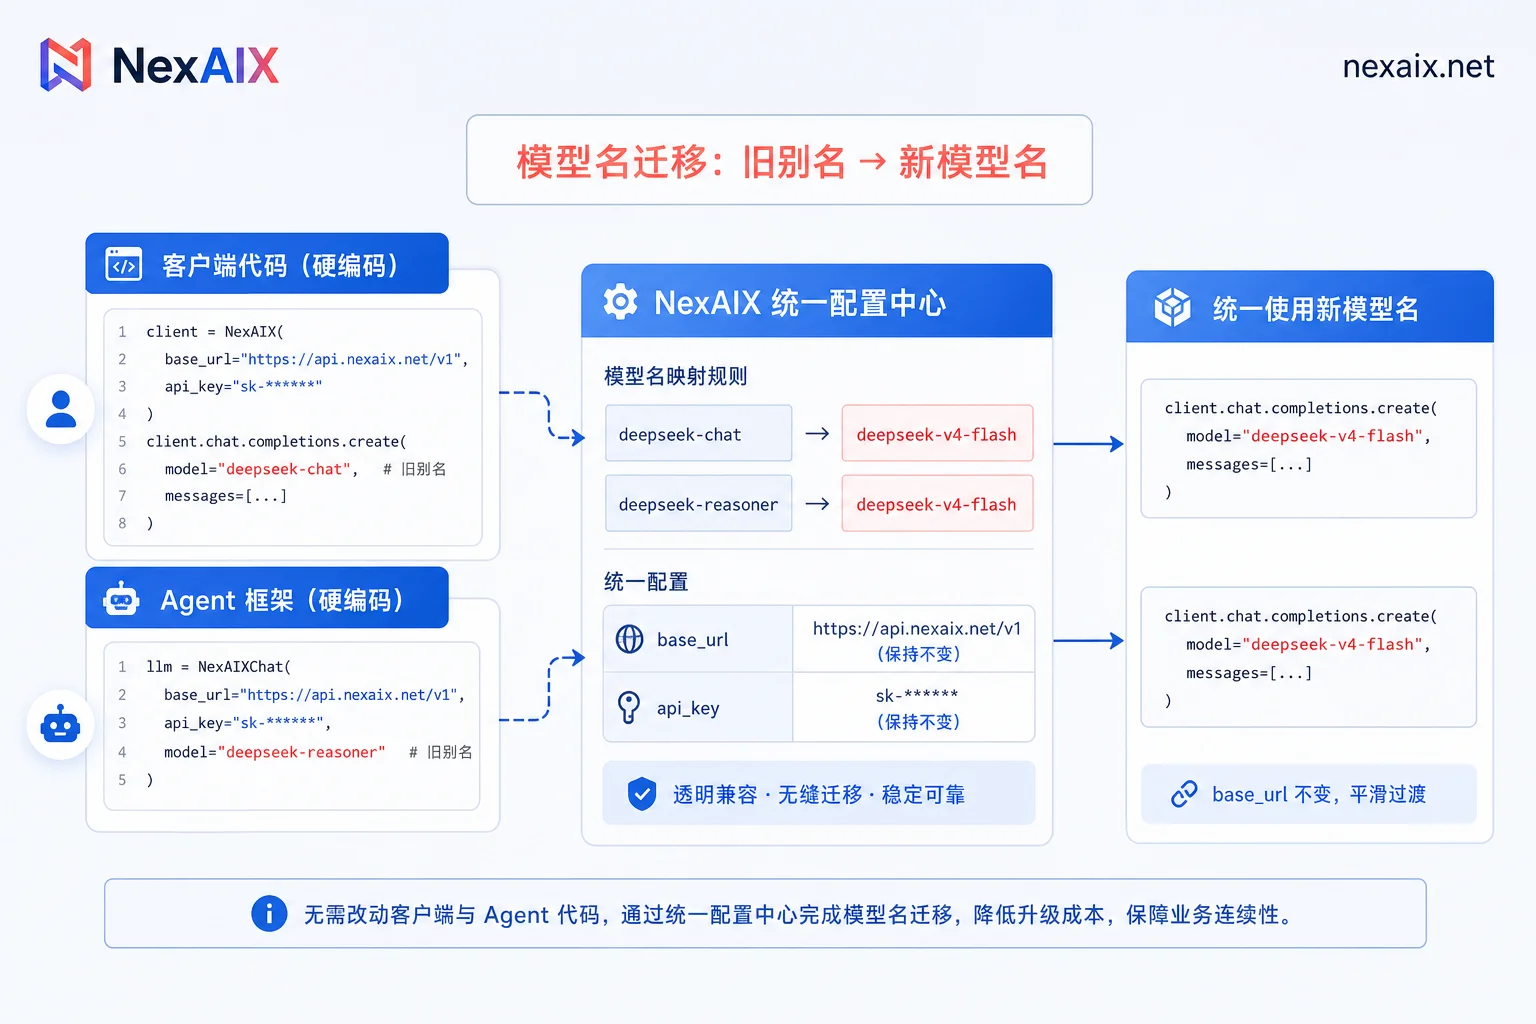
收敛方式很简单:将所有模型名替换为从环境变量或配置中心读取的单一变量,例如 DEEPSEEK_MODEL。在 Python 中,OpenAI SDK 的用法大致如下:
from openai import OpenAI
client = OpenAI(
    base_url=os.getenv("DEEPSEEK_BASE_URL", "https://api.deepseek.com"),  # 实际 base_url 以官方文档为准
    api_key=os.getenv("DEEPSEEK_API_KEY"),
)

response = client.chat.completions.create(
    model=os.getenv("DEEPSEEK_MODEL", "deepseek-v4-flash"),
    messages=[{"role": "user", "content": "Hello"}],
    stream=True,  # 根据需求开启流式
)
当别名退役这类变更发生时,你只需要在配置中心修改 DEEPSEEK_MODEL,所有依赖该变量的节点即可同步生效。
Chat Completions 还是 Native Responses API:调用形态取舍与保守迁移路径
DeepSeek 官方明确 V4-Flash-0731 原生支持 Responses API,同时兼容 OpenAI Chat Completions。除这一点外,本节其余内容均为通用工程判断。两者在消息结构、流式输出和工具调用组织方式上存在差异。
- Chat Completions:消息是
messages数组,每项含role和content;工具调用通过tools参数声明,响应中的tool_calls字段触发后续动作。 - Responses API:面向更结构化的多轮与工具调用状态组织,请求体结构与 Chat Completions 不同;具体字段名、参数与限制请以 DeepSeek 官方文档为准,本文不做字段级对照。
建议采取保守策略:先用 OpenAI Chat Completions 完成模型名迁移,把线上业务稳定下来,再单独开分支评估是否切换到 Native Responses API。理由在于:同时改 model 和接口协议会让故障定位变得困难——如果出错,到底是模型行为变化还是协议不匹配?分开迁移,每个阶段都有清晰的验证边界。
迁移后必跑的回归清单:工具调用、长上下文、延迟与成本 delta
迁移完成后,不能只测一个“hello world”。以下回归项必须使用你自己的真实流量样本,而不是官方示例。表中阈值为示例基线,属通用工程实践,请按你自己的业务容忍度替换,不代表官方推荐值。
| 回归项 | 判定标准 | 触发回滚条件 |
|---|---|---|
| 模型名生效性 | 返回体 model 字段等于配置值 | 返回旧模型名或报错 |
| 工具调用成功率 | 与迁移前基线相比无显著下降 | 成功率下降超 5% 或参数结构错误频发 |
| 推理开关 | reasoning_effort 参数生效 | 思考过程缺失或不符合预期 |
| 长上下文处理 | 截断长度与召回率不劣化 | 明显截断,关键信息丢失 |
| P50/P95 延迟 | 与迁移前对照,增幅在可接受范围 | P95 超时率上升 |
| 429 与重试行为 | 标准 429 响应,退避策略正常 | 静默丢弃请求或无限重试 |
| 成本 delta | 单位任务 token 消耗无明显异常 | 成本异常上涨 |
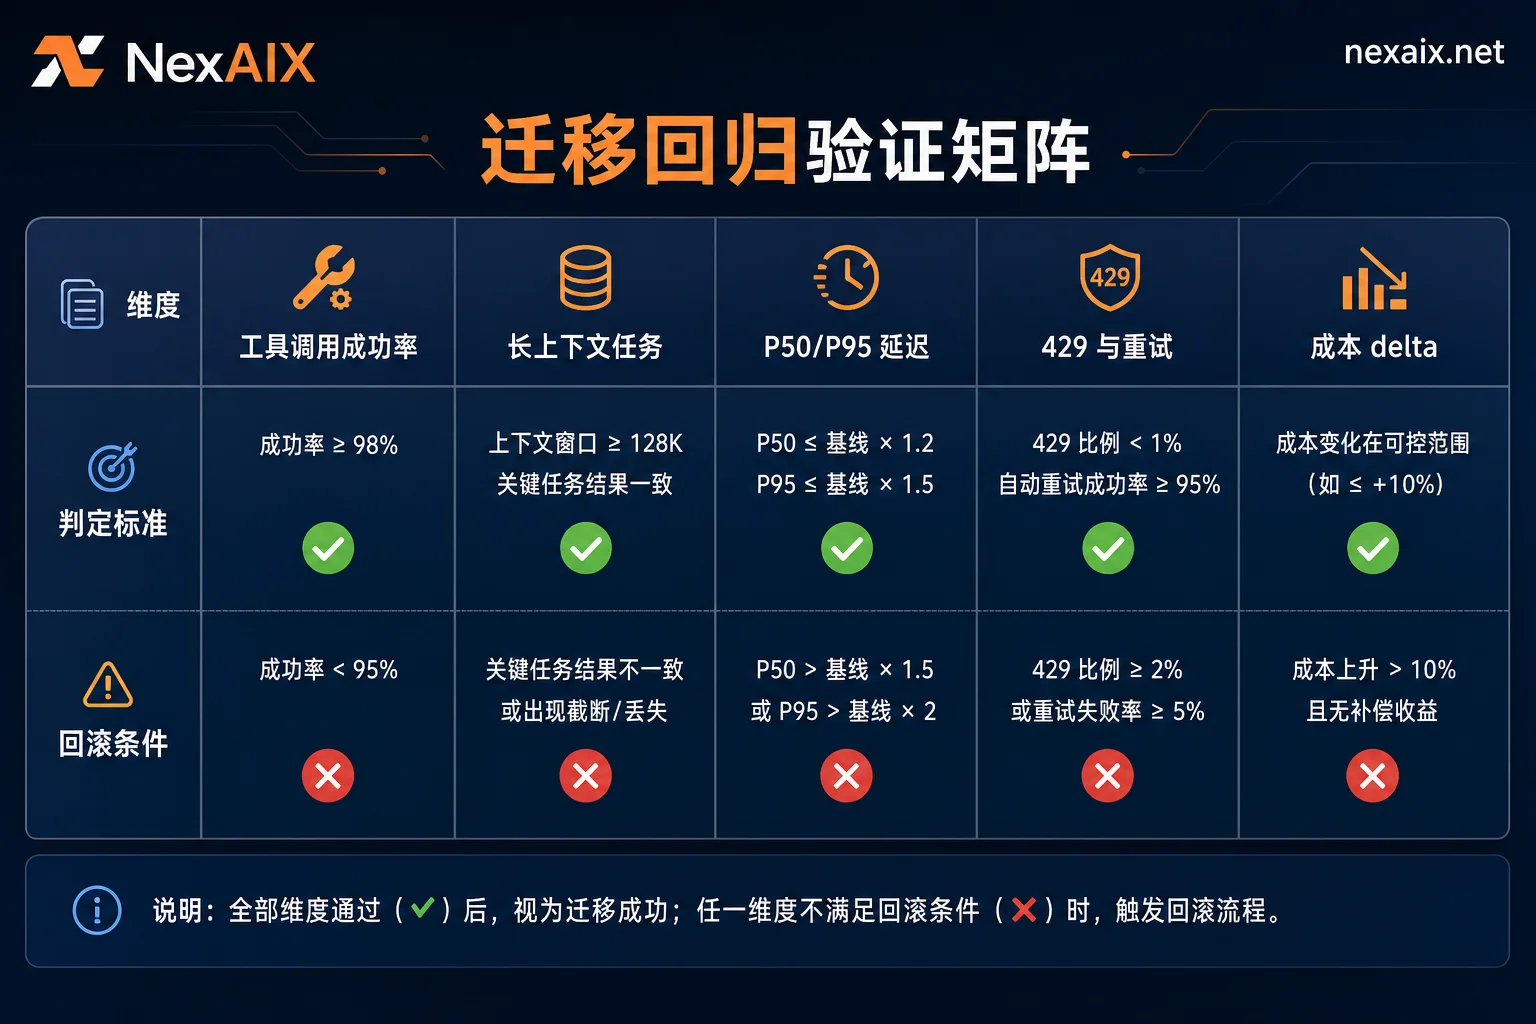
在跑回归时,注意观察 429 响应:如果网关在满载时静默切换更便宜或更慢的模型,你的延迟和成本数据都会失真。选择一个能明确回显实际执行 model 的接入方式,回归结论才可信。
用同一套 OpenAI兼容API 代码做新旧版本对照 eval
当你把迁移动作收敛成“只改一个 model 参数”后,新旧版本对照就变得异常轻松:同一份 eval 脚本,只需切换 model 值即可。这也是优先保留 OpenAI Chat Completions 兼容形态的实际收益:生态成熟、脚本可复用。
这里可以借助 NexAIX 的 OpenAI Chat Completions 兼容接口(base_url 为 https://api.nexaix.net/v1)。它支持流式输出与函数/工具调用,并能在返回体中回显实际执行的模型名,避免“你以为在调 A 实际是 B”的陷阱;在满载时返回标准 429 响应,不会静默降级到其他模型,这使得你的重试逻辑回归结论具备可信度。具体可用模型与规格,建议以 NexAIX 官网上的模型页、定价页和更新日志为准。
什么时候该切到公测版,什么时候该再等等
面对 V4-Flash-0731 公测版,决策框架如下:
- 适合切:你的场景是 Coding 或 Agent 任务,且公测版在离线 eval 中表现出明显优势;你可以设置 1-2 周观察期(示例参数,按业务风险自行设定),灰度比例从 5% 起步。
- 再等等:如果你的应用对延迟和稳定性极度敏感,或者没有足够的流量做灰度样本,建议等待 GA 版本再升级。
无论如何,都要设定明确回滚条件:工具调用成功率下降、P95 超时上升或成本异常,即改回迁移基线版本(即公测前你已验证过的正式版模型名)。注意,由于 deepseek-chat / deepseek-reasoner 已于 2026-07-24 退役,回滚目标不是旧别名,而是基线版本;回滚前需确认基线模型在自己的 eval 上有留存结果。关于 GA 状态与后续废弃计划,请持续关注官方 Changelog,不要根据传闻做出生产决策。
最后,给你两个具体行动建议:第一,把 model 名收敛成一处配置并跑完上面的回归清单;第二,若你希望用同一套脚本对照新旧版本,可前往 NexAIX 文档与模型页核对当前可用模型与接入方式,用测试额度先跑一轮离线 eval,再决定是否灰度。



评论(0)