 NexAIX-官方博客
如果你遇到的问题是“同一个模型名,换一家 API 表现就不一样”,或者“这家给的是开源模型还是闭源模型,有什么讲究”,可以先看一个判断:两种渠道的差别不在接口格式,而在推理由谁来跑。
- 开源权重模型 API:权重是公开的。服务方把模型下载下来,部署在自己的或托管的 GPU 集群上,用 vLLM、SGLang 这类推理引擎对外提供接口。用什么精度加载、上下文开多长、并发能撑多少、日志怎么处理,都由这个部署方决定。
- 闭源模型官方授权渠道:权重不公开,推理只能由原厂完成。渠道通过厂商官方接口或授权转接把请求送到原厂。模型的精度和行为由原厂负责,数据留存和限流按原厂的商业条款执行。
所以评估开源权重 API 时,要问的是部署方用了什么配置;评估闭源渠道时,要问的是请求是否真的走了官方,以及原厂条款怎么写。
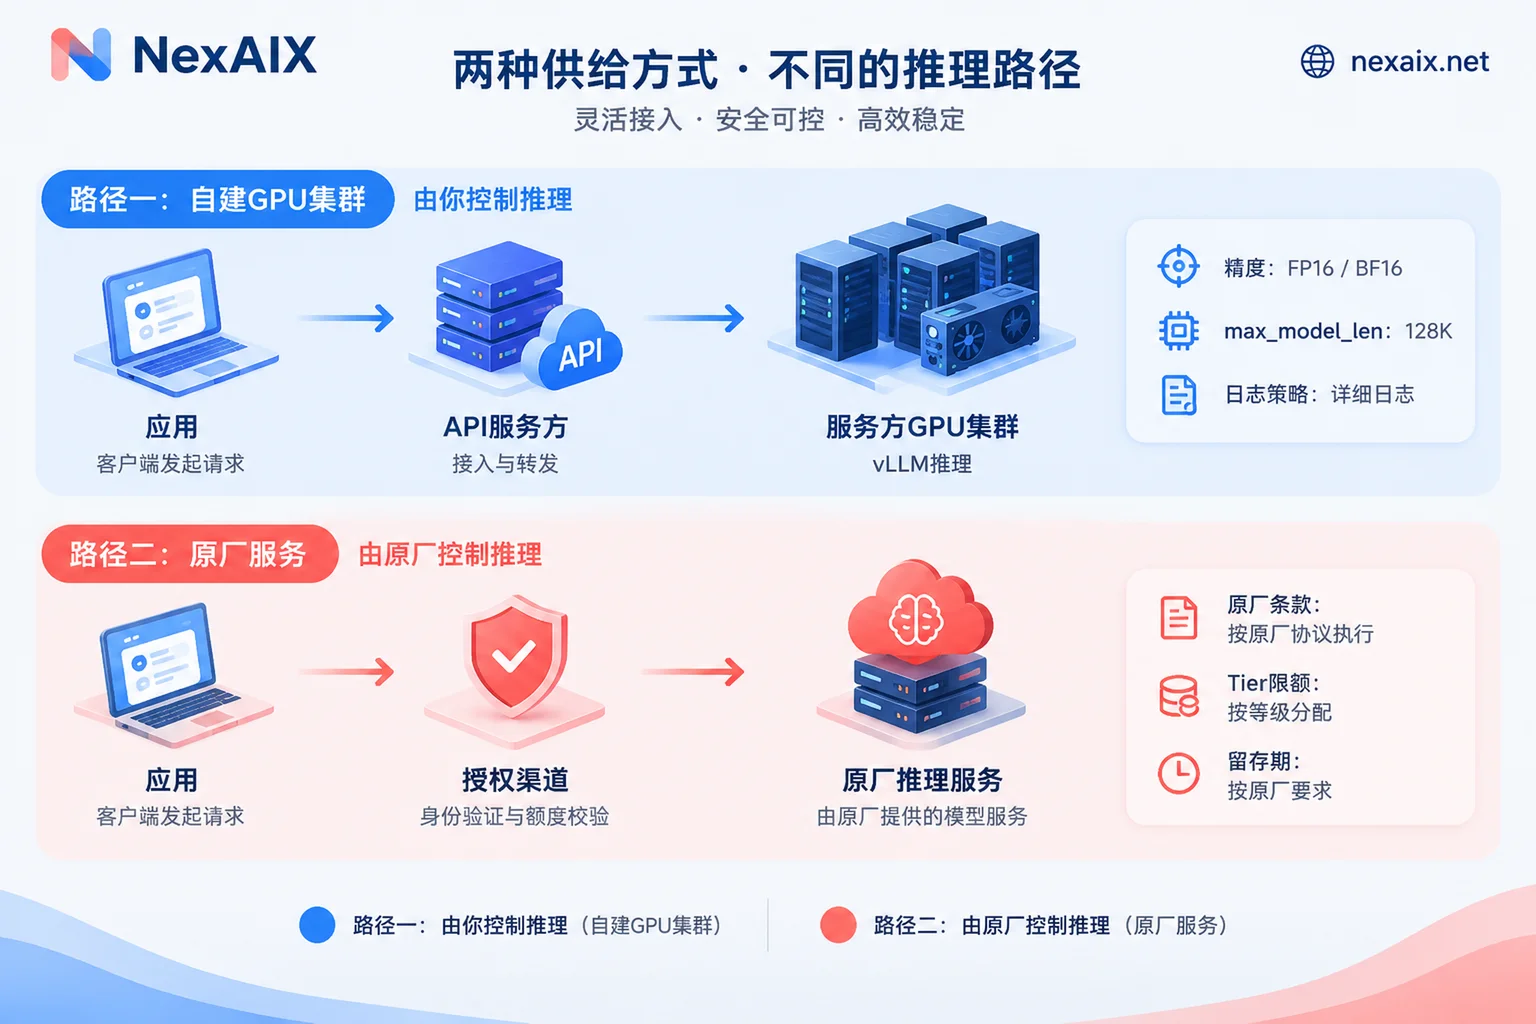
| 开源权重模型 API | 闭源模型官方授权渠道 | |
|---|---|---|
| 推理在哪里跑 | 服务方的 GPU 集群 | 原厂基础设施 |
| 精度由谁决定 | 部署方,可能做了量化 | 原厂,外部看不到 |
| 实际上下文上限 | 取决于部署参数和显存 | 按原厂声明 |
| 数据留存 | 部署方自己的策略 | 原厂条款,加上中间层自己的策略 |
| 限流与延迟 | 部署方的算力规模和调度能力 | 原厂分级限额 |
下面逐项说明这些差别会怎样影响你的调用。
精度:开源权重这一侧最容易出问题
同一个开源模型,可以用 BF16、FP8,也可以用 INT4、W4A16 这类低位量化格式加载。精度越低,占用的显存越少,单卡能承载的并发越多,部署成本也越低。部分部署方会为了压成本选择高损耗的低位量化,代价是复杂代码生成、多步逻辑推理这类任务可能出现数值不稳定。常见表现是长代码里出现细碎错误,或者推理链条中途走偏,而简单问答通常看不出差别。
保持原版权重(BF16,或原厂官方发布的 FP8 版本)需要更多显存,成本更高。接入开源权重 API 前,建议向服务方确认两件事:
- 推理时加载的是什么精度?
- 用的是不是原厂发布的权重,有没有换成更小参数量的版本?
闭源渠道这边,精度你看不到也调不了。不过推理由原厂自己完成,中间方没有办法把它换成低精度版本,前提是请求确实走了官方渠道。
BF16 和 FP8 在显存、速度和质量上的具体差别,可以看模型推理精度 BF16 和 FP8 有什么区别。想自己核对返回结果是不是原版模型,可以参考怎么确认 API 返回的是不是原版模型。
上下文:模型声明 128k,不代表你一定能用满 128k
长上下文要占用 KV Cache,而 KV Cache 要占用显存。以 vLLM 为例,最大上下文长度由 max_model_len 参数控制。如果物理显存撑不起模型声明的最大长度,部署方可能把这个参数调低,但对外仍写着原厂上限。这样一来,上下文就被悄悄缩水了:长文档请求会报超长错误,或者输入的一部分被截掉,模型只“看到”了后半段。
要保证完整上下文,部署方需要在集群里预留足够的显存。这也是成本,愿意承担这部分成本的服务方才会在承诺里写明不砍上下文。
自己核对的方法很直接:
- 构造一个接近声明上限的输入,看请求是正常完成还是报错。
- 对比响应里
usage.prompt_tokens和你本地估算的 token 数,差距过大就要追问原因。 - 如果问题出在输出被截断而不是输入,先看
finish_reason,排查步骤见大模型 API 输出被截断怎么办。
闭源模型的上下文上限按原厂文档执行,主要风险是你自己的请求超了限制,或者某个中间层做了额外的截断处理。
数据留存:两边的边界不一样
闭源官方渠道的请求最终会到达原厂,留存规则以原厂条款为准。按 OpenAI、Anthropic 公开的商业条款,API 数据默认不用于训练模型,但通常会保留一段时间(常见为 30 天左右)用于滥用审查和安全合规。部分企业客户可以单独申请零数据留存(Zero Data Retention)协议。条款会更新,正式评估时请以厂商当前版本为准。
这里有一个容易忽略的点:中间渠道承诺“不记录对话”,覆盖的只是它自己这一层。原厂那一层的留存,仍然按原厂条款执行。
开源权重 API 没有原厂这一层。部署方对数据流向有完全的控制权,技术上可以做到请求结束后即从内存释放、不落盘、不留日志。需要注意,“可以做到”不等于“已经做到”,还要看服务方是否明确承诺,以及有没有可以核对的地方。能查什么、查不到什么,见怎么验证 AI API 有没有记录对话内容。
限流与延迟:一边看原厂额度,一边看部署方算力
闭源渠道的调用遵循原厂按等级(Tier)划分的 RPM、TPM 限额,渠道能提供的总容量也受上游额度约束。超限时会收到 429 错误,需要在代码里处理退避重试。
开源权重 API 的并发能力和响应速度,取决于部署方的集群规模、网络拓扑,以及连续批处理(Continuous Batching)的调度水平。高并发、长文本场景下,首字延迟(TTFT)和每字延迟(TPOT)跟卡型和集群配置关系很大,目前没有一套通用的基准数字可以直接套用。比较可靠的做法是:先看服务方公开的配额和限速,再用你自己的真实请求形态(输入长度、并发数、是否流式)做一轮压测。
怎么选:按任务和约束来决定
- 任务依赖某个闭源模型的能力:只能走官方授权渠道,因为闭源权重第三方拿不到。如果有人声称能提供某个闭源模型,却说不清请求是否经过原厂,就要警惕。
- 对数据去向要求严格,又没有和原厂签零留存协议:可以优先考虑由明确承诺不留存的服务方部署的开源权重模型,这样请求不会经过第三方原厂。
- 长文档、长代码库分析:两边都可以用。选开源权重时,先按上面的方法核对实际可用的上下文长度。
- 调用量大、对成本敏感:开源权重模型通常更有弹性,但要确认低成本不是靠降低精度换来的。
- 生产环境需要稳定的吞吐:闭源渠道看原厂额度和你的等级;开源权重看服务方公开的限速,并自己压测。
在 NexAIX 上怎么区分
NexAIX 只有两种供给方式:开源权重模型部署在自有算力集群上,闭源模型走厂商官方授权渠道。每个模型页都标明了属于哪一种,选模型时可以先在模型清单里确认供给方式,再去对应的模型页查看规格。模型清单会变化,具体型号和价格以官网为准。
对应上面几个风险点,NexAIX 的做法是:不换小模型、不降精度、不砍上下文;不记录对话内容,请求结束即释放;配额与限速公开;按 API Key 隔离,每把 Key 有独立的配额、权限和用量账单。每条承诺怎么自己验证,写在四条承诺与验证方法里。需要提醒的是,调用闭源模型时请求仍会到达原厂,原厂那一层的留存按原厂条款执行。
接入方式两类模型相同,都使用 OpenAI 兼容端点 https://api.nexaix.net/v1。现有代码通常只需要改 base_url 和模型名,其他可能要检查的参数见换大模型 API 要改哪些代码。注册后会送测试额度,不需要企业资质,可以先用它把上面的上下文和精度核对跑一遍,再决定生产环境用哪个模型。接入文档和获取 API Key 的入口在官网导航栏。



评论(0)