 NexAIX-官方博客
在 LangChain 里换成自定义 base_url,只需要改模型对象的初始化参数,链、Agent 和 Prompt 都不用动:
- Python(langchain-openai):给
ChatOpenAI、OpenAI或OpenAIEmbeddings传base_url="https://你的端点/v1" - JS / TS(@langchain/openai):写在
configuration: { baseURL: "https://你的端点/v1" }里
这里的地址要以 /v1 结尾,不要写到 /chat/completions。大部分接入问题出在这个地址上,或者出在环境变量相互覆盖上。下面按写法、优先级、地址格式、流式统计和协议边界依次说明。
Python:直接传 base_url
安装 langchain-openai 后,最清楚的写法是在构造时把地址和 Key 一起传进去:
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="模型ID",                       # 用端点方提供的模型 ID
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ["NEXAIX_API_KEY"],
)

print(llm.invoke("用一句话回答:1+1 等于几?").content)
base_url 和旧参数名 openai_api_base 是同一个东西。老项目里写的是 openai_api_base=... 也能用,没必要为了这次迁移专门改名。如果你的 langchain-openai 版本比较旧,构造参数的命名可能和这里有出入,以你所用版本的参考文档为准。
Embedding 的写法相同:
from langchain_openai import OpenAIEmbeddings

emb = OpenAIEmbeddings(
    model="embedding模型ID",
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ["NEXAIX_API_KEY"],
)
前提是这个端点确实提供你要的 embedding 模型。对话模型和向量模型往往要分别确认,地址填对了不代表两类模型都有。
如果你用的是通用初始化函数 init_chat_model,base_url 同样作为关键字参数传入:
from langchain.chat_models import init_chat_model

llm = init_chat_model(
    "模型ID",
    model_provider="openai",
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ["NEXAIX_API_KEY"],
)
model_provider="openai" 的意思是按 OpenAI 协议去调用,跟模型由哪家提供无关。接任何 OpenAI 兼容端点都这样写。
以 NexAIX 为例
接 NexAIX 时,地址固定填 https://api.nexaix.net/v1,Key 用控制台生成的那一把,model 填模型页上标明的模型 ID。其余代码保持不变。模型清单会调整,每个模型属于开源权重自有算力部署还是闭源官方授权渠道,也在模型页上写明,开始写代码前先去 模型清单 核对一下要用的模型 ID。还没有 Key 的话,在官网导航「获取 API Key」注册,注册会送测试额度,可以先跑通上面那段最小示例。
不想改代码:用环境变量,但要清楚优先级
不在代码里写死地址,也可以靠环境变量切换。LangChain 确定 base_url 时按下面的顺序查找,前面的一旦有值,后面的就不再看:
- 代码里显式传入的
base_url(或openai_api_base) - 环境变量
OPENAI_API_BASE,由 LangChain 初始化时读取 - 环境变量
OPENAI_BASE_URL,由底层 openai 官方 SDK 读取
export OPENAI_API_KEY="你的Key"
export OPENAI_BASE_URL="https://api.nexaix.net/v1"
这个顺序会造成一个常见情况:你设置了 OPENAI_BASE_URL,请求却还是发到别的地址。原因通常是机器上、.env 文件里或 CI 配置里还留着一个 OPENAI_API_BASE,它的优先级更高,把你新设的值盖掉了。排查时把两个变量都打印出来看:
import os
print(os.getenv("OPENAI_API_BASE"), os.getenv("OPENAI_BASE_URL"))
两种方式各有适用场景:
- 显式传参:适合生产代码,读代码就能知道请求发到哪里,不受部署环境里残留变量的影响。
- 环境变量:适合同一份代码在开发、测试、生产环境之间切换不同端点。
建议选定一种,不要同时用。环境变量里的 OPENAI_API_KEY 还要跟着地址一起换。用自定义地址配官方 Key,或者反过来,都会返回 401。Key 在不同环境里怎么存放和分发,可以参考 AI API Key 怎么拿、怎么存、怎么分。
base_url 必须带 /v1,但不能写到 /chat/completions
OpenAI SDK 和 LangChain 会自动在 base_url 后面拼接 /chat/completions、/embeddings 等子路径。所以只需要填到版本前缀为止:
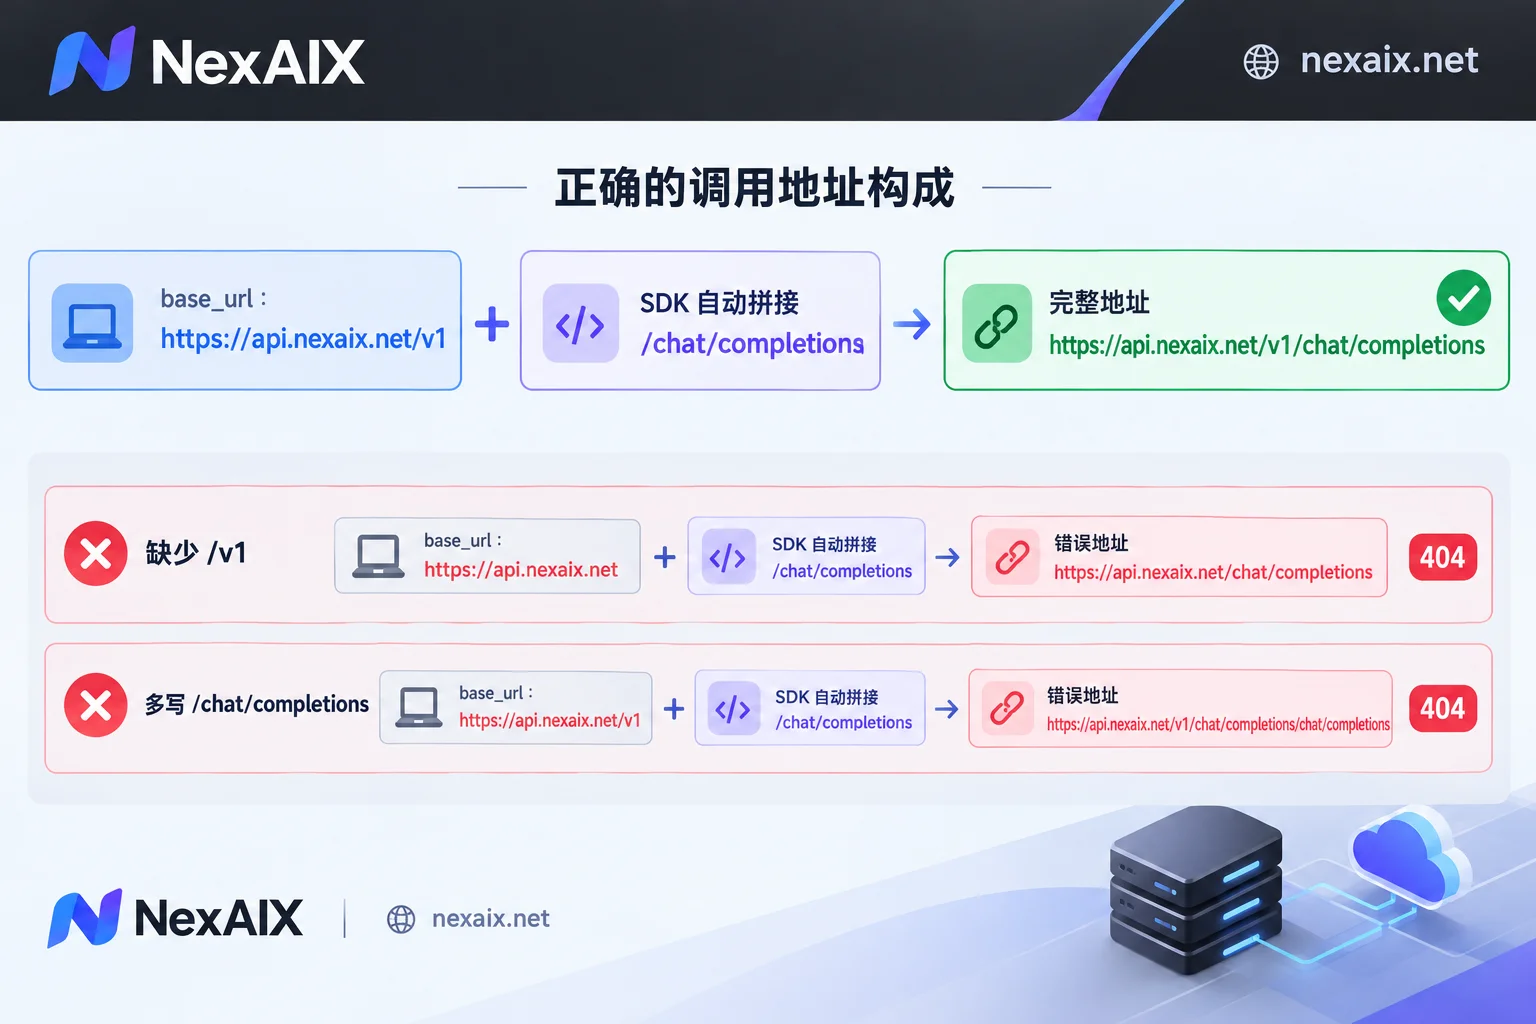
| 你填的 base_url | 实际请求的地址 | 结果 |
|---|---|---|
https://api.nexaix.net/v1 | .../v1/chat/completions | 正确 |
https://api.nexaix.net | .../chat/completions | 404 |
https://api.nexaix.net/v1/chat/completions | .../v1/chat/completions/chat/completions | 404 |
遇到 404,先把 SDK 实际请求的完整地址拼出来对照一下,大多数情况一眼就能看出问题。末尾多一个斜杠一般不会出错,但统一写成不带斜杠的形式更省心。Dify、One API 这类工具对 /v1 的处理规则和这里不完全相同,不要直接照搬,可以参考 Dify 添加 OpenAI 兼容模型 里的说明。
JS / TS:地址放在 configuration 里
@langchain/openai 的地址不在顶层参数里,而是作为底层 client 的配置项传入,写在 configuration.baseURL:
import { ChatOpenAI } from "@langchain/openai";

const llm = new ChatOpenAI({
  model: "模型ID",
  apiKey: process.env.NEXAIX_API_KEY,
  configuration: {
    baseURL: "https://api.nexaix.net/v1",
  },
});

const res = await llm.invoke("用一句话回答:1+1 等于几?");
console.log(res.content);
有两处容易写错:参数名是 baseURL,URL 三个字母都是大写,不是 Python 那样的 base_url;它必须放在 configuration 对象里面。如果写错位置,请求会悄悄发回默认地址,看到的报错通常是 Key 无效。如果你还会在 Node 里直接用 openai SDK,可以对照 Node.js 调用 AI API。
改完地址后,流式输出的 token 用量变成空的
这是 LangChain 的默认行为,不是端点出了问题。很多非官方端点在流式返回中不带 token usage,所以 LangChain 发现你用的是自定义地址时(例如读取到了 OPENAI_BASE_URL),会默认关闭流式用量统计 stream_usage。
如果你接的服务支持在流式响应里返回用量,需要手动打开:
llm = ChatOpenAI(
    model="模型ID",
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ["NEXAIX_API_KEY"],
    stream_options={"include_usage": True},
)
这个参数在不同版本里的写法可能略有差别,以你所用版本的文档为准。如果打开后用量仍然为空,说明端点本身没有在流式响应里返回 usage。这种情况下要统计成本,可以改用非流式调用拿用量,或者到服务方控制台查看按 Key 统计的用量。
ChatOpenAI 只处理 OpenAI 标准协议里的字段
ChatOpenAI 按 OpenAI 官方接口协议解析响应。第三方模型额外返回的非标准字段,比如部分思考模型的 reasoning_content,不会被自动提取出来。表现为请求成功、正文也有,但思考内容读不到。
只需要最终回答的话,不用处理这个问题。如果业务确实要用思维链字段,就要换用该模型厂商对应的 LangChain 集成包,或者自己写一层适配去解析原始响应。地址改得再对,ChatOpenAI 也不会帮你解析这些字段。
改完之后按这个顺序验证
- 跑最小示例:用上面的
invoke发一句短问题,能拿到回答就说明地址、Key、模型 ID 三项都对了。 - 404:检查
/v1有没有漏掉、有没有多写/chat/completions;如果用的是环境变量,确认没有残留的OPENAI_API_BASE。 - 401:检查 Key 和地址是不是同一家的;JS 里检查
baseURL是否放在configuration里。 - 模型不存在:
model要和服务方提供的模型 ID 完全一致,大小写和连字符都要对上。 - 流式没有用量、思考内容缺失:分别对照前面两节。
这几步之外的错误码,比如 429 限流和 5xx,原因和处理方式可以查 AI API 错误码怎么看。最小示例跑通以后,把同一个 llm 对象传给原来的链或 Agent 就行,其余代码都不需要改。



评论(0)