 NexAIX-官方博客
先说结论:你没法在客户端直接证明对方服务器没有保存你的对话。 请求通过 HTTPS 发出后,TLS 在服务端终结。之后内容有没有写进网关日志、数据库或滥用监控存储,调用方看不到。抓包只能确认你发出了什么、发给了谁,确认不了对方存了什么。
能做的是另一类事:收集间接证据,缩小信任范围,并让敏感数据本来就不离开你的控制。下面按投入从小到大排列,可以组合使用。
先排除一个常见误判
很多人会这样测:在新会话里问模型「还记得我上次说了什么吗」,模型说不记得,就认为平台没有记录。
这个测试只能说明模型推理是无状态的,也就是 API 不会自动把上一次的上下文带进这一次。它说明不了网关或后端有没有把 Prompt 和 Completion 写进持久化日志,也说明不了这些内容有没有被用于滥用监控。「模型不记得」和「平台没保存」是两件事,第一件成立不能推出第二件。
第一步:看控制台和用量接口暴露了哪些字段
这是成本最低、信息量最大的一步。打开平台的调用记录、Request Logs 或用量查询接口,看单条请求下能看到哪些内容。
- 只有元数据:Request ID、模型名、时间戳、输入和输出 Token 数、延迟、状态码。这些是计费和运维需要的字段,承诺不记录对话的服务通常只保留这一层。
- 能看到 Prompt 或回复全文:说明服务端已经把对话明文持久化了,结论很明确。
要注意两点。第一,控制台不显示全文,只能说明这个界面没有暴露全文,不等于后台一定没有存。这条证据只能单向使用:看到全文可以确认有存储,看不到不能证明没有存储。第二,有些平台允许你自己开启「保存日志」或「调试记录」开关,检查时确认它处于关闭状态。
第二步:读数据政策,重点看默认值和例外条款
公开的数据政策是服务方的书面承诺。出了问题,这是追责依据。阅读时重点核对以下几项:
- 默认留存多久,用途是什么。 以 OpenAI 为例,官方 API 默认会把请求内容保留最多 30 天,用于滥用监控。只有符合条件的企业客户申请到零数据留存(ZDR)之后,才不再落盘保存内容。
- 零留存怎么开启,怎么确认已经生效。 Azure OpenAI 的做法是用
ContentLogging=false这类治理标志,确认滥用监控存储已经关闭。有可查询的状态标志,比只有一句口头承诺更可靠。 - 数据会不会用于训练,是否需要你主动选择退出。
- 经过几层。 使用中转服务时,你的请求可能先经过中转方,再到达模型供给方,每一层都有自己的留存规则。只核对中转方的政策还不够,还要弄清模型实际由谁提供推理。
了解官方端点的默认留存期之后,你才有参照判断某个中转服务的承诺比官方更严格、一样还是更宽松。
第三步:用金丝雀诱饵检测内容是否外泄
如果你需要的不只是政策承诺,而是实际证据,可以做金丝雀测试(Canary Token)。思路是在请求里放一段「一旦被人或程序取出来使用,就会触发告警」的诱饵。
具体做法:
- 准备只用于本次测试的诱饵。 常见的有三种:一个专用的 Webhook 或追踪链接,被访问就会记录来源;一个格式逼真、实际无效的唯一密钥,配合你对该格式的监控;一个专用邮箱地址,只要收到邮件就说明它被人拿走了。
- 每个被测服务使用不同的诱饵。 这样一旦触发,你就知道是哪条链路泄露的。
- 把诱饵放进正常的 Prompt。 例如把它写成配置示例或联系方式,让内容看起来像值得抓取的数据。系统提示词也可以用隐写方式嵌入诱饵,社区有 llm-canary 这类工具可以参考。
- 持续观察几周,不要只看一两天。 人工调阅日志或离线分析往往有延迟。
结果可以这样理解:诱饵被触发,就是数据被留存且被访问的强证据。 诱饵一直没被触发,只能说明在观察期内没有人或程序使用它,不能证明内容没有被存储。如果数据存下来却没人读,这个方法发现不了。
测试时不要用真实凭证当诱饵,也不要在诱饵里放任何真实业务数据。
第四步:先查自己这一侧
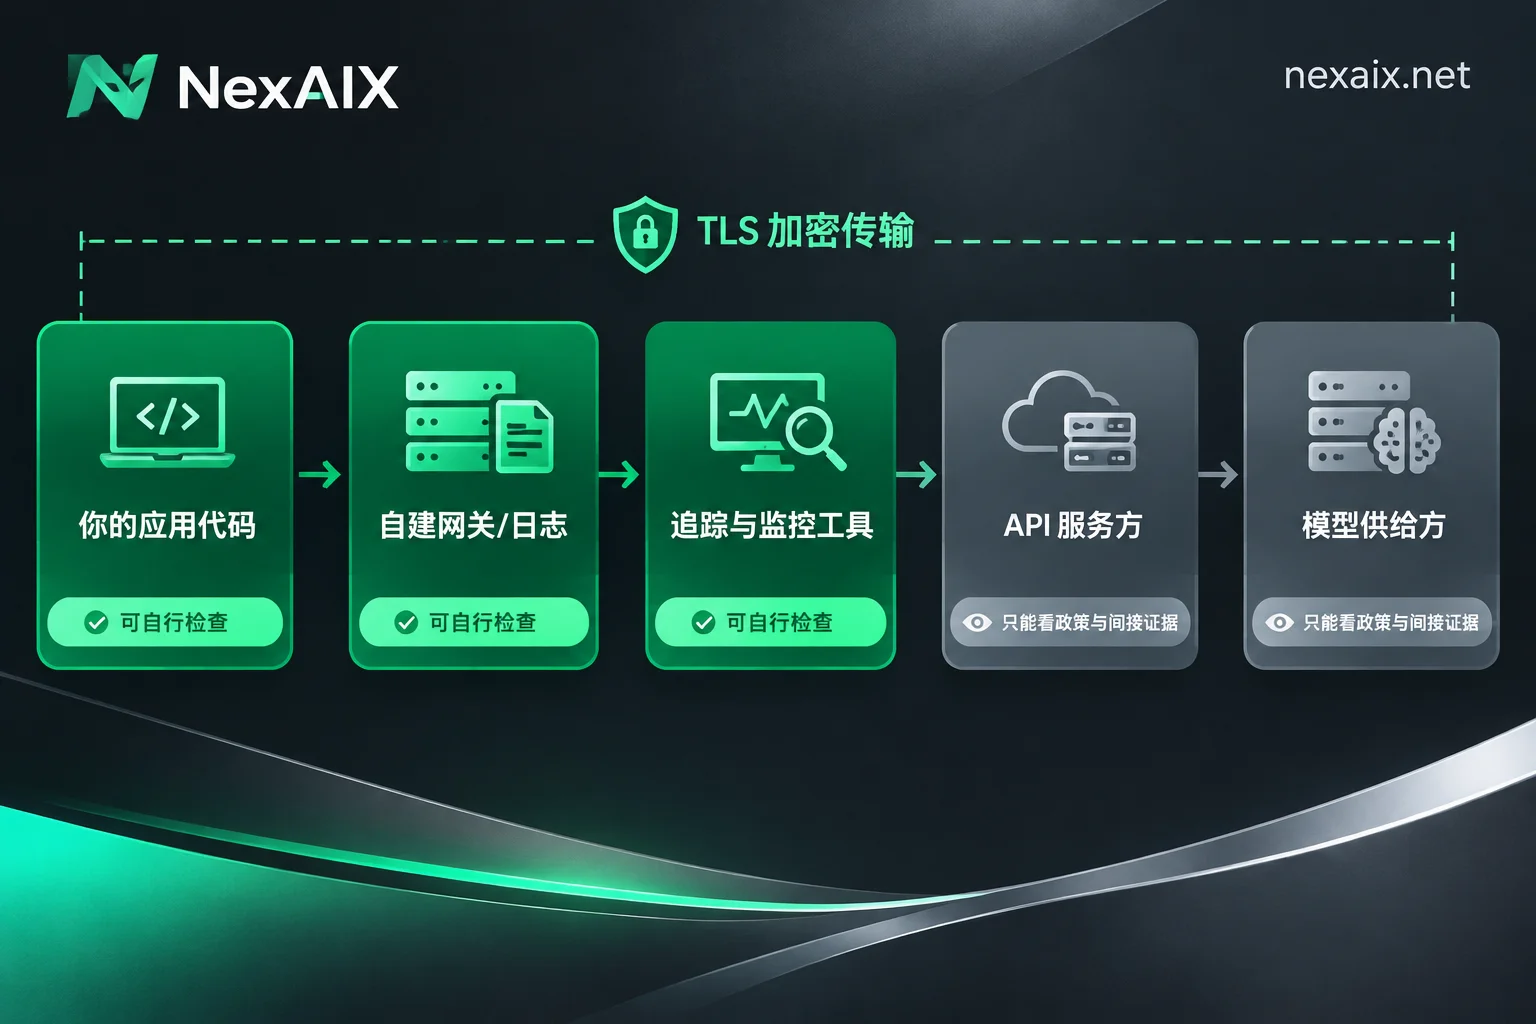
排查记录点时,很容易只盯着上游。实际上,对话明文常常保存在你自己的链路里:自建的 API 网关或转发层可能开着请求体日志;应用框架的追踪和调试功能可能会记录完整的 Prompt;可观测性工具、错误上报工具也可能把请求参数一起带走。
建议把一次请求从你的代码到外部端点经过的每一层列出来,逐一确认它记录了什么、保存多久、谁能看到。这部分你完全可以控制,也最容易检查清楚。
第五步:高敏感数据在出域前处理
既然服务端是否落盘无法从外部完全看清,处理核心敏感数据时,最稳妥的做法是不让它以明文离开你的边界:
- 在网关或客户端做脱敏或假名化。 发送前把姓名、手机号、证件号、密钥等实体替换成占位符,拿到返回结果后再在本地还原。模型通常不需要知道真实的手机号,也能完成摘要、分类或改写。
- 按数据敏感度分流。 涉及高敏感字段的任务,选择留存规则最清楚、链路最短的端点;一般内容再考虑其他选项。
- 用 Key 区分场景。 测试、生产和不同业务线分别使用独立的 Key。出问题时能快速定位范围,也方便单独轮换。可参考 AI API Key 怎么拿、怎么存、怎么分。
选端点或迁移时怎么用这些方法
如果你正在为一个对数据敏感的应用挑选或更换 API 端点,可以把前面几步整理成一张检查单:控制台只显示元数据吗?书面政策写明不记录对话吗?模型由谁提供推理?链路有几层?自己这一侧哪些地方会留下记录?
拿 NexAIX 来说,它的书面承诺是不记录对话内容,请求结束即释放,并且按 API Key 隔离,每把 Key 有独立的配额、权限和用量账单。模型的供给方式只有两种:开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道。每个模型页都标明了属于哪一种。对于走厂商渠道的模型,建议同时了解该厂商 API 自己的数据政策。四条承诺分别怎么核对,写在 NexAIX 的承诺与验证方法 页面里。注册送测试额度,你可以用上面的金丝雀方法和控制台检查自己验证一遍,不必只凭承诺做判断。
数据留存只是信任问题的一部分。如果你还担心模型被替换成小模型或被降级,可以接着看 怎么确认 API 返回的是不是原版模型。



评论(0)