 NexAIX-官方博客
AI API Key 用来证明“这次请求是谁发的、该记在谁的账上”。它同时承担身份认证、权限控制和用量计费三件事。Key 一旦落到别人手里,别人可以直接用你的额度。
结论先放在前面:
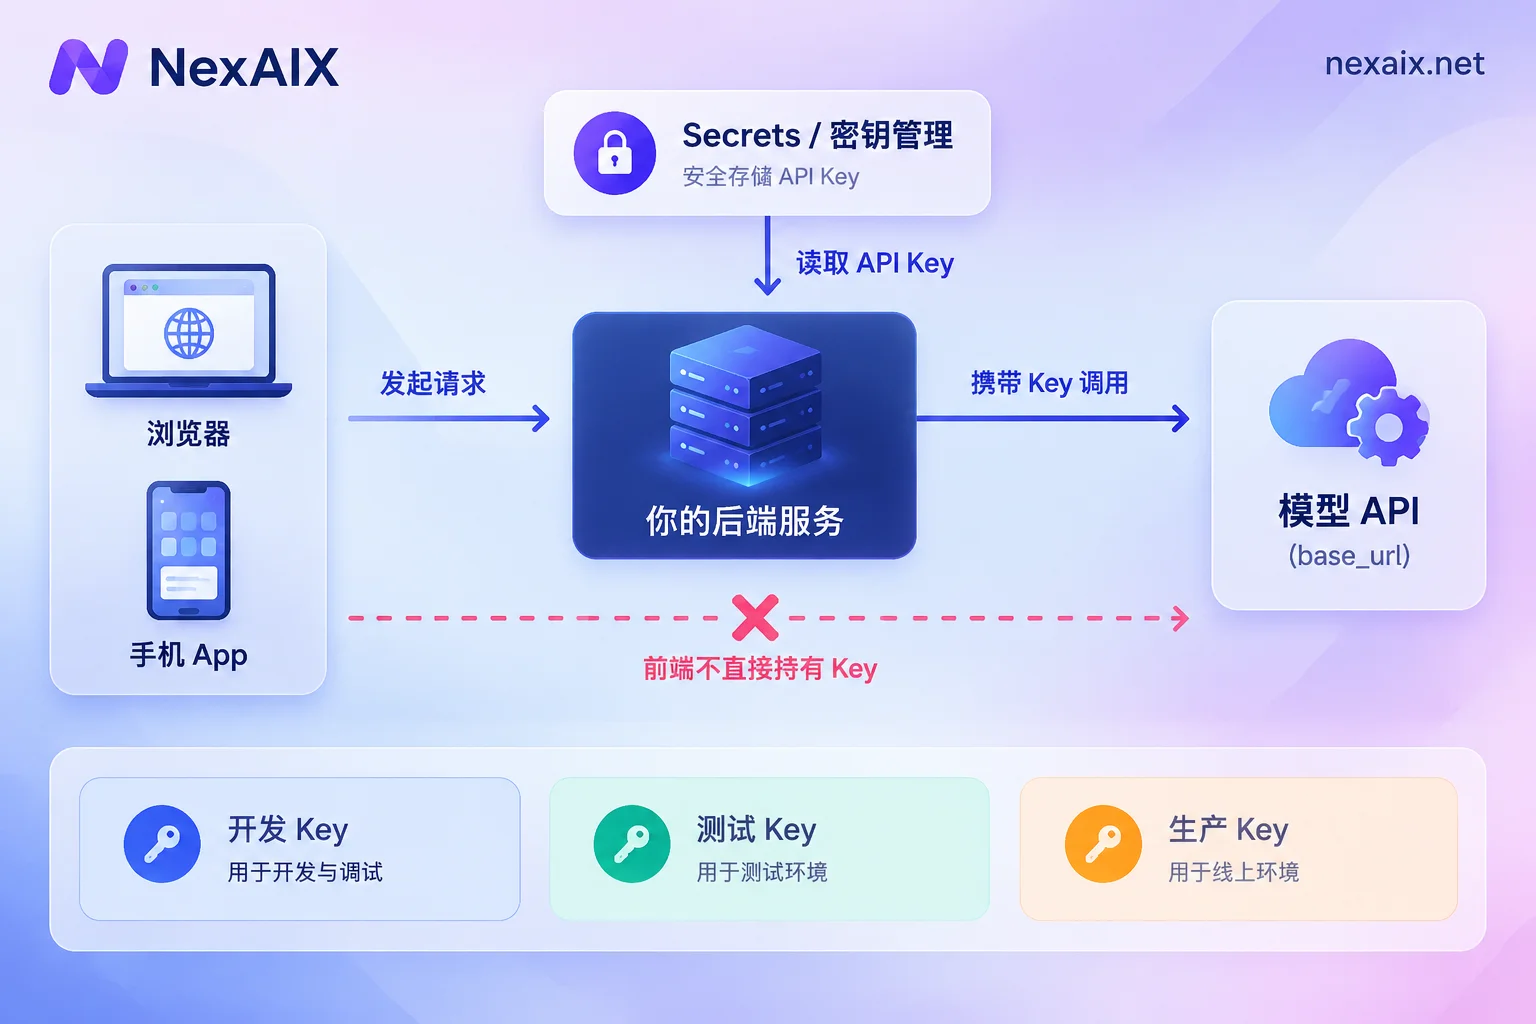
- Key 不写进代码,不进代码仓库,不下发到浏览器或手机 App。
- 本地开发用环境变量或
.env文件,并把.env加进.gitignore。生产环境用部署平台的 Secrets 或专门的密钥管理系统注入。 - 不同环境、不同业务各用一把 Key。哪把出了问题就单独吊销哪把,不影响其他服务。
- 发现泄露时先吊销,再查原因。
下面按拿到 Key 之后的实际顺序展开。
第一步:先定 Key 放在哪,再写代码
很多泄露发生在“先跑通再说”的阶段:Key 直接写在脚本里,跑通后顺手提交,仓库后来又被设成公开。OpenAI 的安全规范把这种做法列为明确禁止项,包括不要在客户端代码里硬编码,不要提交到 GitHub 这类公开仓库。
本地开发用环境变量就够了:
# macOS / Linux,写进 ~/.zshrc 或 ~/.bashrc
export NEXAIX_API_KEY="sk-..."
如果项目习惯用 .env 文件:
# .env
NEXAIX_API_KEY=sk-...
# .gitignore
.env这里有个容易漏掉的情况:.env 如果已经被提交过一次,之后再加进 .gitignore,它也不会从历史记录里消失。这种情况应当把 Key 当作已泄露处理,处置方法见后文。
生产环境最好不要往服务器上手动放 .env。容器平台、CI/CD 和云厂商都有 Secrets 或 Secret Manager,部署时把 Key 作为环境变量注入。这样 Key 不会出现在镜像、仓库或部署脚本里,权限也能单独管控。
前端和移动端:Key 只能留在服务器
网页里的 JavaScript、打包后的 App 都能被用户拆开查看,混淆也挡不住。如果你的产品需要在前端调用模型,正确的结构是:前端调用你自己的后端,后端拿 Key 去请求模型 API。这样做还有一个好处,你可以在后端按用户做频率限制,避免单个用户把整把 Key 的配额用光。
第二步:接入代码,只改 base_url 和 Key
目前很多模型服务都提供 OpenAI 兼容接口。接入时只需要给 SDK 配置两样东西:基础地址 base_url 和对应的 API Key,业务逻辑不用重写。
以 NexAIX 为例,端点是 https://api.nexaix.net/v1,从官方 OpenAI 接口迁移过来时只改这一行地址。模型名以模型页为准。模型清单上标明了每个模型的供给方式:开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道。选模型时可以一起确认。
Python:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["NEXAIX_API_KEY"],  # 没配置时直接报 KeyError,比静默传空值好排查
    base_url="https://api.nexaix.net/v1",
)

resp = client.chat.completions.create(
    model="<模型页上的模型名>",
    messages=[{"role": "user", "content": "ping"}],
)
print(resp.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.NEXAIX_API_KEY,
  baseURL: "https://api.nexaix.net/v1",
});
写代码之前,可以先用 curl 确认 Key 本身没问题:
curl https://api.nexaix.net/v1/chat/completions \
  -H "Authorization: Bearer $NEXAIX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"<模型页上的模型名>","messages":[{"role":"user","content":"ping"}]}'
如果返回 401,常见原因有:Key 复制时带了空格或换行,环境变量没在当前终端或进程里生效,Key 已被吊销,或者 Key 和 base_url 不是同一家服务的。最后一种在迁移时很常见:地址改了,读取的却还是旧服务的 Key。各状态码的具体排查方法可以看 AI API 错误码怎么看。
关于第三方客户端和框架:不同工具读取的环境变量名不一样。有的读 OPENAI_API_KEY 和 OPENAI_BASE_URL,有的要在设置界面里填。以工具自己的文档为准,不要假设它会自动读取你设定的变量名。
第三步:按环境和业务拆分 Key
一把 Key 用遍所有地方,平时省事,出了问题很难处理:账单分不清是哪个服务花的;测试脚本写出死循环,会把生产配额一起耗光;一旦泄露只能整体更换,所有服务同时受影响。
比较实用的拆法:
- 按环境:开发、测试、生产各一把。开发用的 Key 可以放宽管理,生产用的 Key 只放在 Secrets 里,人手上不留副本。
- 按业务或服务:客服机器人、内部知识库、批处理任务各一把。这样能看清每条业务的用量,限流时也不会互相挤占。
- 命名带上用途,比如
prod-support-bot、staging-batch。半年后打开控制台,还能分清哪把 Key 是干什么的。
NexAIX 按 Key 隔离,每把 Key 有独立的配额、权限和用量账单,按上面的方式拆分后,能直接看到每条线各用了多少。至于权限具体能细到什么程度,比如能否限定某把 Key 只调用特定模型,请以控制台当前提供的选项为准。
Key 泄露了:先吊销,再排查
常见的泄露迹象:用量突然上涨、出现不认识的调用时段、收到代码托管平台的密钥扫描告警。处理顺序如下:
- 立即吊销或删除这把 Key。 不要先去改代码或清理 Git 历史,Key 已经暴露,它每多有效一分钟,就多一分钟被盗用的可能。
- 新建一把 Key,写入 Secrets 或环境变量,重新部署相关服务。前面按服务拆过 Key 的话,只有这一个服务需要处理。
- 核对用量记录,确认异常调用从什么时候开始、用了多少。
- 找到泄露途径并堵上:被提交进仓库、写在日志里、出现在截图或工单里,还是在前端代码中被打包了出去。
- 如有需要再清理 Git 历史。注意,清理历史只能防止以后被看到,不能撤回已经被看到的内容,所以第 1 步不能省。
日志是容易被忽视的泄露途径。打印请求头、把完整的配置对象写进日志,或者错误上报工具自动收集请求信息,都可能把 Key 带出去。需要在日志里核对时,只输出 Key 的末几位。
定期轮换
即使没有发生泄露,生产用的 Key 也值得定期更换,离职交接、外包合作结束等节点尤其需要换。为了不中断服务,可以分三步:先建新 Key 并部署上线,确认流量已全部切到新 Key,再吊销旧 Key。生产服务只要从 Secrets 读取 Key,轮换时就只需要更新一处配置,再重新部署一次。
上线前快速自查
- 代码、镜像、仓库历史里搜不到 Key 明文
- 前端产物里没有 Key,所有模型调用都经过自己的后端
- 开发、测试、生产使用不同的 Key
- 日志和错误上报里不会出现完整的 Key
- 有人知道泄露时去哪里吊销 Key、谁来重新部署
这几项都确认后,再去处理限流、超时这类运行中的问题,例如参考 AI API 故障排查,按顺序定位 429、超时和截断。



评论(0)