 NexAIX-官方博客
接入一个兼容 OpenAI 协议的 AI API,要改的只有三样:服务地址(base_url)、API Key、模型名。SDK 不用换,业务代码基本不用动。多数接入失败出在地址多写或少写了一段路径,或者参数名大小写不对。
下面先讲地址怎么写,再按客户端给出配置,最后是上线前要补的流式、超时和限流处理。
base_url 写到 /v1 为止
OpenAI 官方 SDK 的工作方式是:你给一个基址,它在后面自动拼业务路径,比如 /chat/completions 或 /models。所以基址要满足两点:
- 保留版本路径,通常是
/v1 - 不带具体操作路径
以 NexAIX 的兼容端点为例:
| 写法 | 结果 |
|---|---|
https://api.nexaix.net/v1 | 正确 |
https://api.nexaix.net | 少了 /v1,路径对不上 |
https://api.nexaix.net/v1/chat/completions | SDK 再拼一次,变成 /chat/completions/chat/completions,返回 404 |
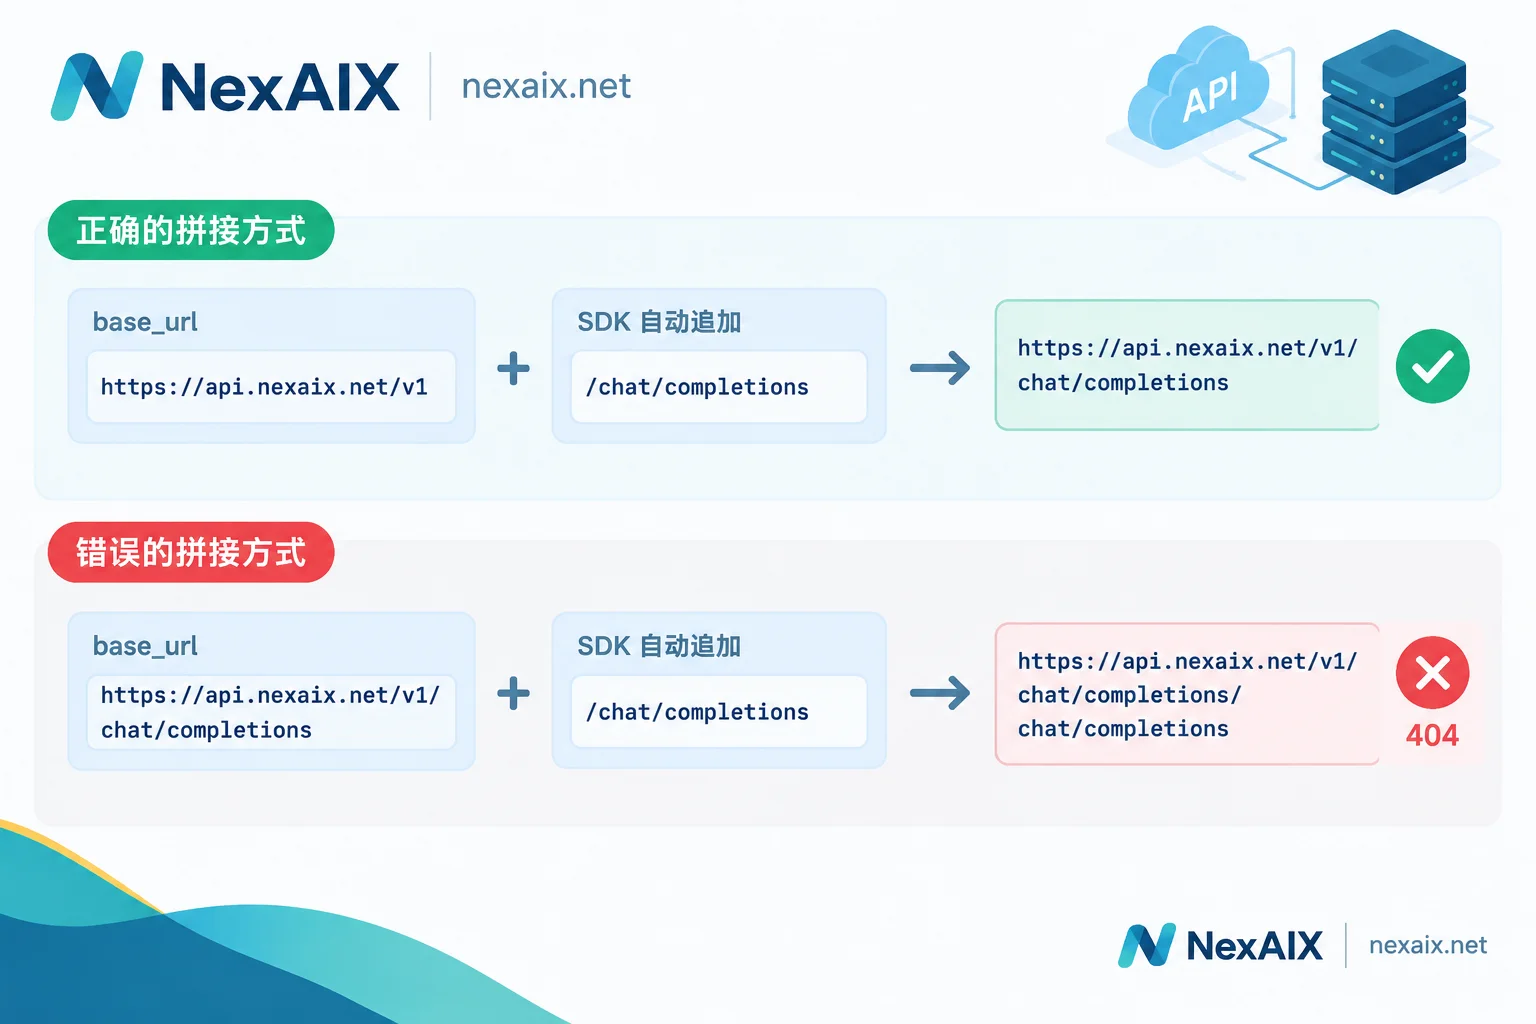
遇到 404 先查这一项。原生 HTTP 请求正好相反,需要自己把完整路径写全,后面会说到。
四种客户端的配置写法
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ["NEXAIX_API_KEY"],
)

resp = client.chat.completions.create(
    model="你在模型页选定的模型名",
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
)
print(resp.choices[0].message.content)
如果不想改代码,也可以设置环境变量 OPENAI_BASE_URL,SDK 会读取它作为基址。迁移现有项目时,这种方式可以不改代码。
Key 不要写进源码。从环境变量或密钥管理服务读取,开发、测试、生产各用一把,出问题时能单独停用。存放和分配的细节可以看 AI API Key 怎么拿、怎么存、怎么分。
Node.js / TypeScript
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nexaix.net/v1",
  apiKey: process.env.NEXAIX_API_KEY,
});

const resp = await client.chat.completions.create({
  model: "你在模型页选定的模型名",
  messages: [{ role: "user", content: "用一句话介绍你自己" }],
});
console.log(resp.choices[0].message.content);
注意参数名是小驼峰的 baseURL,不是 Python 里的 base_url。从 Python 示例照抄过来写成 base_url,配置不会生效,请求仍然发往默认地址,得到的通常是 401。这时该检查参数名,Key 多半没有问题。
LangChain
import os
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ["NEXAIX_API_KEY"],
    model="你在模型页选定的模型名",
)
print(llm.invoke("用一句话介绍你自己").content)
ChatOpenAI 接第三方兼容端点时,走的是标准 Chat Completions 协议,常规的对话、流式都能直接用。例外在非标准字段:有些模型会返回思考过程之类的扩展内容,这类字段不一定被 ChatOpenAI 解析出来,可能需要额外的适配参数或专门的组件。思考内容用哪个字段名返回,各家规范不同,使用带思考模式的模型前,先看服务方接入文档里的字段说明,再决定怎么解析。
原生 HTTP
curl https://api.nexaix.net/v1/chat/completions \
  -H "Authorization: Bearer $NEXAIX_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "你在模型页选定的模型名",
    "messages": [{"role": "user", "content": "用一句话介绍你自己"}]
  }'
不经过 SDK 时没有人替你拼路径,URL 要写完整,到 /chat/completions 为止。鉴权放在 Authorization 请求头,格式是 Bearer 加空格加 Key。
curl 也适合用来排查:SDK 调用报错时,用同一把 Key 和同一个模型名发一次 curl,能通就说明问题在客户端配置,不通再去看 Key、模型名和地址。
模型名从哪里来
模型名要和服务方提供的标识完全一致,写错或用了已下线的名字,请求就会被拒绝。模型清单会调整,不要从旧代码或别人的示例里抄。
用 NexAIX 的话,可以在 模型清单 里查当前可用的模型,每个模型页会标明供给方式:开源权重模型部署在自有算力集群,闭源模型走厂商官方授权渠道。规格以该模型的页面为准,Key 在官网导航的「获取 API Key」处申请,注册会送测试额度,可以先把上面的最小示例跑通。
上线前要补的三项配置
最小示例跑通以后,还要补上流式、超时和重试的配置,才能用于生产。
流式输出
stream = client.chat.completions.create(
    model="你在模型页选定的模型名",
    messages=[{"role": "user", "content": "写一段产品介绍"}],
    stream=True,
)

finish_reason = None
for chunk in stream:
    if not chunk.choices:
        continue
    choice = chunk.choices[0]
    if choice.delta.content:
        print(choice.delta.content, end="", flush=True)
    if choice.finish_reason:
        finish_reason = choice.finish_reason
流式响应按 SSE 协议一块一块返回,处理时注意两件事:
- 有些数据块的
choices为空,或者delta.content为空,直接取值会报错,要先判断。 - 连接可能中途断开。记录
finish_reason:循环结束时它仍为空,说明流没有正常结束;值为length则表示输出达到长度上限被截断。两种情况都不应把半截内容当成完整结果,按业务需要重试或提示用户。
如果中间有反向代理,还要确认它没有缓冲响应,否则内容会攒到最后一次性返回,流式就失去了作用。
超时
长文本生成和推理模型的响应时间可能很长,客户端超时设得太短会主动断开连接,表现为超时异常,而服务端其实还在生成。
client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ["NEXAIX_API_KEY"],
    timeout=120,      # 秒,按任务类型调整
    max_retries=3,
)
超时没有通用数值,按任务来定:短问答可以收紧,以便快速失败;长输出放宽,同时配合流式,让连接上持续有数据返回。如果调大客户端超时后仍然断开,问题可能在网关或代理层,逐段排查的方法见 AI API 超时怎么解决。
429 与重试
429 表示触发了限流。SDK 的 max_retries 会对这类错误自动重试,一般的波动靠它就能消化。批量任务或高并发场景下,建议在业务层再加一层指数退避:
import time, random
from openai import RateLimitError

def call_with_backoff(fn, max_attempts=5):
    for attempt in range(max_attempts):
        try:
            return fn()
        except RateLimitError:
            if attempt == max_attempts - 1:
                raise
time.sleep(min(2 ** attempt + random.random(), 30))- 等待时间逐次加倍,并加入随机抖动,避免多个进程同时重试。
- 只重试 429 和服务端临时错误。401、404 这类错误重试也不会成功,应该直接报出来修配置。
- 如果持续触发 429,说明并发超过了配额,需要降低并发或调整请求节奏,加重试次数解决不了。配额与限速的具体数值可在服务方公开的说明里查到,按它来设并发上限。
各状态码的含义和处理方式,可以对照 AI API 错误码怎么看。
接入后的自查顺序
请求不通时,按下面的顺序排查:
- 404:检查 base_url 是否到
/v1为止,有没有多写/chat/completions;再核对模型名。 - 401:检查 Key 是否读到了(环境变量名有没有写错),Node.js 里参数是不是
baseURL。 - 429:降低并发,确认重试带退避。
- 超时或断流:调大
timeout,长输出改用流式,检查代理层设置。 - 输出不完整:查看
finish_reason,区分长度截断和连接中断。
前两项是配置问题,改对就不会再出现;后三项与负载有关,需要在代码里长期保留处理逻辑。


评论(0)