 NexAIX-官方博客
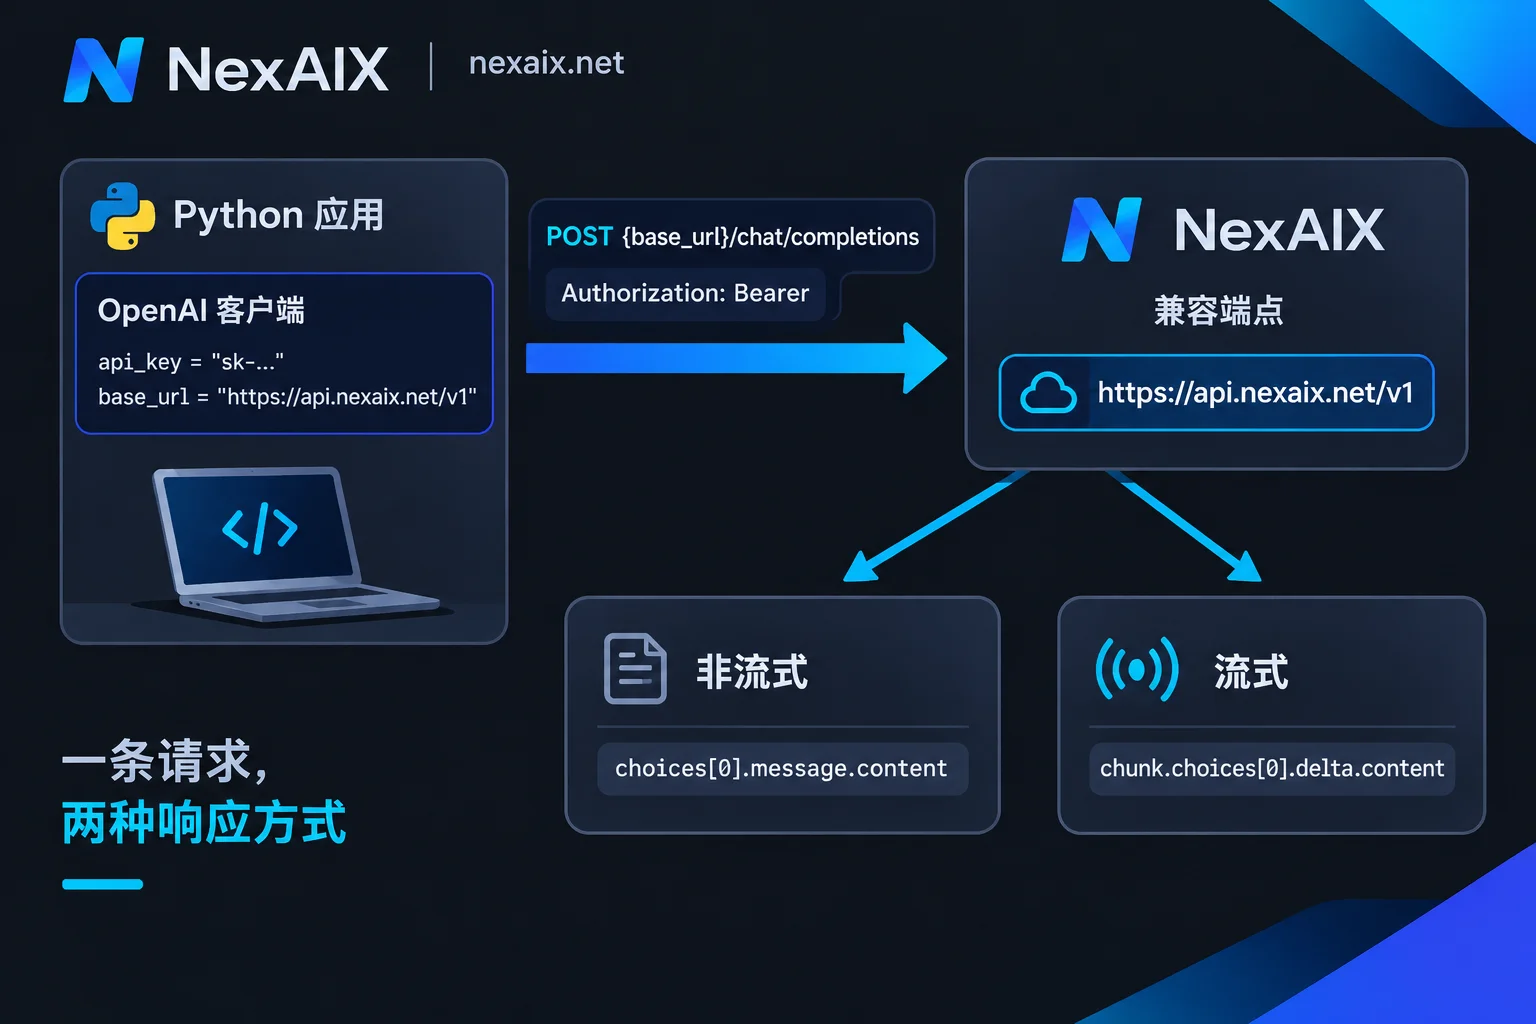
如果你调用的模型接口兼容 OpenAI 规范,用 Python 接入一般只需要三件事:装 openai 这个 SDK,创建客户端时传入 api_key 和 base_url,再调用 client.chat.completions.create。接口换成别家的兼容端点,业务代码通常不用动,改的只是 base_url、Key 和模型名。
下面按实际写代码的顺序展开:先跑通一次请求,再加流式输出,最后补上生产环境需要的超时和重试。
1. 安装 SDK,Key 放进环境变量
pip install --upgrade openai本文的写法基于 SDK 1.0 及以上版本。如果你在旧代码里看到 openai.ChatCompletion.create(...) 这种模块级调用,那是 0.x 的写法,新版本已经不支持,需要改成下面的客户端实例写法。
Key 不要写进代码。先在终端里设置环境变量:
export AI_API_KEY="你的 Key"
export AI_BASE_URL="https://api.nexaix.net/v1"
本地开发、测试和生产各用哪把 Key、Key 怎么存,可以看 AI API Key 怎么拿、怎么存、怎么分。
2. 初始化客户端:只改 base_url
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["AI_API_KEY"],
    base_url=os.environ["AI_BASE_URL"],
)
base_url 决定请求发到哪里。不传的话,SDK 会请求 OpenAI 官方地址;传入其他兼容端点后,这个客户端之后发出的 chat completions 请求都会到那个端点。
以 NexAIX 为例,端点是 https://api.nexaix.net/v1。从别的 OpenAI 兼容服务迁过来,代码改动就是这一行加上 Key。还要确认的是模型名:每家的模型 ID 写法不一定相同,直接沿用旧服务的名字,常见结果是 404 或模型不存在的报错。可调用的模型 ID 可以在 NexAIX 模型清单 里查。每个模型页都标明了供给方式:开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道。上下文长度等规格以对应模型页为准。
有两个容易出错的地方:
base_url一般要带/v1,末尾不要再加/chat/completions,这段路径由 SDK 自己拼。- 环境变量里如果残留了
OPENAI_BASE_URL,又没有显式传base_url,请求可能会发到你没预料到的地址。排查时先把客户端的配置打印出来看一眼。
3. 发起一次对话补全
resp = client.chat.completions.create(
    model="你在模型页查到的模型 ID",
    messages=[
        {"role": "system", "content": "你是一个简洁的技术助手。"},
        {"role": "user", "content": "用一句话解释什么是 HTTP 429。"},
    ],
)

print(resp.choices[0].message.content)
messages 是按顺序排列的对话记录。role 有三种:system 用来设定行为,user 是用户输入,assistant 是模型之前的回复。做多轮对话时,每次把历史消息连同新问题一起发过去。接口本身不会替你记住上下文。
跑通之后建议再看两个字段:
resp.choices[0].finish_reason:值是length说明输出被长度上限截断了,并不是模型主动结束。resp.usage:本次的输入和输出 token 数,用来估算成本和排查上下文过长。
回答写到一半就断了,或者历史消息越积越长导致报错,可以参考 模型上下文窗口对比 里输出上限和窗口的计算方法。
4. 流式输出:边生成边显示
做聊天界面或者长文本生成时,等完整结果返回会让用户等很久。加上 stream=True,SDK 会返回一个可迭代的流:
stream = client.chat.completions.create(
    model="你在模型页查到的模型 ID",
    messages=[{"role": "user", "content": "写一段 100 字的产品介绍。"}],
    stream=True,
)

for chunk in stream:
    if not chunk.choices:  # 有些块不带 choices,比如末尾的用量统计
        continue
    delta = chunk.choices[0].delta

    # 部分推理模型会把思考过程放在单独的字段里
    reasoning = getattr(delta, "reasoning_content", None)
    if reasoning:
        print(reasoning, end="", flush=True)

    if delta.content:
        print(delta.content, end="", flush=True)
要注意三点:
- 每个 chunk 里的
delta.content只是一个片段,可能是空值,拼接前先判断。 reasoning_content不属于所有模型的通用字段,只有一部分带思考链的模型(例如 DeepSeek-R1 这一类)会返回。用getattr读取,换了模型也不会报错。是否需要把思考过程展示给用户、是否要在多轮对话里回传,看具体模型的文档。- 流式模式下,超时的含义会变化:首个 token 来得慢,和中途长时间没有新数据,是两种不同的问题,排查方法也不一样。
5. 不用 SDK:requests / httpx 直接发请求
如果你的环境不方便装 SDK,或者想看到原始请求,可以直接 POST 到 {base_url}/chat/completions:
import os
import httpx

url = os.environ["AI_BASE_URL"].rstrip("/") + "/chat/completions"
headers = {
    "Authorization": f"Bearer {os.environ['AI_API_KEY']}",
    "Content-Type": "application/json",
}
payload = {
    "model": "你在模型页查到的模型 ID",
    "messages": [{"role": "user", "content": "你好"}],
}

r = httpx.post(url, headers=headers, json=payload, timeout=60)
r.raise_for_status()
print(r.json()["choices"][0]["message"]["content"])
Authorization 头里的 Bearer 和 Key 之间有一个空格,少了这个空格是 401 的常见原因。这种写法的重试、流式解析都要自己实现,所以除非有明确理由,一般还是用 SDK 更省事。
6. 生产环境:超时和重试要显式设置
能跑通和能稳定运行是两回事。上线前至少要把超时和重试写清楚:
import os
import openai
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["AI_API_KEY"],
    base_url=os.environ["AI_BASE_URL"],
    timeout=60.0,     # 单次请求超时(秒),长输出任务可以适当调大
    max_retries=3,    # SDK 内置重试,遇到连接错误、429、5xx 时会自动退避重试
)

try:
    resp = client.chat.completions.create(
        model="你在模型页查到的模型 ID",
        messages=[{"role": "user", "content": "你好"}],
    )
except openai.RateLimitError:
    # 429:重试几次后仍然超限,说明并发或速率超过了配额
    ...
except openai.APITimeoutError:
    # 超时:检查 timeout 是否太短、输出是否过长
    ...
except openai.APIStatusError as e:
    # 其他 HTTP 错误,e.status_code 可以区分 400/401/404/5xx
    print(e.status_code, e.response.text)
参数怎么取值,可以按下面的思路判断:
- timeout:短问答 30 到 60 秒通常够用;生成长文、调用推理模型时,非流式请求可能需要更长时间。如果耗时实在太长,更好的办法是改成流式。
- max_retries:重试只能应对瞬时抖动,解决不了持续超限。如果 429 一直出现,问题在于并发量超过了 Key 的限速,应该在调用侧做排队或限流,而不是继续加大重试次数。NexAIX 的配额与限速是公开的,每把 Key 有独立的配额和用量,可以按 Key 的限额来设置并发。
- 400、401、404 不要重试:这几种错误分别是参数、Key、路径或模型名有问题,重试多少次结果都一样。
各个错误码的具体原因和处理方法见 AI API 错误码怎么看。超时的问题出在客户端、网关还是模型侧,可以按 AI API 超时怎么解决 的步骤逐段排查。
接下来
照着上面的步骤,你应该已经有一个可以复用的客户端:Key 从环境变量读取,base_url 指向目标端点,普通调用和流式调用都能用,超时和重试也做了显式配置。还没有 Key 的话,可以在 NexAIX 官网导航的「获取 API Key」注册,注册后有测试额度,用来跑通本文的示例。如果还没决定用哪个模型,先到 模型清单 按任务类型和供给方式挑选。Node.js、LangChain 等其他客户端的配置方法,见 AI API 接入教程。



评论(0)