 NexAIX-官方博客
OpenAI 兼容接口的含义其实很朴素:服务端照着 OpenAI 的 REST 规范把同一套路径实现了一遍,/chat/completions 还是那个 /chat/completions,请求体字段也基本一致。所以「怎么用」的答案是——你原来那套代码不用重写,换两个东西就行:
base_url(基础地址,部分 SDK 里写成baseURL)api_key
model 那一项按目标服务提供的模型名填,messages、temperature、stream、max_tokens 这些继续照旧。真正容易踩坑的只有一处:base_url 要填到哪一层。
base_url 填到版本号为止
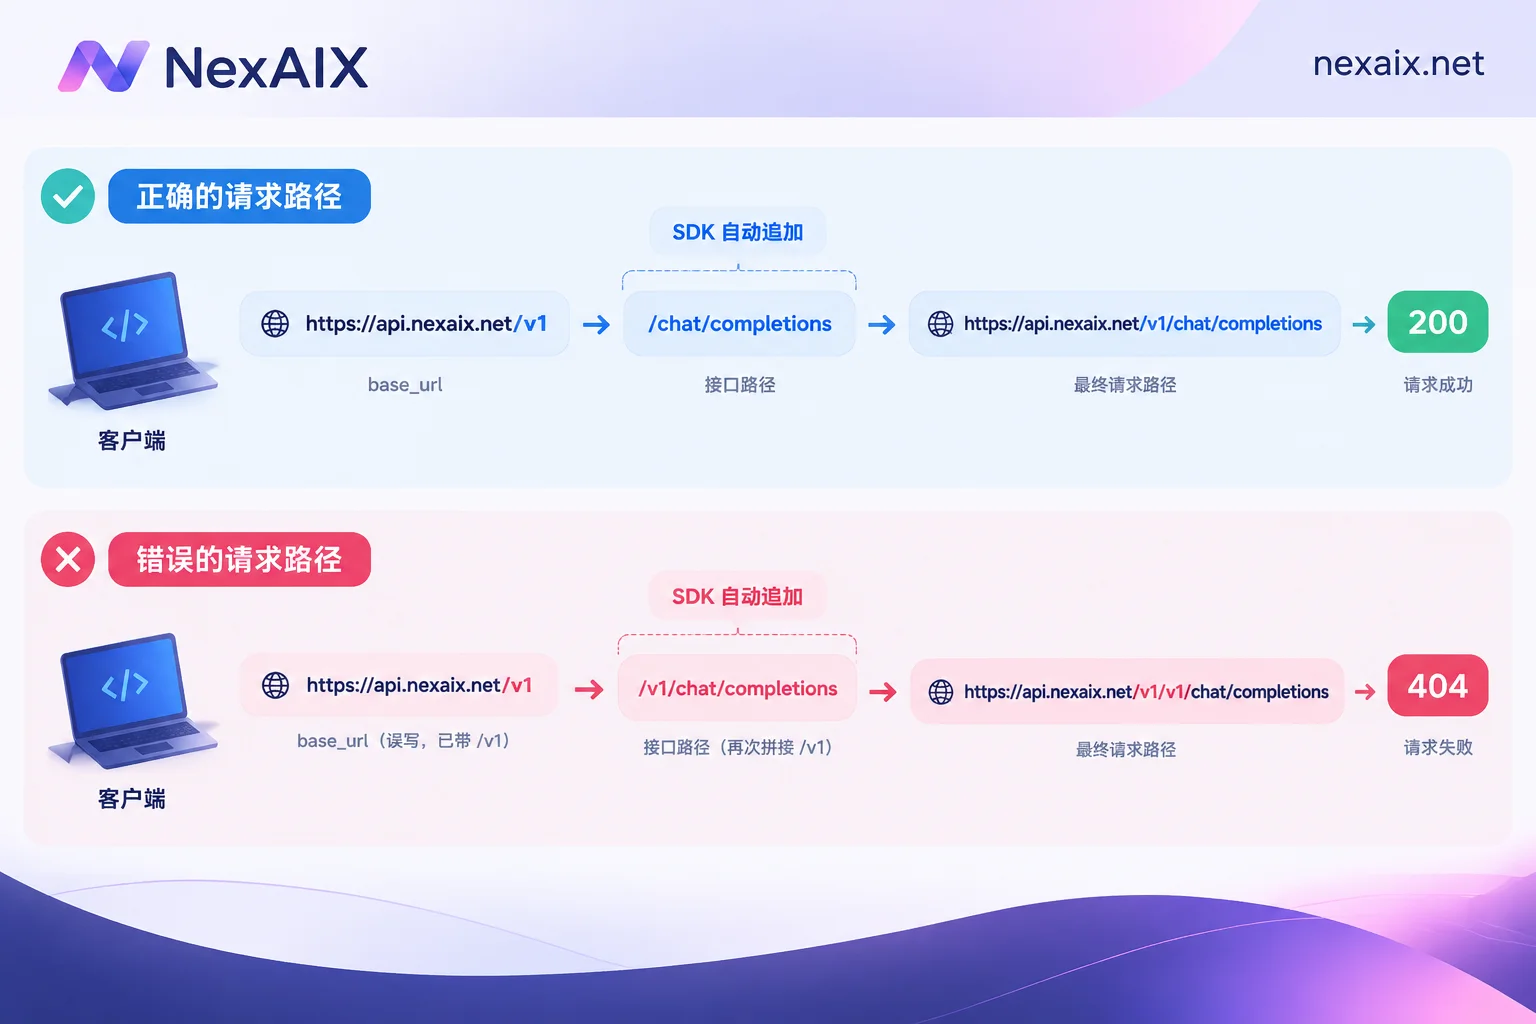
先记住一条规则:SDK 会在 base_url 后面自己追加子路径(比如 /chat/completions),所以 base_url 写到版本号就够了。
以 NexAIX 为例,兼容端点是 https://api.nexaix.net/v1,那么:
base_url  = https://api.nexaix.net/v1
实际请求  = https://api.nexaix.net/v1/chat/completions
不要自己再拼一次 chat/completions,也不要写成 /v1/v1。反过来说,漏掉 /v1 也常见——有些工具会替你补,有些不会,这就是很多人「同一个 Key,网页版能用、代码里 404」的原因。
Python:官方 SDK 的写法
openai 的 Python SDK(v1.0 之后)在实例化客户端时传 base_url:
from openai import OpenAI

client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key="你的 API Key",
)

resp = client.chat.completions.create(
    model="你的模型名",
    messages=[{"role": "user", "content": "你好"}],
)
print(resp.choices[0].message.content)
不想改代码的,可以走环境变量:设好 OPENAI_BASE_URL 和 OPENAI_API_KEY 之后,OpenAI() 直接初始化就生效。这招在容器和 CI 里特别省事——代码里只留 OpenAI(),环境不同就换环境变量。
流式输出加 stream=True,然后逐块取增量内容:
for chunk in client.chat.completions.create(..., stream=True):
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
注意 delta.content 可能是 None(例如只有角色信息的首块),判断一下再取。
Node.js:注意驼峰命名
openai-node 里参数叫 baseURL,不是 base_url,大小写写错会静默失效、回落到官方地址:
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://api.nexaix.net/v1",
  apiKey: process.env.API_KEY,
});

const resp = await client.chat.completions.create({
  model: "你的模型名",
  messages: [{ role: "user", content: "你好" }],
});
原生 HTTP / cURL:自己拼路径
不用 SDK 时,完整地址就是 base_url + /chat/completions,必须 POST,两个请求头不能少:
curl https://api.nexaix.net/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $API_KEY" \
  -d '{
    "model": "你的模型名",
    "messages": [{"role": "user", "content": "你好"}],
    "stream": false
  }'
要列可选模型,用 GET {base_url}/models 更稳妥,比对着文档抄模型名可靠。
框架:LangChain 的解析顺序
langchain_openai.ChatOpenAI 同样吃 base_url 和 api_key 参数:
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(model="你的模型名", base_url="https://api.nexaix.net/v1", api_key="...")
它解析自定义端点的优先级是:显式传入的 base_url > 环境变量 OPENAI_API_BASE > 环境变量 OPENAI_BASE_URL。两个环境变量名字接近,混着设容易出现「本地对、线上不生效」,建议只保留一个,或者干脆在代码里写死。
另一个细节:框架在识别到非官方 base_url 时,对流式用量统计的默认策略可能不一样,stream_usage 类参数未必拿得到 token 数。如果你要靠 token 计费或做预算控制,别只依赖框架的流式统计,读响应里的 usage 字段更实在。
四个高频报错,按这个顺序查
404 Not Found — 九成是路径拼接问题,不是权限问题。把完整请求路径打出来比对:/v1/v1/chat/completions 说明 base_url 多写了 /v1;/chat/completions(缺版本段)说明少写了。最快的办法是用同一条 cURL 试一次,能通就说明是 SDK 配置层的问题。
401 Unauthorized — Key 无效,或者值里带了首尾空格、换行,或者请求头漏了 Bearer 前缀(注意后面那个空格)。从环境变量读 Key 尤其容易带进换行。
模型不存在 / 报模型无效 — model 参数要严格匹配服务端提供的名字,大小写和版本后缀都算。先打 GET /models 拿准确列表。
流式没反应或解析报错 — 流式返回的是 SSE,一行一个 data: {...},最后一行是 data: [DONE]。别把整个响应体一次性丢给 json.loads,也不要漏掉 [DONE] 这个结束标志,否则要么解析失败,要么循环停不下来。
错误码的分层处理可以再细一点:400、401 这类改代码就能解决的不该重试;429 和 5xx 才适合退避重试。
换端点之后,生产上还要确认的事
能跑通和能上线是两件事。迁移时建议把这几个点过一遍:
- 超时与重试:默认超时时间往往偏长,生产里应显式设置,并对 429、5xx 做带退避的重试;对上层的幂等设计也要考虑重复请求的代价。
- 并发与限流:提前搞清楚目标端点的 RPM/TPM 口径,压测出稳定的并发上限,再决定是排队还是降级。
- 上下文与截断:换模型可能意味着上下文窗口和最大输出变了,长文档任务要重新算输入长度,避免被静默截断。
- 行为是否一致:同一个 prompt 在新旧端点上的输出风格、拒答倾向、结构化输出能力都可能不同,用固定测试集比对一遍比看文档更有用。
- Key 的隔离:开发、测试、生产别共用一把 Key,出问题时才好定位,用量和账单也能分开看。
从哪开始
如果你手上还没有可用的端点和 Key,思路是反过来的:先定任务需要什么模型,再看这个模型是哪一类供给。NexAIX 的模型清单每个模型页都标明供给方式——开源权重模型跑在自有算力集群上,闭源模型走厂商官方授权渠道,这一点会直接影响你对稳定性、上下文和响应风格的预期。确定模型之后,去官网导航的「文档」和「获取 API Key」拿接入信息。
需要更细的分语言步骤,可以接着看这几篇:Python 和 Node.js 的客户端初始化、流式与重试,AI API 接入教程里有横向对照;遇到报错再翻错误码排查。



评论(0)