 NexAIX-官方博客
选模型时,别只看宣传页上最大的那个上下文数字。一次请求能不能完整跑完,取决于两条边界:
- 上下文窗口:这次请求里输入和输出加起来最多能有多少 token。
- 单次最大输出:模型一次回复最多能生成多少 token,也就是
max_tokens/max_completion_tokens能设到的上限。
这两条边界还会互相挤占。输入占得越满,留给输出的空间就越少。所以做模型上下文窗口对比之前,先回答三个问题:
- 我的输入最长会有多长?
- 我需要模型一次写出多少内容?
- 超长输入带来的延迟、限流和费用,我能不能接受?
两条边界各管什么
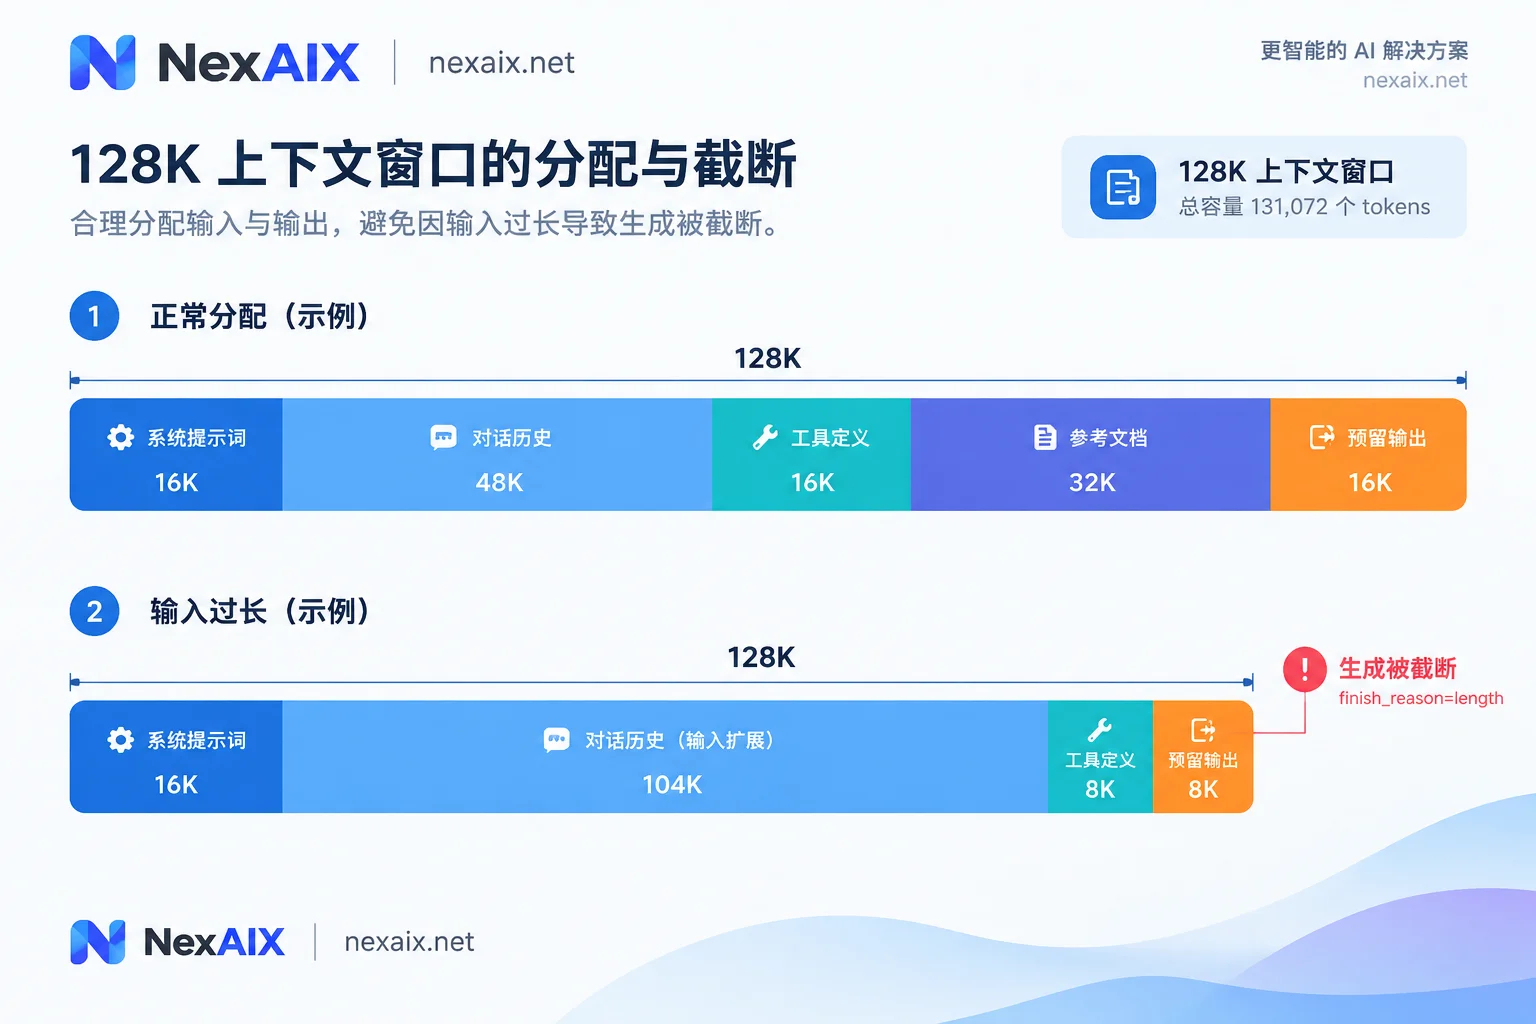
上下文窗口装的不只是用户这一轮的问题。它包含系统提示词、多轮对话历史、工具定义(function / tool schema)、检索或上传的参考文档,以及模型本次生成的输出。很多人算预算时只数了「文档有多长」,漏了历史和工具定义,于是在上线后遇到截断。
可以按这个关系估算:
输入 token + 预留给输出的 token ≤ 上下文窗口
预留给输出的 token ≤ 模型的单次最大输出上限
举个例子。一个模型的窗口是 128K,单次最大输出是 16K。
- 输入 100K 时,还能输出满 16K。
- 输入涨到 120K 时,剩下只有大约 8K。这时把
max_tokens设成 16K 也用不满,生成会被提前切断。
还要注意,不同模型的分词器不同,同一段中文算出来的 token 数也不一样。粗估只能用来规划,实际数字以响应里 usage 返回的值为准。
几个代表模型的窗口与输出上限
下面是各厂商文档对这些具体版本的说明。模型迭代很快,同一系列的新版本数字可能完全不同,接入时要以你实际调用的版本为准。
| 模型(代表版本) | 上下文窗口 | 单次输出上限 | 比较适合 |
|---|---|---|---|
| OpenAI GPT-4o / GPT-4o-mini | 128K | 通常 16,384 | 常规对话、中等长度文档、工具调用 |
| Anthropic Claude 3.5 Sonnet | 200K | 4,096–8,192 | 长文档通读、代码审阅 |
| DeepSeek-V3 系列 | 128K | 视版本和模式而定,文档中出现过 8K 到 64K | 通用任务、代码;新版本在向 1M 扩展 |
| Google Gemini 1.5 Pro / Flash | 1M–2M | 以对应版本文档为准 | 大型代码库、长音视频等多模态材料 |
从这张表可以看出三点:
- 窗口大不等于输出长。 Claude 3.5 Sonnet 能读 200K,但一次最多写 8K 左右。「读完一份 150K 的合同再整篇改写」这类任务,一次请求装不下输出,需要分段生成。
- 各家窗口差距远大于输出差距。 如果你的瓶颈是生成长内容,换一个窗口更大的模型未必能解决,先去看输出上限。
- 版本名比系列名重要。 Claude 和 DeepSeek 的新一代模型都在往 1M 上下文和更高输出容量走。迁移时如果只按系列名套用旧参数,要么浪费窗口,要么请求超限。
窗口够大,也别急着塞满
长上下文在工程上有三个常见代价。
首字延迟变长。 首字延迟(TTFT)会随输入长度增长,而且可能不是线性增长。流式输出能让后续内容边生成边显示,但等第一个字的时间省不掉。面向用户的交互场景尤其要算这笔账。另外,客户端的请求超时也要按长输入的实际耗时来设。
中间的信息容易被忽略。 这类现象常被称为 Lost in the Middle:超长文档中部的关键事实,模型提取的准确率往往比头尾低。常用的缓解办法有两个:
- 把关键指令放在开头,把具体问题放在材料之后。
- 只放真正相关的段落,不要整库塞进去。
一次请求就可能打满 TPM。 服务商通常按每分钟 token 数(TPM)限流。一个几十万 token 的请求,可能单独吃掉大部分配额,再并发几个就会返回 429。可以用这个办法估一下:每分钟能发的请求数 ≈ TPM 配额 ÷ 平均单请求 token 数。遇到 429 该怎么退避,可以参考 AI API 重试怎么设计。
成本上还有一个容易忽略的点:多轮对话每一轮都会把全部历史重新作为输入计费。历史越长,每一轮都越贵。
按任务选窗口档位
客服、单文档问答、多数工具调用 Agent
128K 级别通常够用。这类场景的重点不是窗口大小,而是控制历史长度和工具定义的体积。
长合同、长报告整体阅读(几万到十几万 token)
选 200K 级别。算预算时给输出留出余量,不要把窗口用到只剩几百 token。
整个代码库、长音视频,且内容之间必须全局关联
这时 1M 级别才有意义。前提是你能接受更长的延迟和更高的单次费用。
需要一次生成很长的内容
先看单次最大输出,窗口大小是次要的。输出上限不够时,就分章节或分文件生成。
资料很大,但每次只用到其中一小部分
用 RAG 检索分块,只把命中的片段放进上下文。这通常比全量塞入更快、更省,准确率也更稳。
同一份长资料会被反复提问
考虑 Prompt Caching,它能降低重复部分的延迟和计费。但是否支持、怎么触发、缓存多久,各厂商规则不同,不能拿一家的做法套到另一家。Claude 和 GPT 的缓存差异,可以看 Claude 和 GPT API 对比。
输出被截断时怎么查
在 OpenAI 兼容格式的响应里,先看 finish_reason:
stop:模型正常说完。length:生成撞上了max_tokens,或者耗尽了剩余的上下文空间。
其他厂商的原生协议字段名可能不同,以对应文档为准。
resp = client.chat.completions.create(
    model=MODEL,
    messages=messages,
    max_tokens=4096,
)
choice = resp.choices[0]
if choice.finish_reason == "length":
    u = resp.usage
    print("输出被截断", u.prompt_tokens, u.completion_tokens)
确认是截断后,看 usage 判断原因,再决定改哪里:
completion_tokens接近你设的max_tokens:调大max_tokens,但不能超过模型的输出上限。prompt_tokens已经接近窗口:压缩输入。可以把早期历史改成摘要,精简工具定义,或者把整篇文档改成检索片段。- 需要的输出本身超过模型上限:改成分段生成。注意,续写时要把已生成的部分放回上下文,这部分也会占用预算。
在 NexAIX 上确认窗口没被缩水
如果你通过 NexAIX 调用,接入方式是 OpenAI 兼容端点,只需把 base_url 改成 https://api.nexaix.net/v1,上面的排查代码不用改。
每个模型的窗口、输出上限和供给方式,都写在 模型页 里。供给方式分两种:开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道。选型时,用你实际要调用的那个版本的数字来算预算。
NexAIX 承诺不换小模型、不降精度、不砍上下文。你可以自己验证:
- 准备一份已知长度的长文本,对比响应里的
prompt_tokens是否符合预期。 - 在文档的开头、中部、结尾各放一条独特事实,逐一提问,看模型能不能答出。
- 发送接近窗口上限的请求,确认能正常处理,没有被静默截短。
完整的验证方法见 四条承诺与验证方法。注册后会送测试额度,可以直接在官网导航的「获取 API Key」拿 Key,先用自己的真实长度数据跑一遍。



评论(0)