 NexAIX-官方博客
先说结论:两家都提供 OpenAI 兼容的 /v1/chat/completions 接口,思考过程也都放在返回消息的 reasoning_content 字段里,所以接入代码大部分可以共用。选型主要看任务类型:
- 纯文本任务,比如代码生成、数理推理、长文档处理,并且在意推理格式规整、成本可控,先试 DeepSeek。
- 需要把图片或视频交给模型,要用到 1M 级上下文,或者在做多步工具调用的 Agent,先试 Kimi 的新一代模型。
两家最容易出错的地方在多轮对话中 reasoning_content 的处理:DeepSeek 不需要把它传回去,Kimi 在工具调用链路里建议传回去。这一处如果写成同一种逻辑,切换模型后很可能出问题。
先确认模型 ID
如果你的配置里还写着 moonshot-v1-8k、moonshot-v1-32k、moonshot-v1-128k 或 kimi-k2.5,需要先改掉。Moonshot 官方模型列表显示,这几个模型已于 2026 年 8 月 31 日废弃,当前主力是 kimi-k3、kimi-k2.7-code 和 kimi-k2.6。
DeepSeek 常用的端点是 deepseek-chat(通用对话)和 deepseek-reasoner(深度推理),之后又推出了 V4 系列,按能力分为 flash、pro 等档位。V4 的模型名变化和版本选择可以参考 DeepSeek V4 API 接入:Pro 与 Flash 版本选择。
两家的模型清单都在持续更新。写进生产配置前,应以官方模型列表为准,不要直接照搬旧教程里的 ID。
影响选型的四项差异
1. 上下文长度和输入类型
- Kimi:
kimi-k3支持文本、图像、视频的原生多模态输入,上下文窗口为 1M tokens。kimi-k2.6和kimi-k2.7为 256K。 - DeepSeek:不同模型覆盖 64K、128K,最高到 1M,重点是长上下文的吞吐和压缩效率。标准 API 场景仍以纯文本和代码为主要输入。
如果业务要让模型直接读截图、商品图或视频帧,Kimi 更直接。如果输入全部是文本,这一项不影响选择,应重点比较推理质量和成本。
2. 思考模式的开关和档位
两家都支持通过 reasoning_effort 调整思考深度,参数写法相近:
- DeepSeek 支持
reasoning_effort(low / high / max),也可以用extra_body={"thinking": {"type": "enabled"}}开启思考。 - Kimi(如
kimi-k3)在 thinking 模式下同样用reasoning_effort调节思考预算。部分高档位在不同权限层级的配额消耗不同,上线前需要查清自己账号的额度规则。
3. 多轮对话中 reasoning_content 的回传
这是两家在工程上差别最大的一点。
- DeepSeek-Reasoner:多轮对话时,历史轮次的
reasoning_content不需要拼回上下文。下一轮只带上一轮的最终content即可。 - Kimi:处理多步推理和工具调用时,官方建议把
reasoning_content保留并传回,也就是 Preserved Thinking,用来保证推理前后连贯。需要注意的是,这部分思考内容会持续占用后续轮次的上下文窗口,并计入 token。
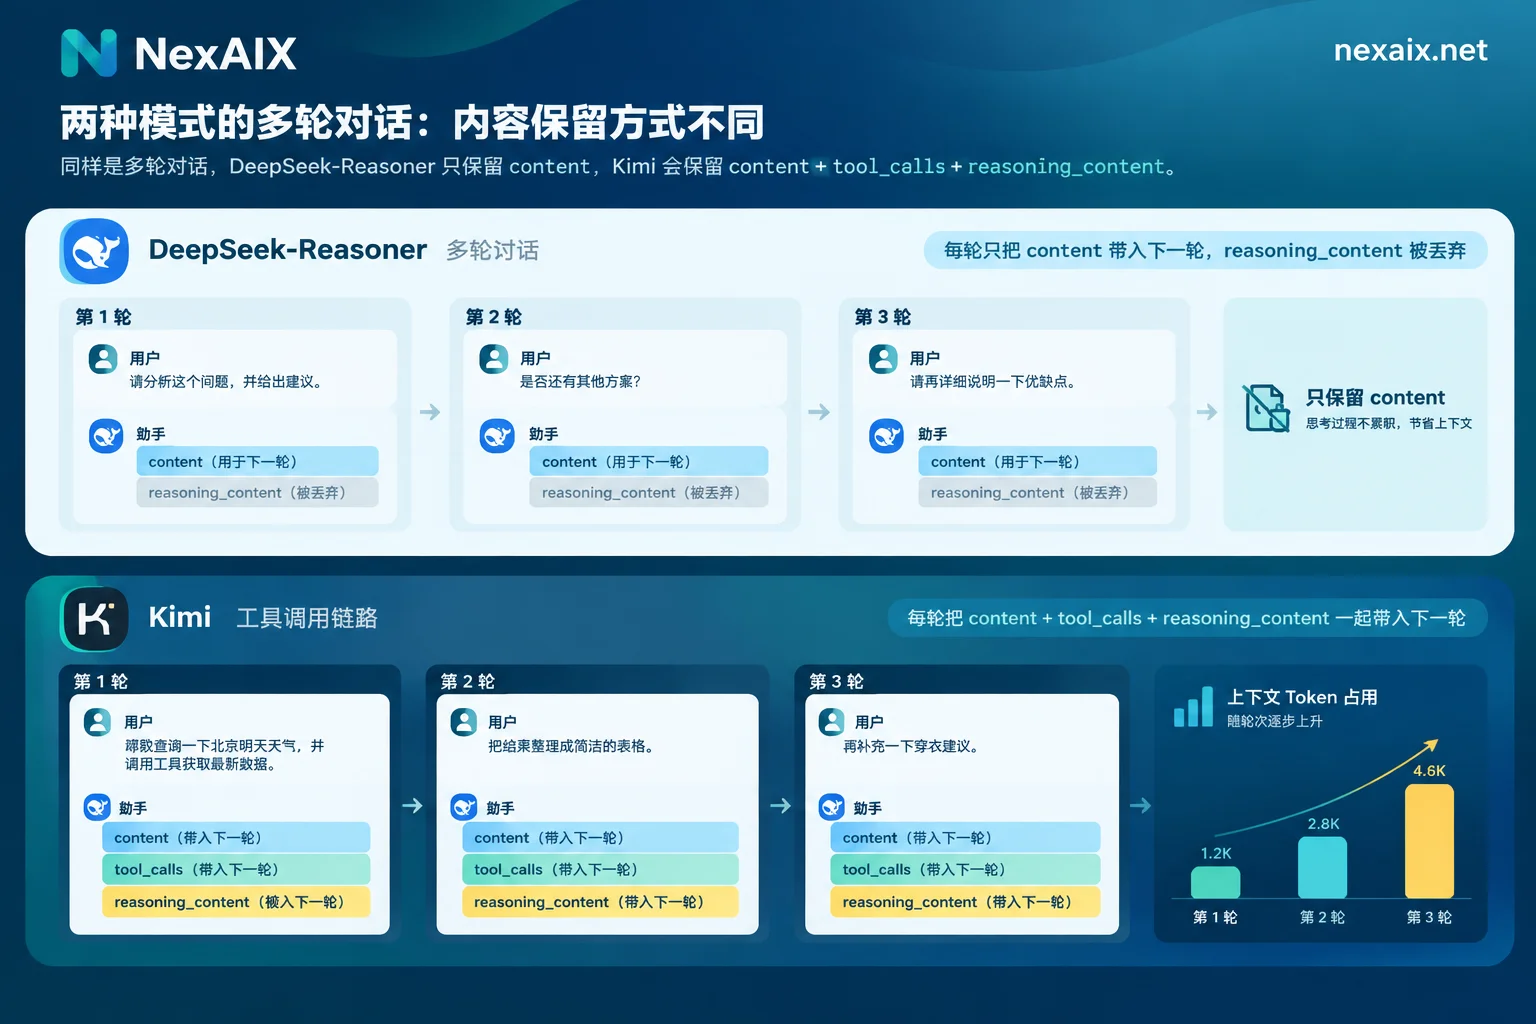
实际影响有两点:
- 从 DeepSeek 迁到 Kimi 做 Agent 时,如果沿用"丢弃思考内容"的写法,多步工具调用的连贯性可能下降。
- 反过来,在 Kimi 上一直保留思考内容,上下文增长会比预期快,长会话更容易接近窗口上限,费用也会随之上升。
4. 思考模式下采样参数不生效
DeepSeek 在 thinking 模式下不支持或会忽略 temperature、presence_penalty、frequency_penalty,top_p 只在 0.95 到 1.0 之间生效。Kimi 的推理模型也以预设采样策略为主,具体限制以 Kimi 文档为准。
从普通对话模型迁移到推理模型时,如果原代码依赖调低 temperature 来稳定输出,这条策略很可能不再起作用。需要改用其他方式控制输出,比如更明确的提示词、结构化输出约束,或者在程序侧做校验。
按任务选择
| 你的任务 | 优先尝试 | 原因 |
|---|---|---|
| 代码生成、数学和逻辑推理 | DeepSeek | 纯文本推理成熟,推理格式规整 |
| 超长纯文本(合同、日志、代码库) | 两家都可以,按窗口和成本实测后决定 | DeepSeek 和 Kimi 都有 1M 级选项 |
| 图片或视频理解 | Kimi(kimi-k3) | 原生多模态输入 |
| 多步工具调用的 Agent | Kimi,同时注意上下文增长 | 支持 Preserved Thinking,工具闭环能力较强 |
| 编码场景的专用模型 | 两家都可以 | Kimi 有 kimi-k2.7-code,DeepSeek 在代码推理上也较强 |
表中只是起步建议。最终用哪个模型,应该用你自己的 20 到 50 条真实样本跑一遍对比后再定。
用同一套代码接两家
两家都兼容 OpenAI SDK,切换时通常改三处:base_url、api_key、model。需要单独写的只有历史消息的拼接逻辑:
from openai import OpenAI

client = OpenAI(base_url=BASE_URL, api_key=API_KEY)

def append_assistant(history, msg, keep_reasoning: bool):
    item = {"role": "assistant", "content": msg.content}
    if getattr(msg, "tool_calls", None):
        item["tool_calls"] = msg.tool_calls
    # Kimi 多步推理/工具调用:保留思考内容;DeepSeek-Reasoner:不回传
    rc = getattr(msg, "reasoning_content", None)
    if keep_reasoning and rc:
        item["reasoning_content"] = rc
    history.append(item)

resp = client.chat.completions.create(
    model=MODEL,
    messages=history,
    reasoning_effort="high",
)
append_assistant(history, resp.choices[0].message,
                 keep_reasoning=MODEL.startswith("kimi"))
建议把 keep_reasoning 做成按模型配置的开关,不要在代码里写死。以后换模型或者调整策略时,只改配置即可。
如果想用一个端点、一套代码同时对比两家,可以把 base_url 换成 NexAIX 的 OpenAI 兼容端点 https://api.nexaix.net/v1,其余代码不用改。选模型时有一点值得留意:同一个开源权重模型,由谁部署、上下文有没有被裁剪,会直接影响对比结果。NexAIX 的每个模型页都标明供给方式,开源权重模型部署在自有算力上,闭源模型走厂商官方授权渠道,并承诺不换小模型、不降精度、不砍上下文。当前上架了哪些 DeepSeek 和 Kimi 模型、各自的上下文规格,可以在 模型清单 查看。做 A/B 测试时,给两组实验分别建一把 Key,每把 Key 的配额和用量账单是独立的,统计成本时不会混在一起。
上线前验证这几项
- 流式输出里的思考增量:
stream=True时,reasoning_content在每个 chunk 中以什么形式出现,不同客户端版本的处理可能不一样。尤其是 Kimi,建议用你实际使用的 SDK 版本跑一遍,确认 SSE 解析能把思考内容和正文分开。解析细节可以参考 流式输出 API 怎么接。 - token 增长曲线:在 Kimi 上开启 Preserved Thinking 后,跑一段 10 轮以上的真实会话,记录每轮的
prompt_tokens,确认到达窗口上限之前已经有截断或摘要策略。 - 采样参数是否生效:在推理模式下分别改动
temperature等参数,对比输出。如果没有变化,说明这些参数被忽略了,应从配置中删除,避免给后来维护的人造成误解。 - 上下文真实长度:用接近标称上限的输入做一次"开头埋信息、结尾提问"的测试,确认实际可用的上下文长度与宣称一致。
- 延迟:目前缺少两家在高并发下首 token 延迟的公开横向数据,需要用自己的并发量实测。
单个模型更细的参数设置,可以继续看 Kimi K3 API 接入指南。Agent 场景的工具调用验证方法见 Agent API 怎么接。



评论(0)