 NexAIX-官方博客
如果你手上已经有一段用 OpenAI SDK 调模型的代码,接 Kimi K3 的改动量是两行:base_url 换成供给方的端点,model 换成 kimi-k3。
但第二天真正让你翻日志的不是这两行,而是它和多数模型不一样的三个地方:
- 思维链始终开启,响应里多出一个
reasoning_content字段; - 多轮对话和工具调用循环里,这个字段必须原样回传,只回传
content会让上下文状态断裂; reasoning_effort的默认值是max,你不显式降档,每个请求都按最深的推理跑。
先把这三条处理好,其余都是常规工程问题。
先判断这个任务值不值得用 K3
规格决定了它该干什么活。Kimi K3 是月之暗面 2026 年 7 月发布的旗舰级原生多模态 MoE 模型:总参数 2.8T,激活参数约 104B(896 个专家中激活 16 个),原生支持 1,048,576(1M)tokens 上下文,输入侧覆盖文本、图像与视频。
翻译成选型语言:激活参数量决定单 token 的推理成本和延迟,总参数规模决定能力上限,1M 上下文决定它能不能一次吃下你整个仓库而不用自己做切分检索。这套配置指向的是重活:
- 大型仓库的全局审查与跨文件重构——把相关代码、依赖和设计文档一次性放进上下文,省掉自建 RAG 那一层的召回损失;
- 长程编程(long-horizon coding)与多轮跨工具的自主修复——模型需要连续几十轮保持目标不漂移;
- 高难度数学与逻辑推理。
反过来,意图分类、短文案改写、固定字段抽取这类单轮、要求低延迟高并发的任务,用它并不划算。思维链始终开启意味着每个请求都带一段推理开销,延迟和 token 消耗都压不下来。这类环节更适合交给轻量模型,把 K3 留在真正需要它的那一步。
在同一条 agent 链路里混用不同量级的模型,是比较常见的做法:规划和疑难修复用 K3,工具参数拼装、结果格式化用便宜的模型。前提是你的接入层能用同一套代码切换模型名。
最小可用的调用
它全面兼容 OpenAI Chat Completions 规范,所以 Python/Node.js 的官方 SDK、以及大部分基于这套协议的应用框架(各类 agent 框架、IDE 插件、客户端)都不用改调用逻辑,只改端点和模型名:
from openai import OpenAI

client = OpenAI(
    api_key="你的 Key",
    base_url="https://api.nexaix.net/v1",
)

resp = client.chat.completions.create(
    model="kimi-k3",
    messages=[{"role": "user", "content": "审查这个模块的并发安全问题"}],
    reasoning_effort="high",
)

print(resp.choices[0].message.reasoning_content)  # 思考过程
print(resp.choices[0].message.content)            # 最终回答
如果你走的是中转端点,有一件事值得先确认:这个模型在你的供给方那里是怎么来的。开源权重模型部署在自有算力集群,和闭源模型走厂商官方授权渠道,是两种不同的供给方式,直接影响你能不能指望上下文长度、字段完整性和版本稳定性。NexAIX 在每个模型页标明属于哪一种,端点只有 https://api.nexaix.net/v1 一个,不做跨供应商路由——你可以在模型清单页确认 Kimi K3 的供给方式和公开的配额与限速。
reasoning_effort 三档怎么选
reasoning_effort 是请求顶层参数,可选 low、high、max,默认 max。注意这里没有「关闭」选项——思维链是常开的,你能调的只是深度。
实践上的取舍:
max:默认值,留给真正的硬任务——复杂算法设计、长链路 debug、高难度数学。也是延迟和 token 开销最大的档。high:多数长程编程和 agent 循环的合理起点。能力损失有限,但整条链路的响应时间会明显好看。low:需要模型在场但不需要它想太久的环节,比如工具参数生成、结构化输出整理、简单的判断分支。
如果 SDK 版本不认这个参数名,用 extra_body={"reasoning_effort": "high"} 传。
一个容易被忽略的后果:改档位会改变输出分布。你如果有评测基线或 prompt 调优结果,换档之后需要重跑,不能直接沿用。
多轮和工具调用:必须回传完整的 assistant 消息
这是接 K3 最容易踩的坑,也是它和普通 Chat Completions 模型最实质的差别。
K3 严格要求在多轮对话与工具调用循环中保留完整的思维历史:上一轮 API 返回的 assistant 消息对象要原样放回 messages 数组,同时包含 reasoning_content 和 tool_calls。只回传 content 会导致上下文状态断裂或调用异常——表现通常不是直接报错,而是模型突然「忘了」自己上一轮为什么要调那个工具,开始重复调用或者绕圈。
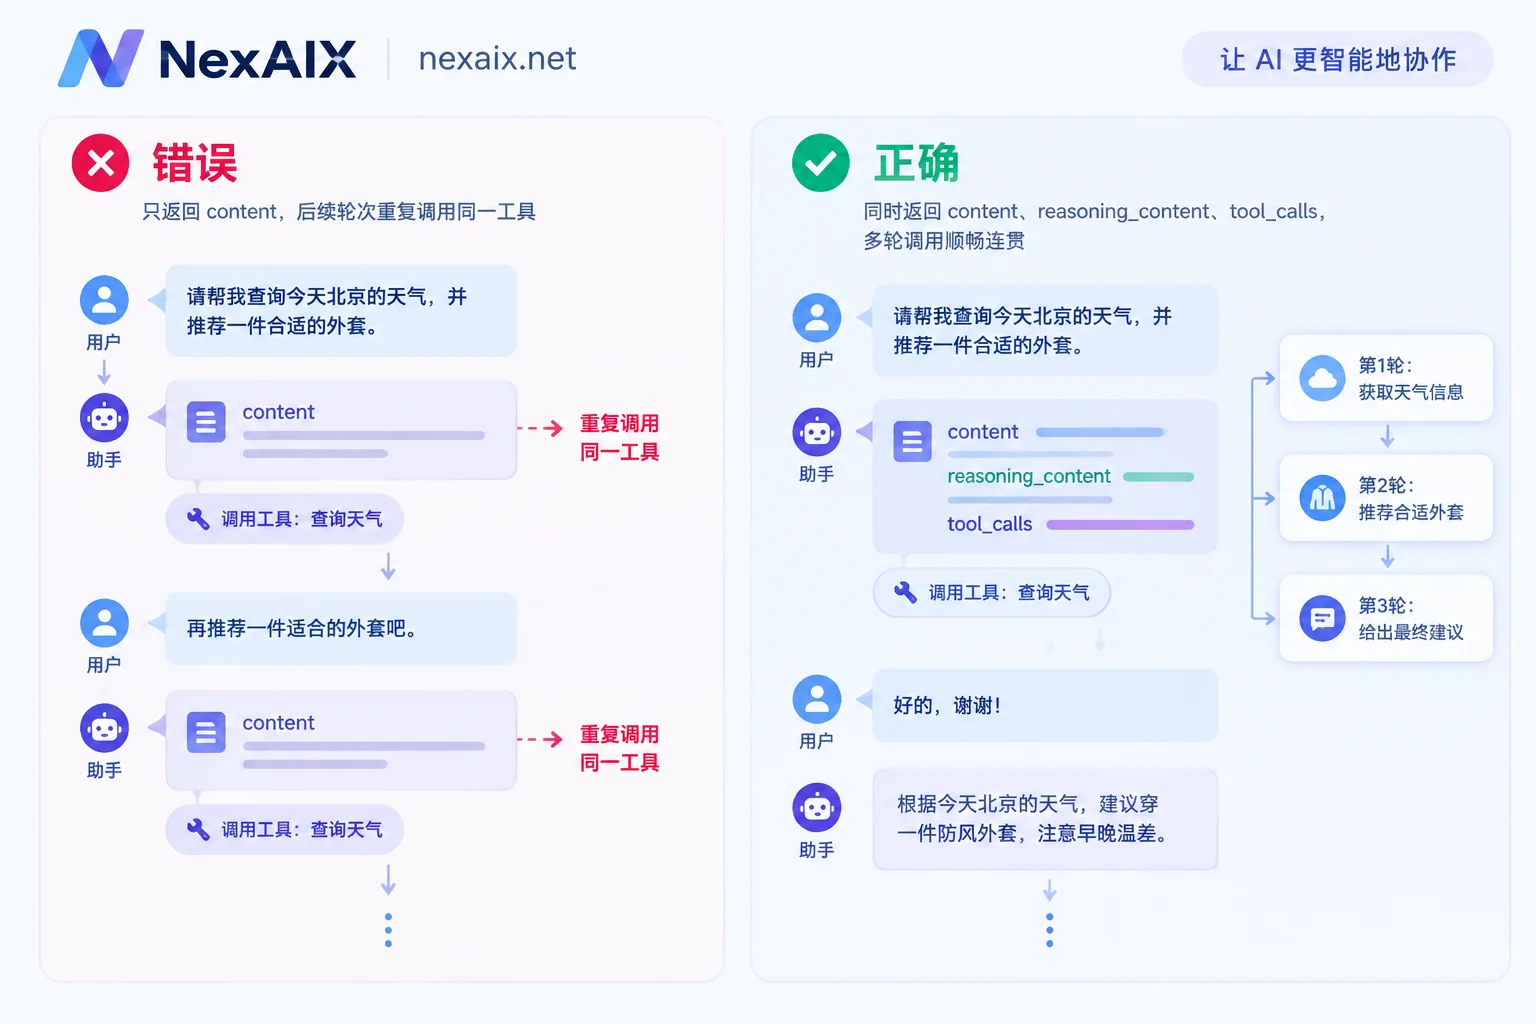
正确的循环长这样:
messages = [{"role": "user", "content": task}]

while True:
    resp = client.chat.completions.create(
        model="kimi-k3", messages=messages, tools=tools,
    )
    msg = resp.choices[0].message

    # 关键:整个 assistant 对象入栈,含 reasoning_content 与 tool_calls
    messages.append(msg.model_dump(exclude_none=True))

    if not msg.tool_calls:
        break

    for call in msg.tool_calls:
        messages.append({
            "role": "tool",
            "tool_call_id": call.id,
            "content": run_tool(call),
        })
典型的错误写法是这一行:
# 错误:丢掉了 reasoning_content
messages.append({"role": "assistant", "content": msg.content})
很多现成的 agent 框架内部就是这么拼消息的。接入前值得先看一眼它的历史拼装逻辑,或者打印一次实际发出去的 messages 体。
流式场景同理:reasoning_content 的增量分片也要累积起来,拼回完整对象再入栈,不能只收集 content 的 delta。关于流式解析和 token 统计的细节,可以参考流式输出 API 怎么接;工具调用循环的通用验证点在Agent API 怎么接里有更完整的展开。
工具清单很长的时候
把几十个工具定义一次性塞进请求,既吃上下文又会稀释召回准确率。官方推荐的做法是加一个检索函数(比如 search_tools),让模型按需把需要的工具定义动态注入对话。
配合的技巧是:首轮把 tool_choice 设为 "required",强制它先做一次工具检索;后续轮次再切回 "auto"。这个切换不会破坏前缀缓存(Prefix Cache),所以不用担心把缓存命中率打掉。
超时、429 和重试
两个硬边界要写进客户端逻辑:
- 单次复杂任务最长支持 2 小时处理时间,超出返回
504 Gateway Timeout。长程任务建议用流式,一方面能尽早看到进展,另一方面避免中间层的空闲连接超时提前掐断。 - 并发或频率超限返回
429 Too Many Requests,需要客户端做退避重试。
退避参数不要拍脑袋定:先看 429 响应带不带 retry-after,带就按它来。具体可以参考指数退避重试要等多久合适和AI API 限流怎么处理。另外注意 504 和 429 的重试策略不该相同——一个跑了两小时的任务直接原样重试,代价是双倍成本,通常更该做的是拆任务。哪些错误值得重试,这篇有分类。
验证你拿到的确实是完整的 K3
重型旗舰模型是降配动机最强的一类。三条检查,对应三种常见手法:
一、reasoning_content 是否真实完整。 看它是不是空字段、是不是把 content 复制了一份、是不是几句模板化的套话。更可靠的做法是同一条 prompt 分别用 low 和 max 跑,观察推理长度和耗时是否真的随档位变化——如果两档结果几乎一样,说明参数没有被真正传递到模型。
二、1M 上下文的长距离检索准确率。 在 60 万到 80 万 token 的材料里埋几个标记,分别问开头、中段、尾部位置的内容。上下文被悄悄截断,这一步会立刻暴露。
三、多轮工具调用的状态连贯性。 按上面的正确写法跑一个 10 轮以上的循环,看模型在后期是否还记得早期轮次的决策理由。思维历史被中间层丢弃,模型会表现为反复试探同一个方向。
这三条分别对应换小模型、砍上下文、丢字段。NexAIX 把不降配、不记录对话、配额与限速公开、按 Key 隔离四条写在能力与验证方法页上,并给出可自行复现的核验步骤——不管你最终用哪家,这类验证都建议在正式接入前跑一遍,而不是等线上出现质量波动再回头查。
关于视频输入
K3 原生支持视频输入,但 HTTP API 直传的具体编码格式和单次请求大小上限,属于会随端点实现变化的部分,以你实际调用的那个端点的文档为准,不要按图片输入的规则推测。
下一步:在模型页确认 Kimi K3 的规格、供给方式和公开配额,从官网导航的「文档」拿到 Key(注册即送测试额度,不需要企业资质),然后用上面那三条验证跑一遍再决定要不要把生产流量切过去。


评论(0)