 NexAIX-官方博客
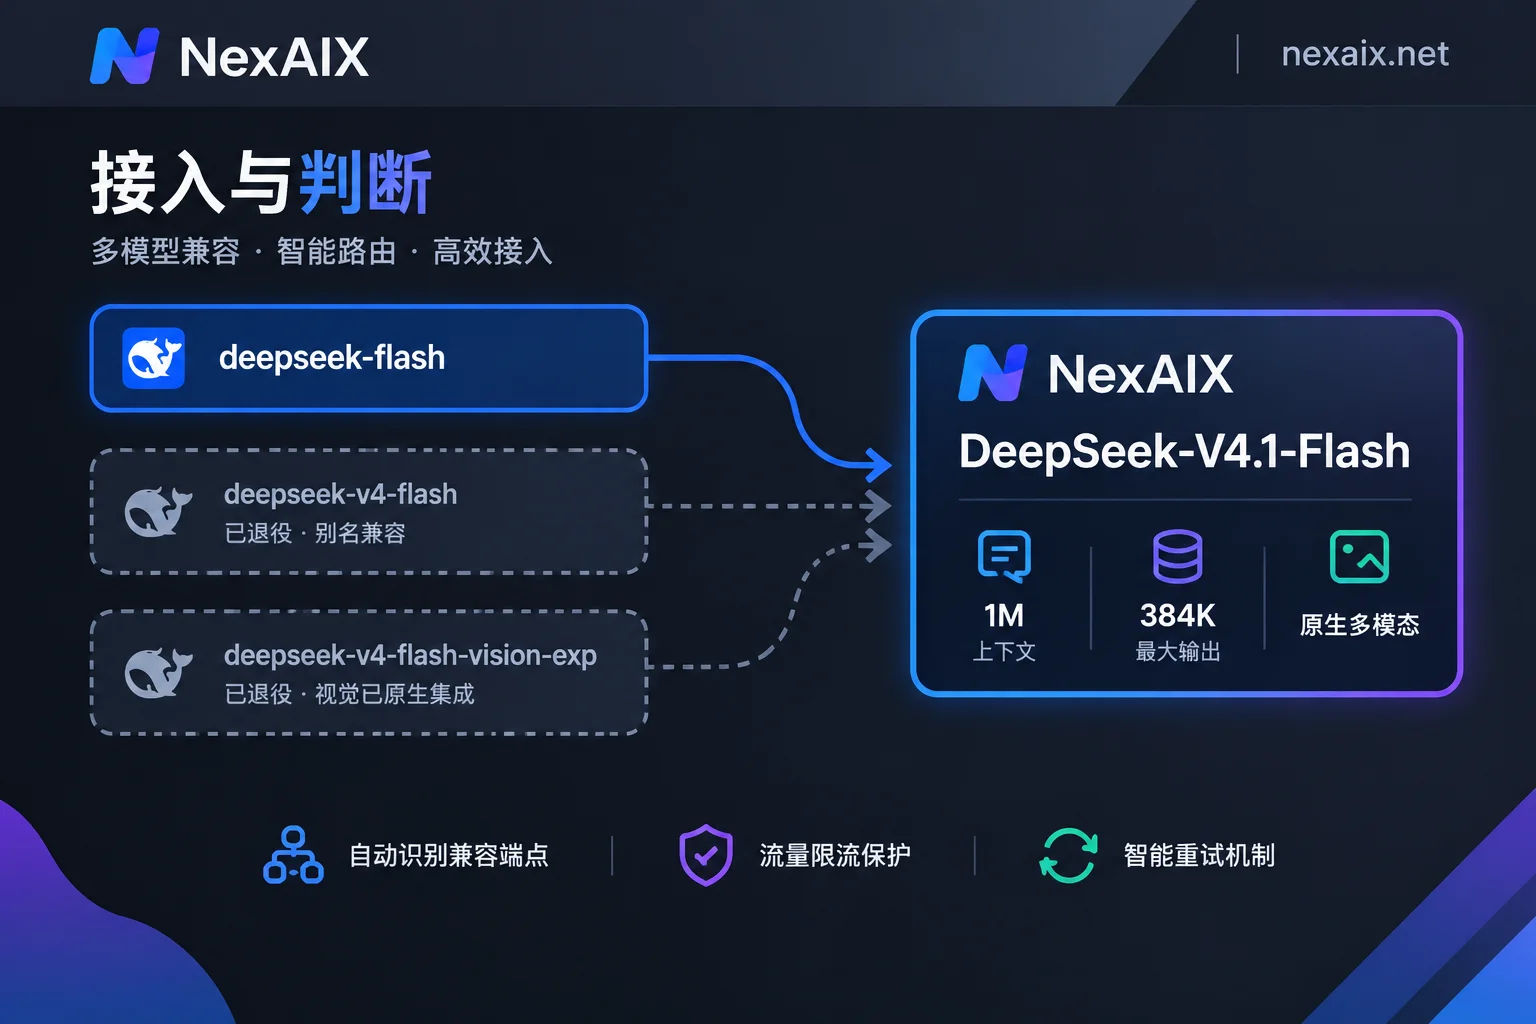
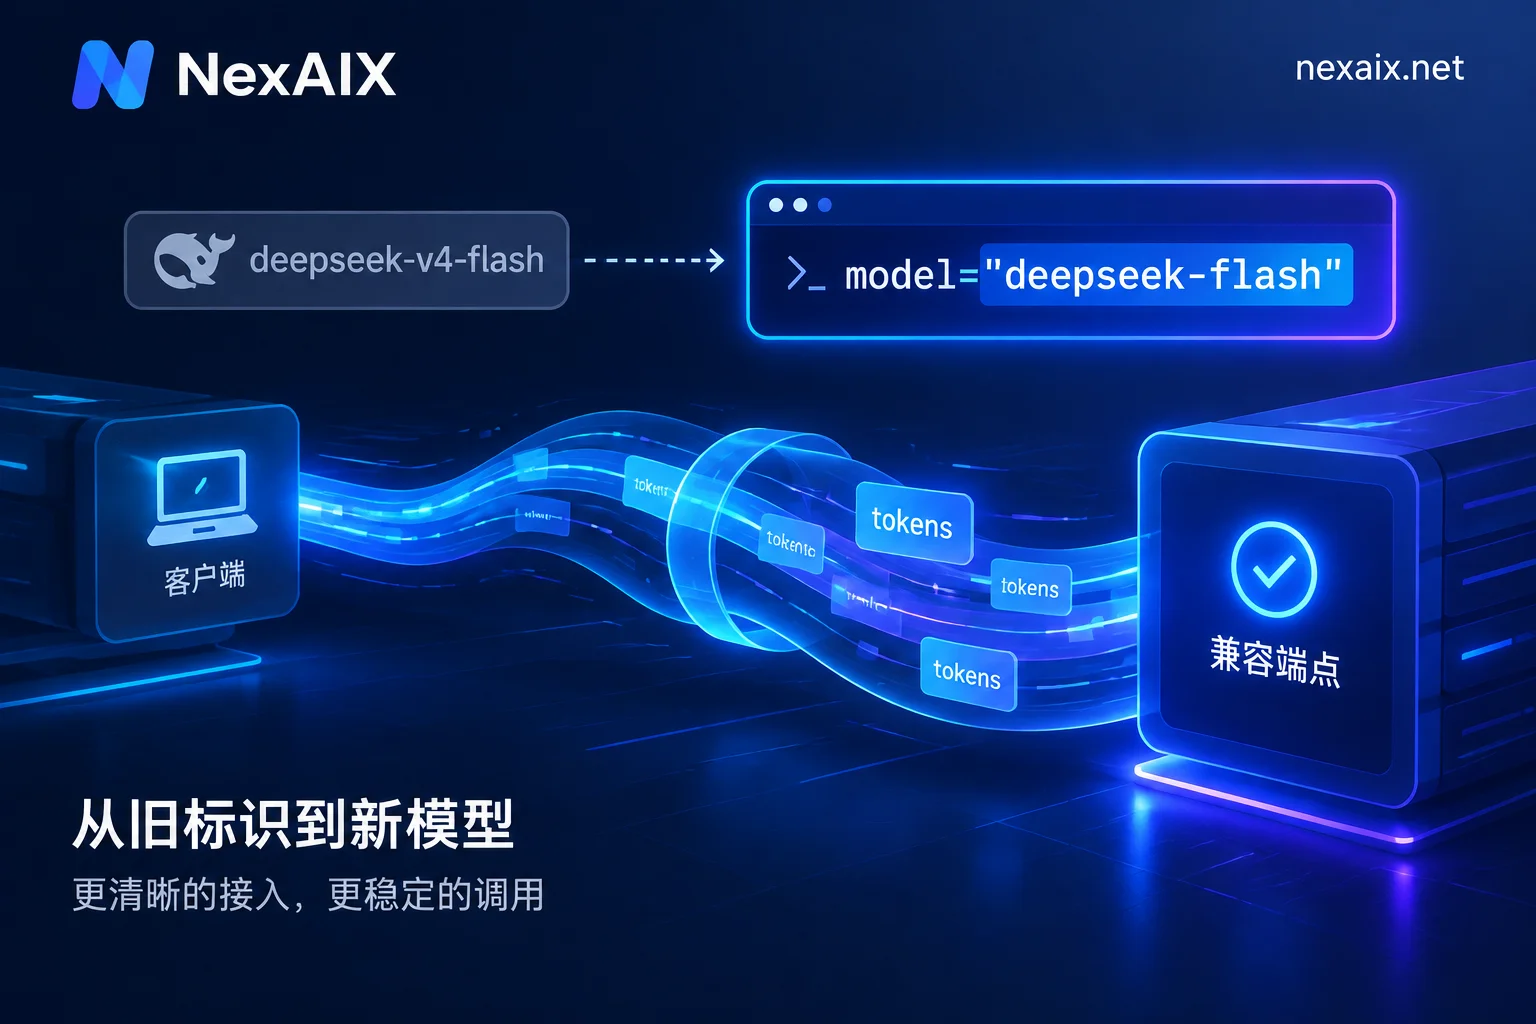
如果你的代码里现在写的是 model="deepseek-v4-flash",请求不会报错,但你拿到的已经不是当初那个模型了。这一代已经整体升级为 DeepSeek-V4.1-Flash,官方推荐的标准模型名统一成了 deepseek-flash。原来的 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 两个标识正式退役,只保留别名兼容——历史请求会被自动路由到 4.1 版本处理。
所以新写的代码直接填 deepseek-flash;老项目短期内可以不动,但要清楚两件事:一是你的线上行为在某个时间点已经悄悄换了权重,二是别名兼容是厂商的保留策略,不是永久承诺。把模型名改成显式的新标识,是这次迁移里最值得先做的一行改动。
这个模型适合接在哪里
V4.1-Flash 是 552B 总参数的混合专家模型,用的是因果编码-解码的非对称结构:输入 prefill 阶段只激活约 8B 参数,输出 decode 阶段激活约 16B,KV Cache 相比常规结构大幅缩减。这套设计的直接后果是首 token 延迟低、并发吞吐高,长对话的显存开销也更可控。
翻译成选型判断:
- Agent 与工具链是它的主场。多轮工具调用意味着一次任务里要跑十几次模型调用,每次都省下来的延迟会被放大,这类场景比单纯比拼单次质量更吃响应速度。
- 长文档处理可以用,上下文上限是 1M tokens(1,048,576),单次最大输出可达 384K tokens。
- 需要最强推理质量的离线任务,Flash 不一定是最优解,同代的 Pro 型号定位不同。这两者怎么分工,我在 DeepSeek V4 API 接入:Pro 与 Flash 版本选择、调用参数与降配验证 里展开过。
还有一个容易漏的变化:视觉能力已经原生集成,不再需要带 -vision-exp 后缀的独立模型。如果你的项目里为了图像理解单独维护了一套模型名和分支逻辑,这次可以直接删掉,图文请求发给同一个 deepseek-flash 即可。
接入配置:改 base_url,然后确认三个参数
服务端原生兼容 OpenAI Chat Completions 规范,同时也提供 Responses API 和 Anthropic 格式的端点支持。用 OpenAI SDK 或任何三方框架接入时,实质改动只有 base_url、API Key 和 model 三处:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_KEY",
    base_url="https://api.nexaix.net/v1",
)

resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "..."}],
    max_tokens=16384,
    stream=True,
)
如果你走的是中转端点,把 base_url 指到对应的 OpenAI 兼容地址就行,Agent 框架、代码助手插件、LangChain 之类的上层配置一律不用动。NexAIX 的端点是 https://api.nexaix.net/v1,模型清单页会标明每个模型是开源权重自有算力部署还是厂商官方授权渠道——这两种供给方式的行为边界不同,接之前值得先看一眼。具体挂载的标识是 deepseek-flash 还是同时映射旧的 deepseek-v4-flash,以模型页实际显示为准,不要凭官方文档直接假设,两边的别名策略未必同步。
三个必须显式设置的参数
max_tokens。 384K 是上限,不是默认值。多数 SDK 的默认输出上限远低于此,长报告、大段代码生成时会在中途被截断。判断方法是看 finish_reason:等于 length 就是撞上了输出预算,等于 stop 才是模型自己说完了。
stream。 只要单次输出可能超过几千 token,就开流式。非流式长输出很容易在网关或反向代理上撞到超时,表现为请求跑了两分钟然后连接断开,日志里看不到任何模型侧错误。这类现象的排查路径可以参考流式输出 API 的 SSE 解析与代理卡顿排查。
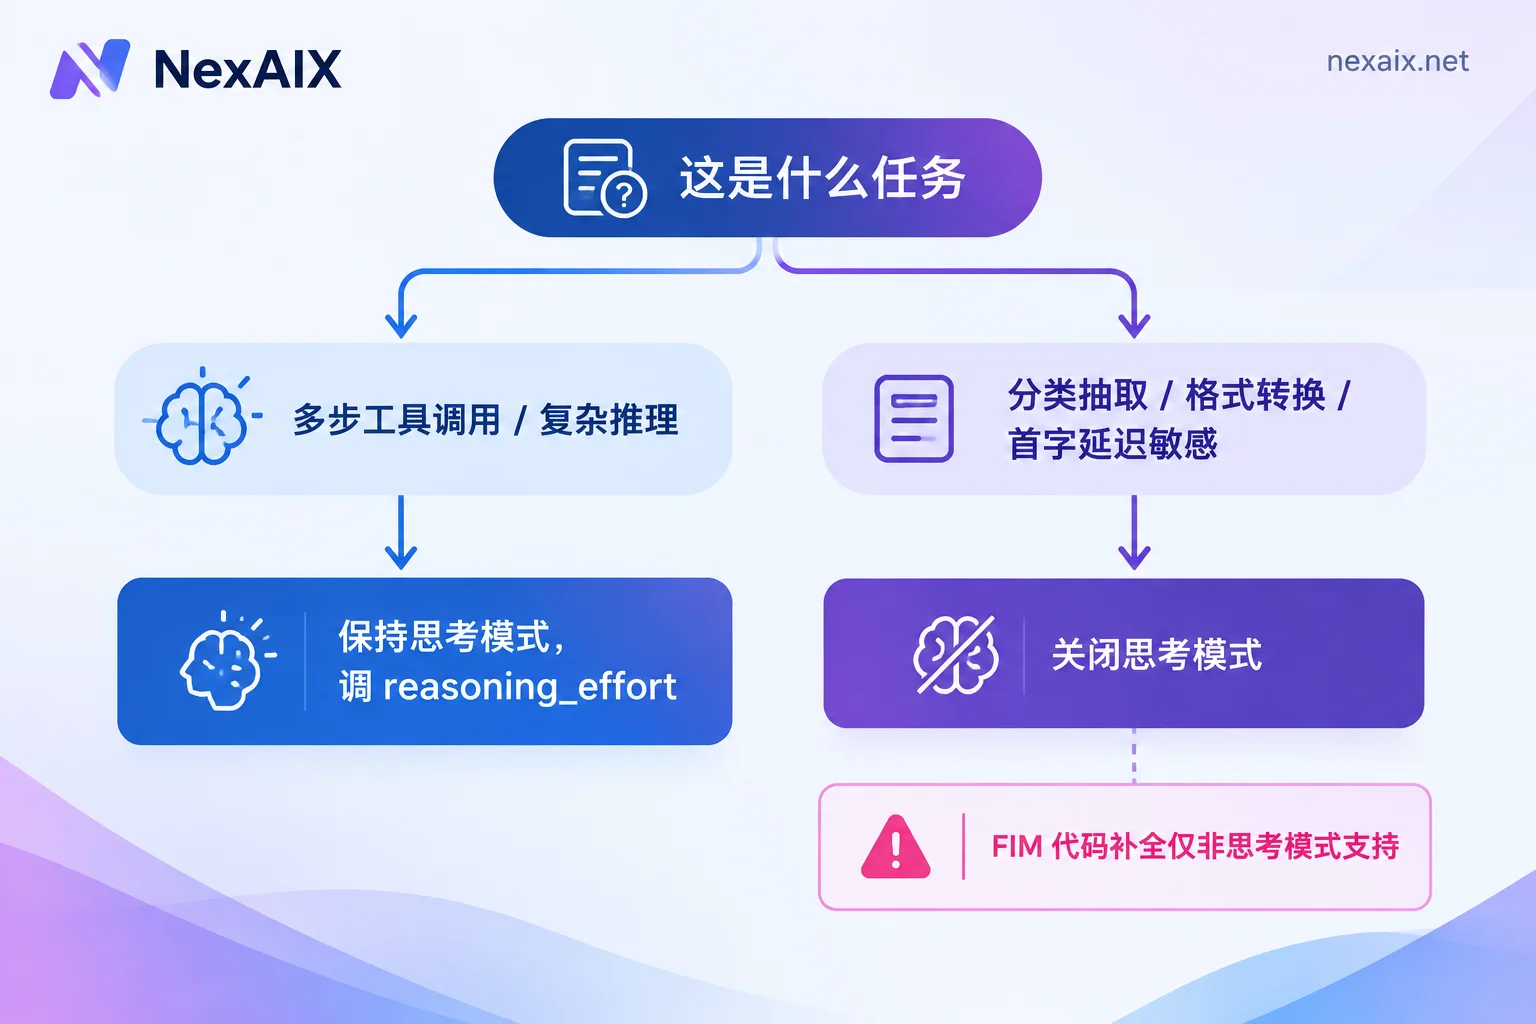
思考模式。 V4.1-Flash 默认开启思考模式(Thinking Mode),推理深度通过 reasoning_effort 调节;也支持关闭思考的非思考模式。具体可选档位以官方文档和模型页为准。这里有个真实的坑:代码前缀补全(FIM Completion)只在非思考模式下支持。如果你在做 IDE 补全类产品,请求带着默认的思考模式发过去,会得到一个不符合预期的结果而不是清晰报错。
思考模式该开还是该关
没有统一答案,按任务类型决定:
- 多步工具调用、需要规划的 Agent 任务、复杂代码重构:保持思考模式,必要时调高
reasoning_effort。 - 分类、抽取、格式转换、FIM 补全、需要严格控制首字延迟的交互场景:关闭思考模式。这类任务多想一轮不会更准,只会更慢更贵。
- 结构化输出场景:JSON 输出和工具调用(Tool Calls)都支持,但思考模式下的响应结构和 token 计费会包含推理部分,做成本估算时别只算最终可见的输出。工具调用链路本身的验证点,Agent API 的四个验证点那篇列得比较全。
长上下文的实际用法
1M 上下文不等于可以把整个代码库塞进去。KV Cache 缩减改善的是显存和吞吐,首 token 延迟仍然随输入长度增长——prefill 阶段要把所有输入过一遍,这部分时间省不掉。
实务上的做法是:把 1M 当成「不用为分块逻辑写一堆胶水代码」的余量,而不是当成检索的替代品。一份完整的技术文档、一次长会话的全部历史、几十个文件的相关片段,直接扔进去省心;但如果输入常态化超过几十万 token,延迟和成本都会变得不好看,该上检索还是要上。
多模态输入方面,图像走标准的 OpenAI 格式消息结构即可。单图分辨率上限和 Base64 体积阈值这类硬性限制,官方公开资料里没有给出明确数字,建议实际测一遍再定你的图片预处理策略,不要按别家模型的经验值套。
迁移后怎么确认模型没被换掉
模型名统一加上别名自动路由,等于多了一层你看不见的间接层。厂商侧的这种路由是明示的升级策略,但如果你的请求还要经过中转,就有必要自己验一遍。几个可执行的核对动作:
- 看响应里的
model字段。返回值应该指向你预期的版本标识,而不是某个更小的型号。这是成本最低的一次性检查。 - 测上下文真实容量。构造一个超过常见小窗口(比如 128K)的输入,把答案埋在靠前的位置,看模型能否取到。被砍上下文的典型表现是超长输入直接报错,或者前半段内容完全丢失。
- 测输出上限。要求生成一段确定长度的超长内容,看
finish_reason和usage里的输出 token 数,确认没有被压到一个低得多的天花板。 - 固定模型标识,关掉上游的自动回退。别名兼容和「繁忙时自动降级到小模型」是两回事,前者是版本升级,后者是降配。怎么锁定标识、怎么判断链路上有没有回退,可以看锁定模型、关闭自动路由的请求配置与验证和版本标识与路由回退的核验方法。
NexAIX 在这一层的做法是不换小模型、不降精度、不砍上下文,配额与限速公开,验证方法写在四条承诺页上——你可以用上面这几步自己复核,不必只看文字承诺。请求按 API Key 隔离,每把 Key 有独立的配额、权限和用量账单,所以团队里做灰度验证时,给测试环境单开一把 Key 就能把用量和线上分开看。
上线前的最后两项
限流处理。 高并发 Agent 场景下,429 是常态而不是异常。先读响应头里有没有 retry-after,有就按它等,没有才用指数退避加抖动,别一上来就固定 sleep 一秒重试。完整的处理逻辑见从 429 标头到退避重试与流量隔离。
别名依赖清理。 现在能跑通不代表半年后还能跑通。在代码里搜一遍 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp,把模型名收进一处配置常量,改成当前的标准标识。顺手把为 vision 专用模型写的分支逻辑删掉——视觉已经是主模型的原生能力,那套分支现在纯属负担。
准备好 Key 就可以先跑通第一个请求,再按上面的核对项逐条验一遍。注册时会送测试额度,不需要企业资质,足够把选型和验证这两步走完。


评论(0)