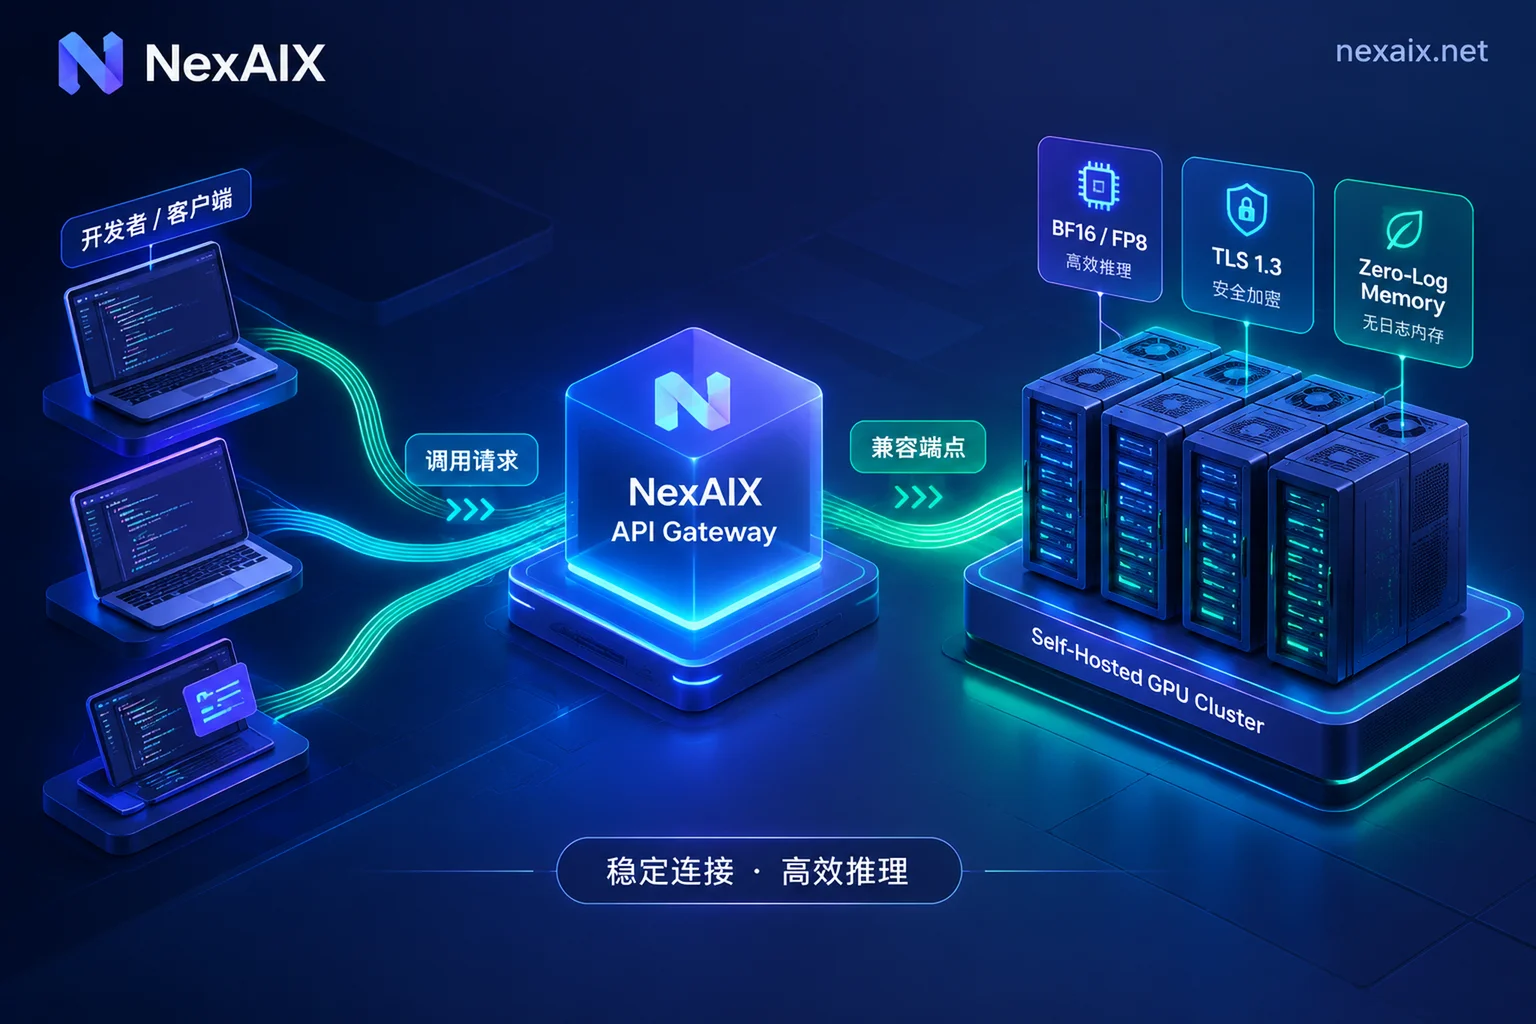
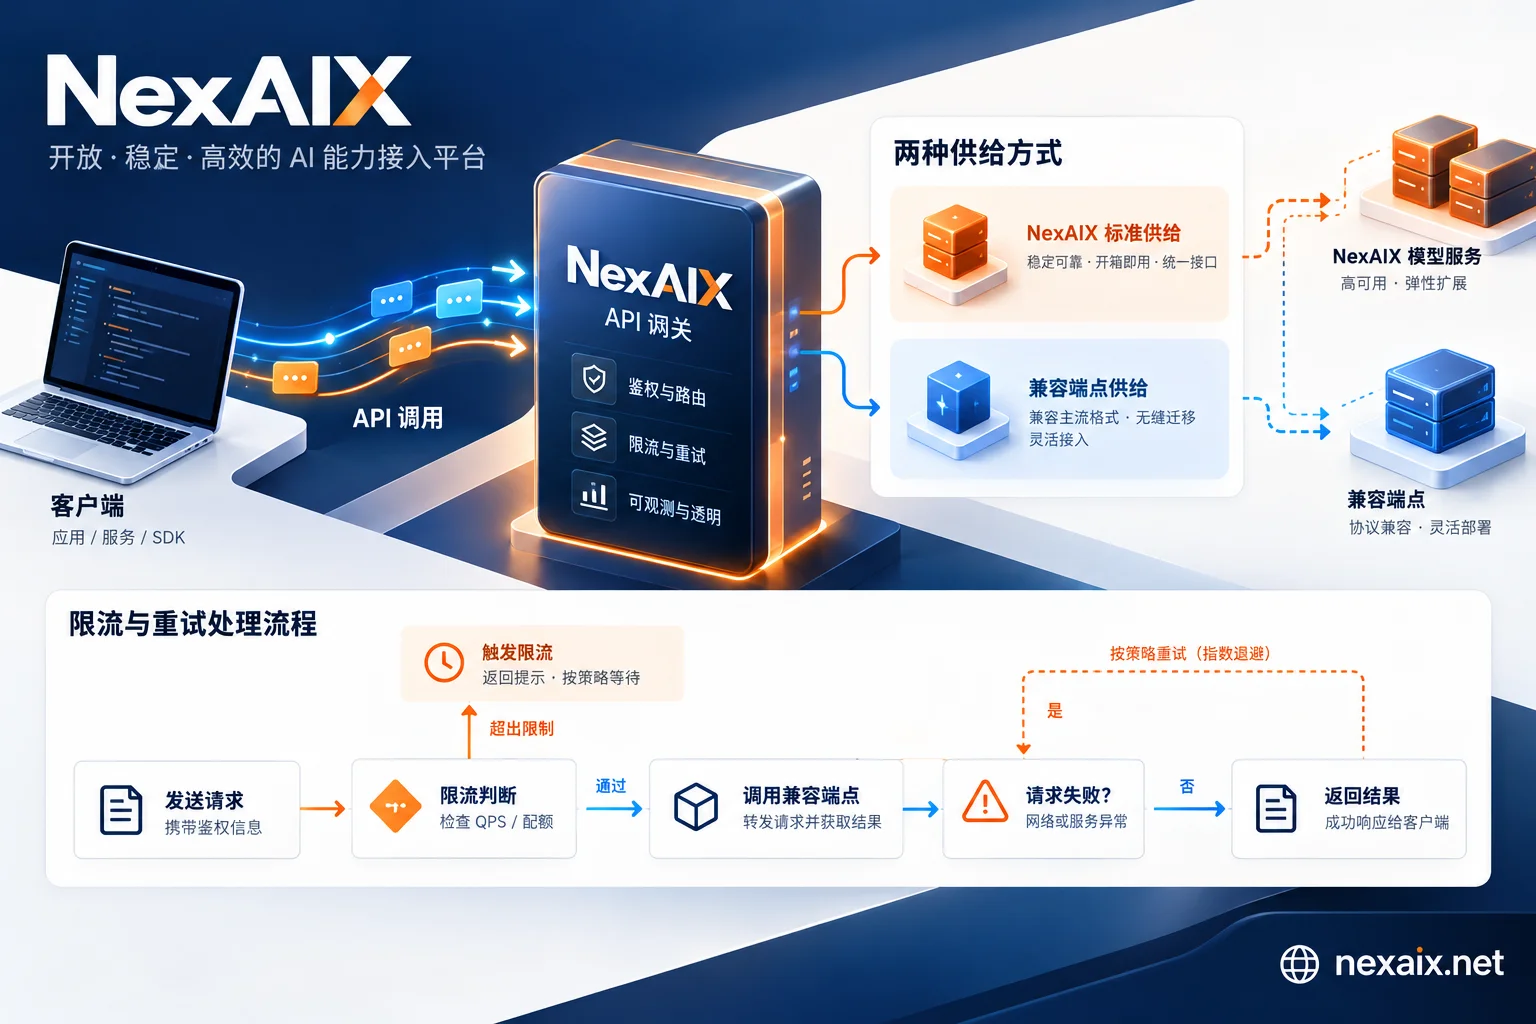
随着千亿参数 MoE 开源权重模型在编码和 Agent 场景追平前沿闭源模型,越来越多团队将日常流量切向开源大模型 API。本文拆解自建 GPU 推理的隐性门槛,剖析二手额度转售与隐蔽降配的风险,并给出基于自有算力部署、零日志与单端点混合调用的生产级选型清单。
两类 API 接口格式可以一样,真正的区别在于推理由谁来跑。开源权重模型由服务方自己部署,精度、上下文和日志策略由部署方决定。闭源模型只能由原厂推理,渠道需要确认是否真的走官方,留存和限流要看原厂条款。本文按精度、上下文、数据留存、限流延迟四项拆开说明,并给出选择场景和接入前的核对步骤。
BF16 和 FP8 的区别主要在每个数值占的位数。FP8 能让权重和 KV 缓存的显存占用约减半,在支持原生 FP8 的 GPU 上还能提高吞吐;BF16 数值更稳定,适合代码、数学推导和结果对齐。本文按显存、速度、质量和硬件四项说明差异,给出自部署和 API 调用两种情况下的选择方法,以及验证模型是否降精度的步骤。
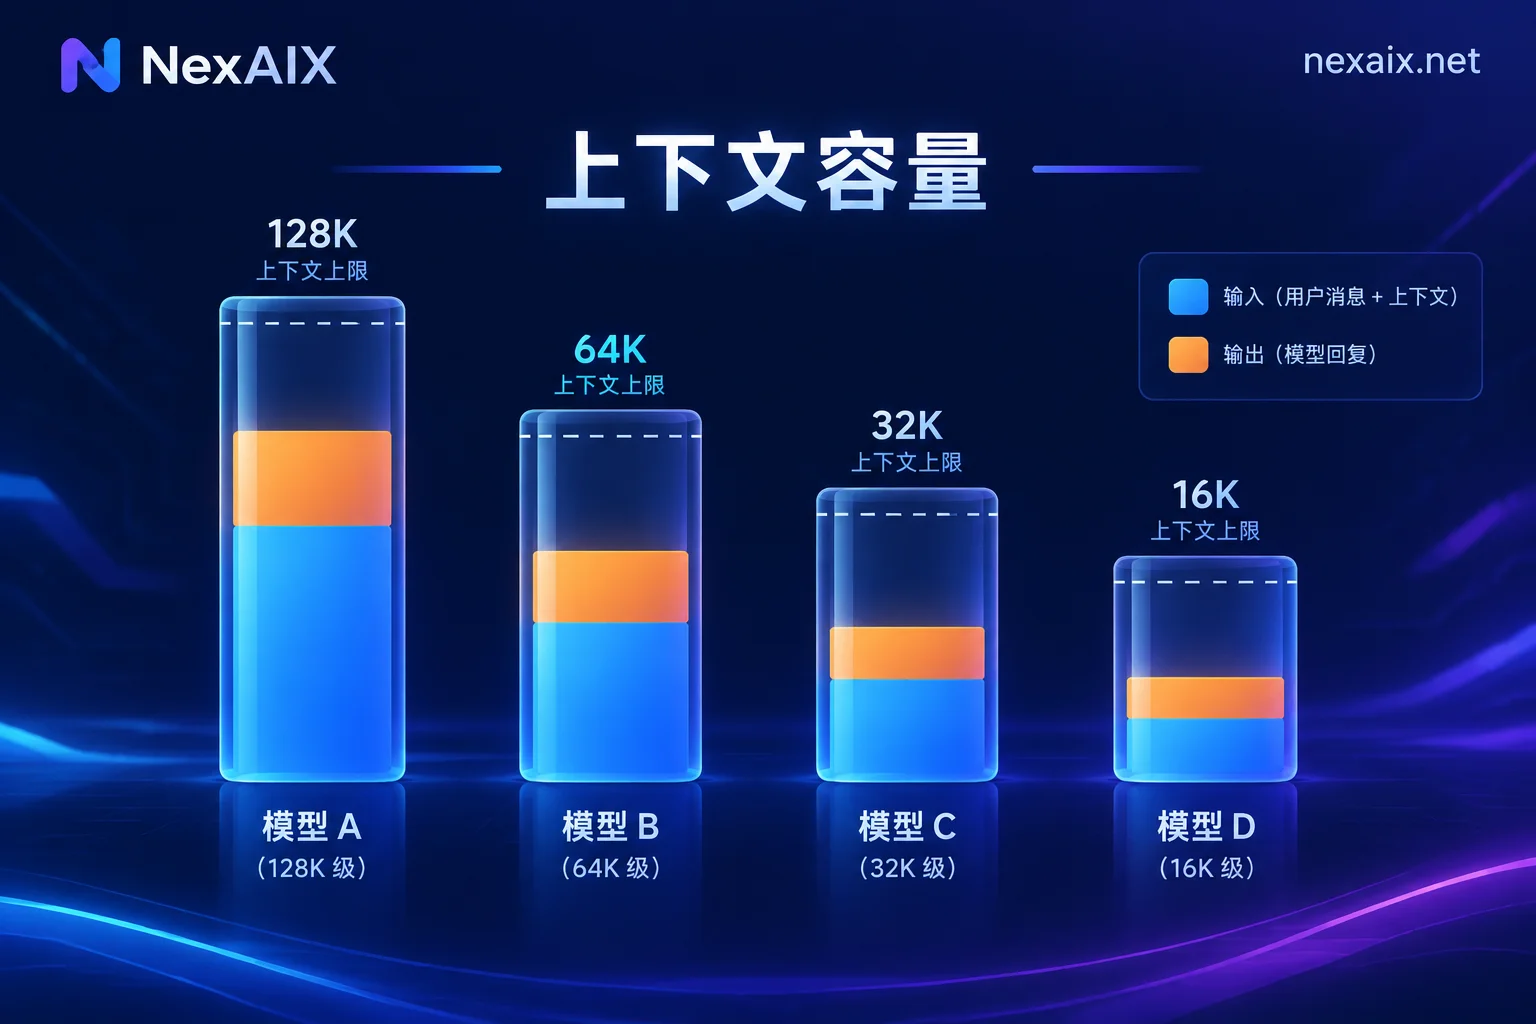
对比 GPT-4o、Claude 3.5 Sonnet、DeepSeek-V3、Gemini 1.5 等代表版本的上下文窗口与单次输出上限。本文说明如何按「输入 + 预留输出 ≤ 窗口」计算 token 预算,并按任务选择窗口档位。遇到输出截断时,可以用 finish_reason 和 usage 定位原因。文中也给出应对长上下文带来的延迟、注意力衰减和 TPM 限流的做法。
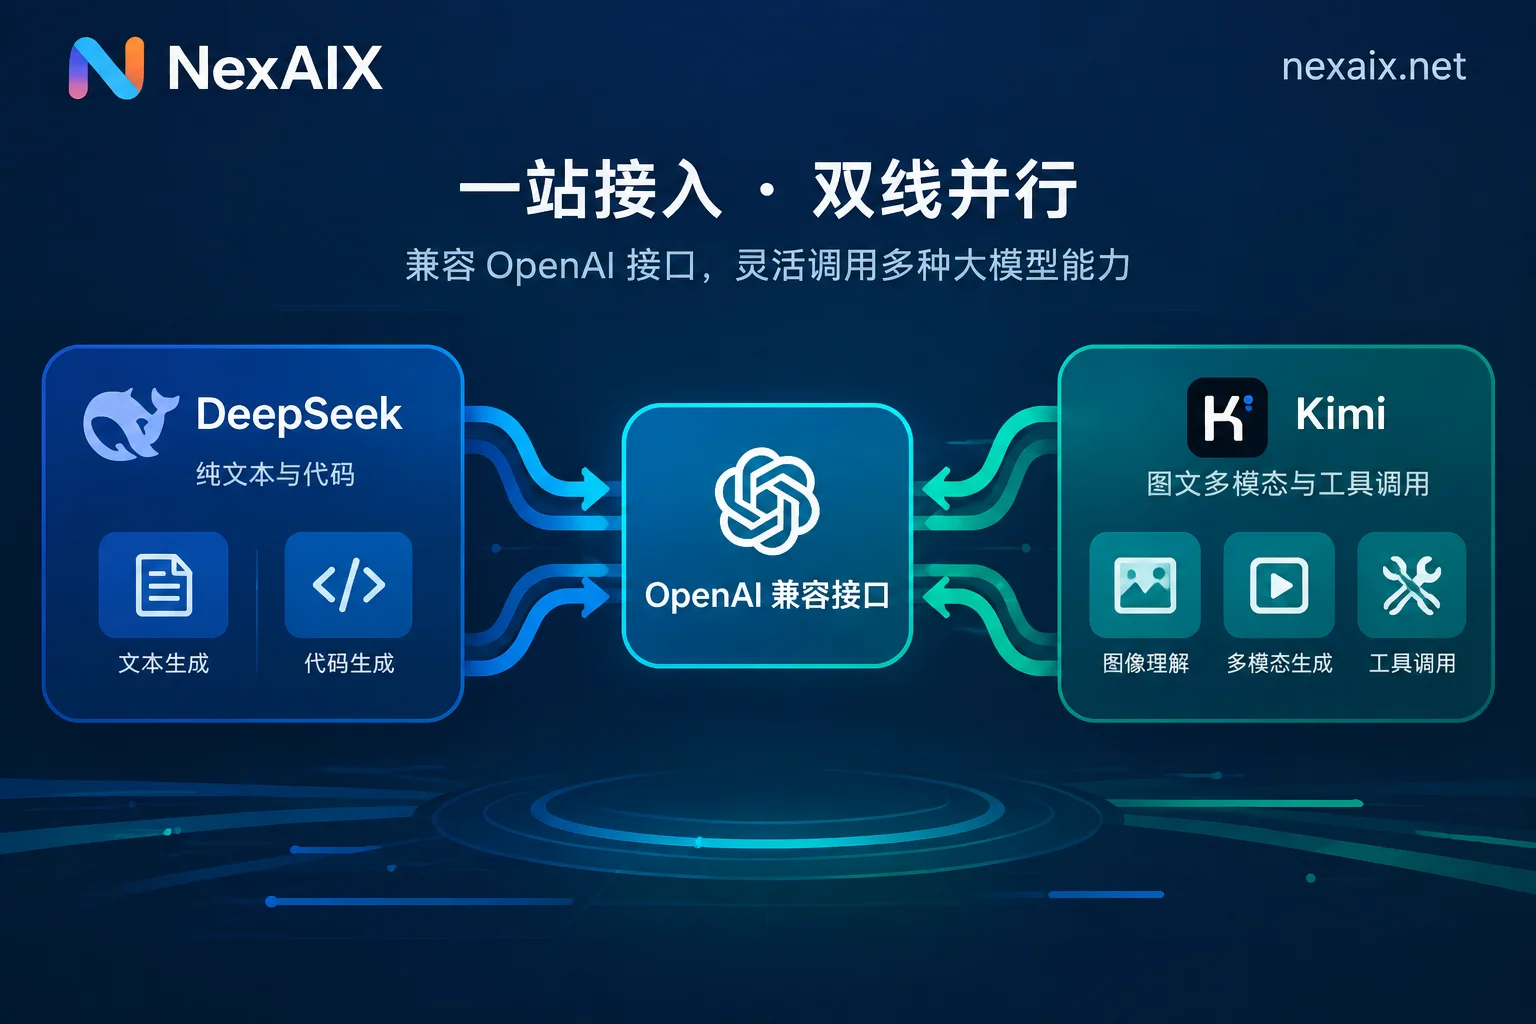
本文对比 DeepSeek 与 Kimi(Moonshot)API 在模型阵容、上下文长度、多模态、思考模式参数和多轮 reasoning_content 回传上的差异。文章先按任务给出选型建议,再说明用同一套 OpenAI 兼容代码切换两家时需要分开处理的地方,以及上线前应该验证的几项内容。
0 条留言
 NexAIX-官方博客