 NexAIX-官方博客
流式输出本身没多少代码量:请求体里加 stream: true,响应变成 Content-Type: text/event-stream 的分块传输,每条消息是一行 data: 加一个 JSON,增量文本在 choices[0].delta.content,读到 data: [DONE] 就结束。
真正让人排查一下午的是另外四件事:解析器在边界情况上写漏了、流式默认拿不到 Token 用量、反向代理把流缓冲成了一次性输出、以及用户关掉页面后上游还在生成。下面按这个顺序说。
先用 curl 拿到一条基准线
不管你后面用什么框架,第一步都建议先在命令行打一发,确认上游本身是逐块出的:
curl -N https://api.nexaix.net/v1/chat/completions \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "<你要用的模型名>",
    "stream": true,
    "messages": [{"role": "user", "content": "用三句话介绍一下你自己"}]
  }'
-N 关掉 curl 自己的输出缓冲,不加这个参数你看到的可能是 curl 在骗你。
这条命令的价值在后面:只要它是逐字往外蹦的,之后任何「流式不流」的问题就都在你自己的链路里,不用再怀疑上游。
解析:四个容易写漏的分支
用官方或兼容 SDK 时,循环体应该长这样:
stream = client.chat.completions.create(
    model=MODEL,
    messages=messages,
    stream=True,
)

for chunk in stream:
    if not chunk.choices:      # usage chunk 的 choices 是空数组
        continue
    delta = chunk.choices[0].delta.content
    if delta:                  # 首包只有 role,结束包 content 为 None
        print(delta, end="", flush=True)
两个判断都不是防御性冗余:带 usage 的那个 chunk 里 choices 确实是空列表,直接取下标会抛 IndexError;而首包通常只带 role,工具调用的增量走的是 delta.tool_calls 而不是 content,结束包的 content 是 None。
如果你不是用 SDK,而是在写网关、或者在 Go/Java 里裸接 HTTP,还有两处必须自己处理:
- 一个网络包不等于一条事件。 TCP 分包会把一条
data:行从中间切开。必须维护一个字符串缓冲区,按\n\n切出完整事件再解析,剩下的半截留给下一次读取。这是自研解析器最常见的 bug,表现是低并发下正常、一上量就偶发 JSON 解析失败。 [DONE]不是 JSON。 先判断 payload 是否等于[DONE]再送进json.Unmarshal。同时忽略以:开头的注释行(有些服务端用它发心跳保活)和空行。
Token 用量:默认不给,要显式要
流式模式下服务端默认不返回总用量。需要统计就在请求体里加一行:
{
  "stream": true,
  "stream_options": { "include_usage": true }
}
开启后,在 [DONE] 之前的最后一个 chunk 会带上 usage 字段,包含 prompt_tokens、completion_tokens 和 total_tokens,而这个 chunk 的 choices 是空数组——也就是上面那个 if not chunk.choices 分支要放行去读 usage 的地方。
几点实操上的提醒:
- 别在客户端按字符数估算用量去做计费或配额扣减,中英文、思维链、工具调用的 token 比例差得很远,以服务端返回的 usage 为准。
- 如果连接中途断了,你就收不到那个 usage chunk。所以统计逻辑要有兜底:记录请求已进入生成状态、事后与账单对账,而不是默认「没收到 usage 就是没消耗」。
stream_options是 OpenAI 兼容规范里的字段,但不同模型、不同后端推理引擎的实现细节可能有出入。接入一个新模型时,先用上面那条 curl 加上这个参数打一发,确认最后一个 chunk 里确实有 usage,再决定统计口径。
流式变成「一次性全量吐出」怎么查
这是上生产后最高频的故障:本地开发好好的,部署到服务器就变成转圈十几秒然后整段文字啪地出现。
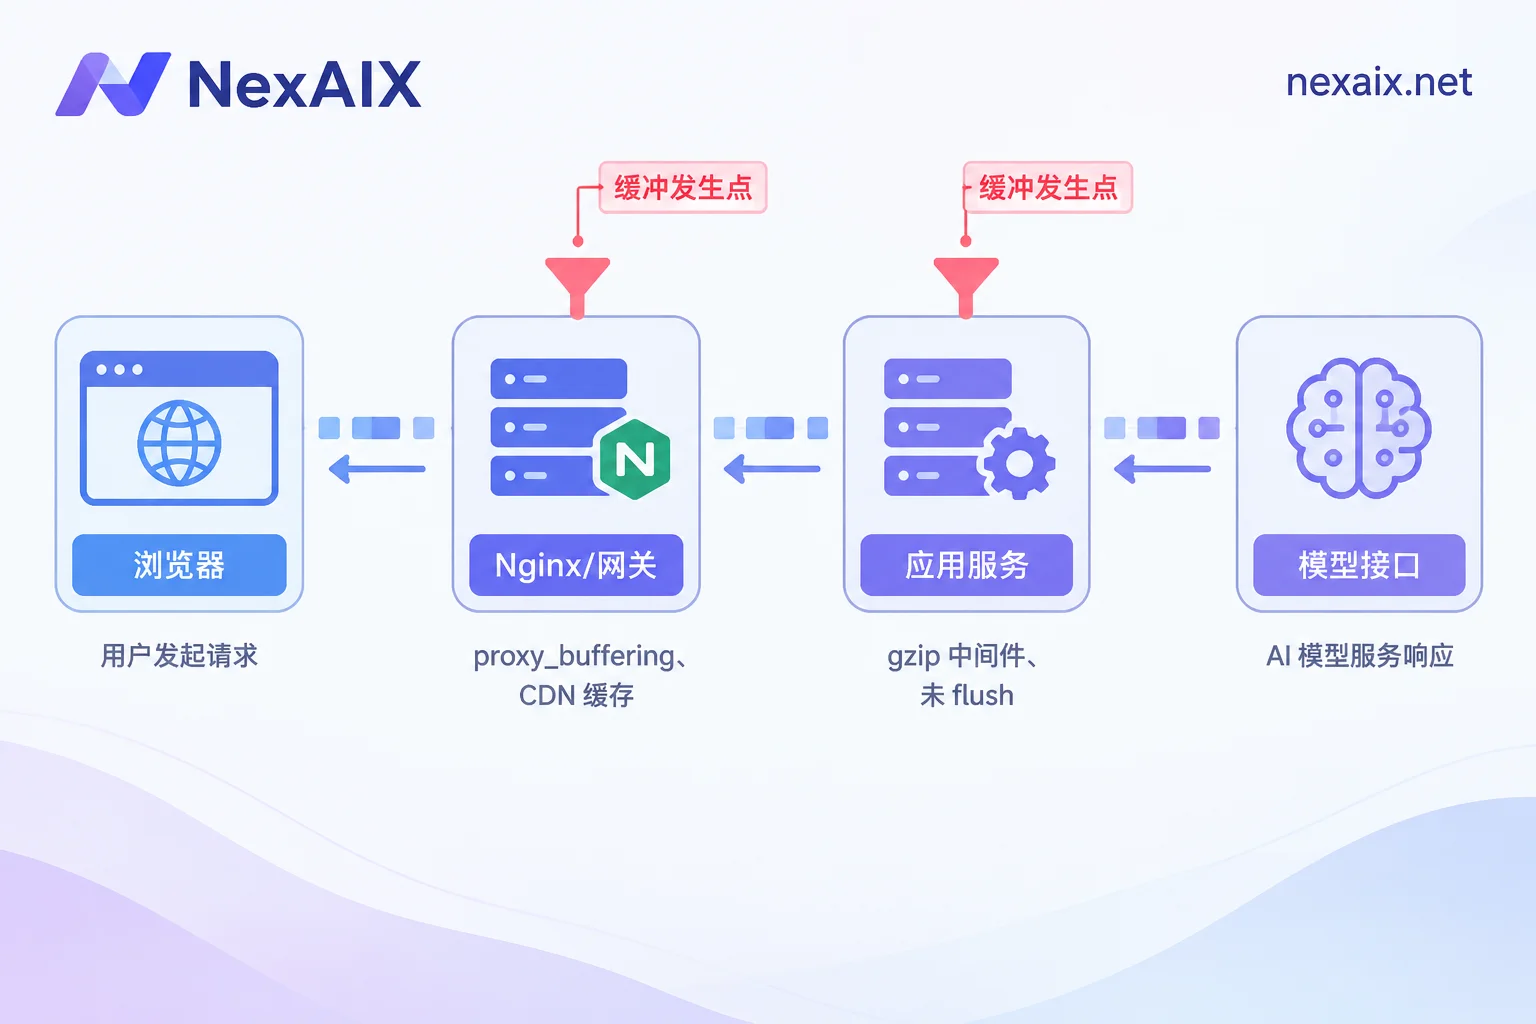
按这个顺序查,一层一层往回退:
第 1 步,确认上游正常。 在服务器上跑 curl -N 直连模型接口。逐字出 → 问题在你自己的链路里,继续往下;不逐字 → 问题在上游或出口网络。
第 2 步,绕过反向代理直连应用端口。 比如应用跑在 8080,就 curl -N http://127.0.0.1:8080/...。这一步能把范围一刀切开:
- 直连正常、走域名不正常 → 是 Nginx / 网关 / CDN 的缓冲。
- 直连也不正常 → 是应用层的问题,往下看第 4 步。
第 3 步,改反向代理配置。 Nginx 默认开启响应缓冲,它会攒够一个 buffer 才往下发,SSE 就失效了:
location /api/ {
    proxy_pass http://127.0.0.1:8080;
    proxy_http_version 1.1;
    proxy_set_header Connection '';

    proxy_buffering off;
    proxy_cache off;
    gzip off;

    proxy_read_timeout 600s;   # 长回答容易撞上默认 60s
}
proxy_read_timeout 单独说一句:它管的是两次读取之间的间隔。长文生成、或者模型在推理阶段久久不吐第一个 token,都可能超过默认值,表现是流到一半连接被掐断、前端收到不完整的回答。调大它,或者让服务端定期发心跳注释行。
如果你改不了 nginx.conf(共享网关、托管平台、前面还套了 CDN),退而求其次的办法是让应用在响应头里加 X-Accel-Buffering: no,Nginx 和不少网关会据此对这一个响应关闭缓冲。这个办法的好处是不影响其他接口。
第 4 步,查应用自己的缓冲。 常见的有:全局 gzip 压缩中间件(压缩需要攒数据)、框架的响应缓冲没有 flush、以及某些 serverless 运行时不支持流式响应。写响应时确认每块都调用了 flush。
另有一类「假缓冲」值得区分:首 token 延迟(TTFT)本来就长。判断方法是看时间分布——如果第一个 chunk 等了 8 秒,但之后 chunk 之间只隔几十毫秒,那就不是缓冲,而是排队或 prompt 太长导致的预填充慢,改 Nginx 没用。如果第一个 chunk 等了 8 秒、然后所有内容一起到达,那才是缓冲。
浏览器端:为什么不能用 EventSource
浏览器原生的 EventSource 只支持 GET,而且不能自定义请求头,没法带 Authorization,也没法把 messages 放进 POST body。对话接口是 POST /v1/chat/completions,所以前端通常用 fetch 配合 ReadableStream 手动解析,或者用 @microsoft/fetch-event-source 这类库省掉解析代码。
手写版本的骨架:
const controller = new AbortController();
const res = await fetch("/api/chat", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({ messages }),
  signal: controller.signal,
});

const reader = res.body.getReader();
const decoder = new TextDecoder();
let buf = "";

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buf += decoder.decode(value, { stream: true });

  let idx;
  while ((idx = buf.indexOf("\n\n")) !== -1) {
    const raw = buf.slice(0, idx);
    buf = buf.slice(idx + 2);
    for (const line of raw.split("\n")) {
      if (!line.startsWith("data:")) continue;
      const payload = line.slice(5).trim();
      if (payload === "[DONE]") return;
      const delta = JSON.parse(payload).choices?.[0]?.delta?.content;
      if (delta) appendToUI(delta);
    }
  }
}
注意这里 fetch 的目标是 /api/chat,也就是你自己的后端,而不是模型接口。API Key 放进前端代码或前端请求头,等于公开发布;流式场景也不例外,必须由后端转发。
断连、中止与错误结束
长连接会断,用户也会主动点「停止」。这两种情况都需要把中止信号一路传到上游,否则模型那边还在继续生成,占着并发额度空耗。
Node 后端的典型写法:
app.post("/api/chat", async (req, res) => {
  const controller = new AbortController();
  req.on("close", () => controller.abort());   // 客户端断开 → 中止上游

  res.setHeader("Content-Type", "text/event-stream");
  res.setHeader("Cache-Control", "no-cache");
  res.setHeader("X-Accel-Buffering", "no");
  res.flushHeaders();

  const stream = await client.chat.completions.create(
    {
      model: MODEL,
      messages: req.body.messages,
      stream: true,
      stream_options: { include_usage: true },
    },
    { signal: controller.signal }
  );

  for await (const chunk of stream) {
    if (chunk.usage) recordUsage(chunk.usage);
    const delta = chunk.choices?.[0]?.delta?.content;
    if (delta) res.write(`data: ${JSON.stringify({ delta })}\n\n`);
  }
  res.write("data: [DONE]\n\n");
  res.end();
});
再补三条边界处理:
判断「是否正常结束」,靠有没有收到 [DONE](或 SDK 的结束信号),不要只看有没有抛异常。 流式在生成中途出错时,可能是一条内联的错误事件,也可能是连接直接断开、循环自然退出——后者在代码里看起来和正常结束一模一样。把「收到终止哨兵」记成一个显式标志位,没有这个标志的回答一律按未完成处理。
已经吐出的部分内容要落库并标记未完成。 用户看到了半段回答,刷新页面后它不该凭空消失,也不该被当成完整回答喂进下一轮上下文。
流式的重试和普通请求不一样。 已经输出到一半再重放,用户会看到内容重来一遍。通常的分界线是:一个 token 都没收到时才自动重试;已有输出就交给用户决定重新生成还是接受截断。具体该重试哪些错误码、退避等多久,可以看这篇关于重试设计的文章;如果断连伴随的是 429,先按限流处理的思路看响应头再决定等待时间。
换模型时要确认的两件事
流式这套代码写好之后复用度很高:在 OpenAI 兼容端点之间切换,基本上只改 base_url 和 model 名,解析逻辑不动。NexAIX 的端点是 https://api.nexaix.net/v1,接入现有代码时改的就是这一行。
但选模型时有两件事会直接影响流式表现,值得在压测前确认:
一是这个模型的供给方式。开源权重模型部署在自有算力集群,闭源模型走厂商官方授权渠道,两者的首 token 延迟特征和接口行为细节不完全一样,模型页上标明了每个模型属于哪一种,选之前扫一眼:模型清单与供给方式。
二是配额与限速。流式请求占用连接的时间比非流式长得多,做并发估算时,先撞上限的往往是并发连接数而不是 token 吞吐。配额和限速是公开的,按 Key 隔离——实践中建议给流式压测单独开一把 Key,跑崩了也不会波及线上那把。
注册有测试额度,把本文开头那条 curl -N 跑通、确认最后一个 chunk 里有 usage,再决定要不要往下接,比读文档快。
上线前对一遍
- 解析器覆盖了空
choices、content为None、[DONE]非 JSON、事件跨包四种情况 stream_options.include_usage已开启,且实测确认这个模型会返回 usage- 反向代理关闭了 buffering、cache、gzip,
proxy_read_timeout大于最长回答耗时 - 客户端断开能触发上游 abort,日志里能看到中止记录
- 未收到
[DONE]的回答被标记为未完成,不会被当成完整结果复用 - API Key 只存在于服务端



评论(0)