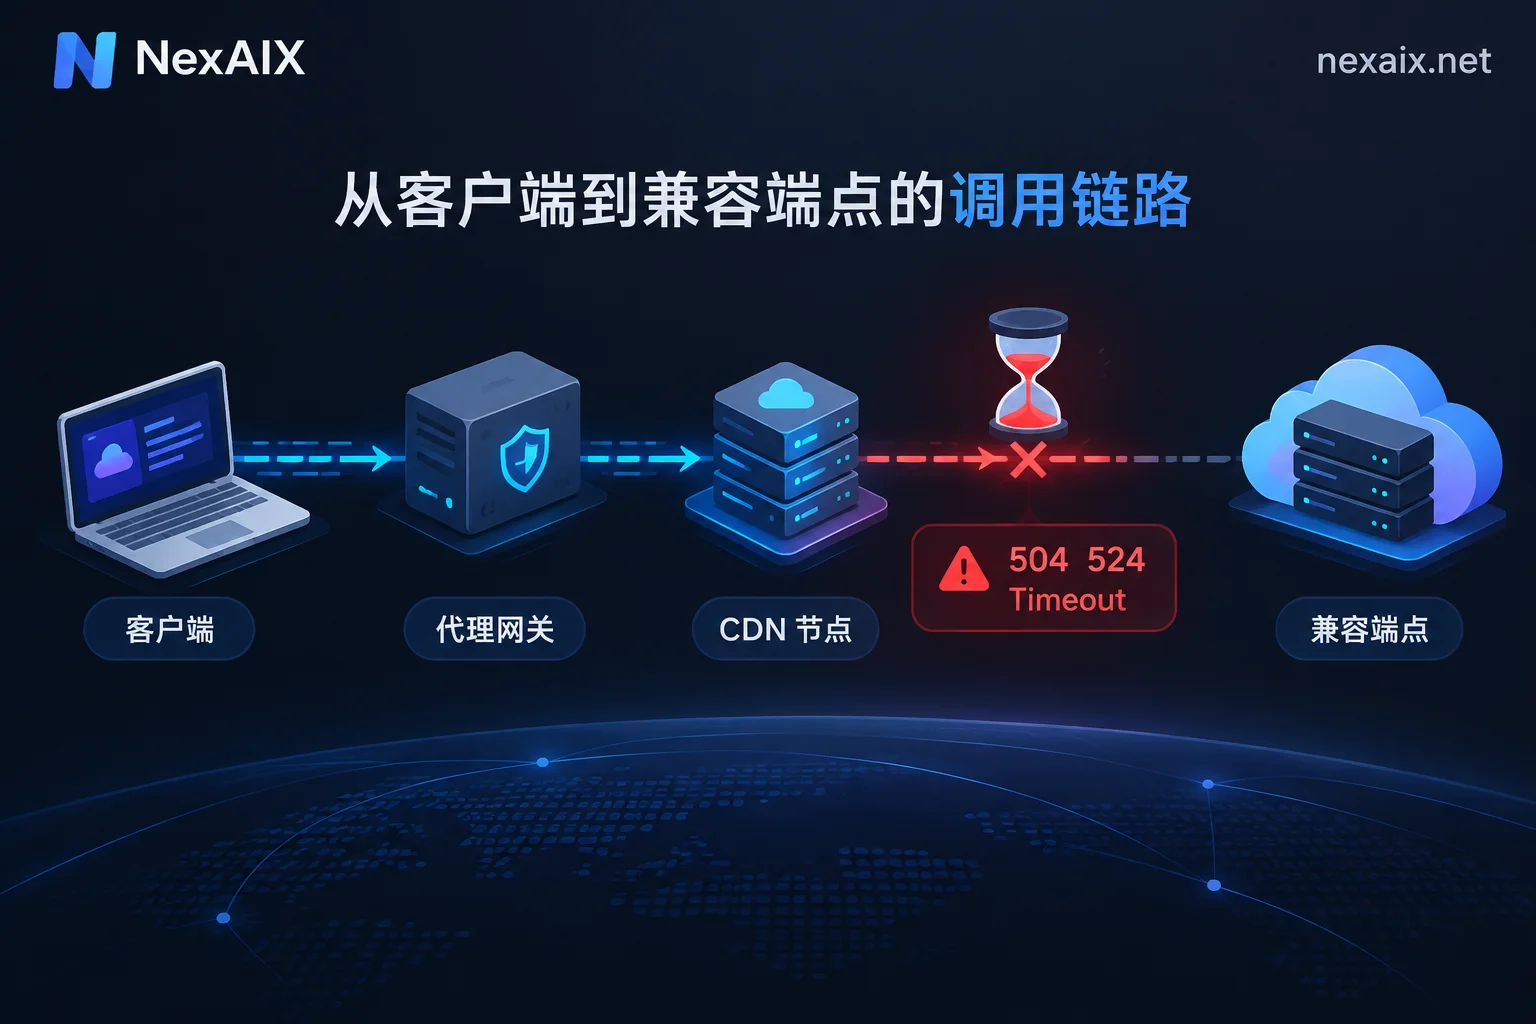
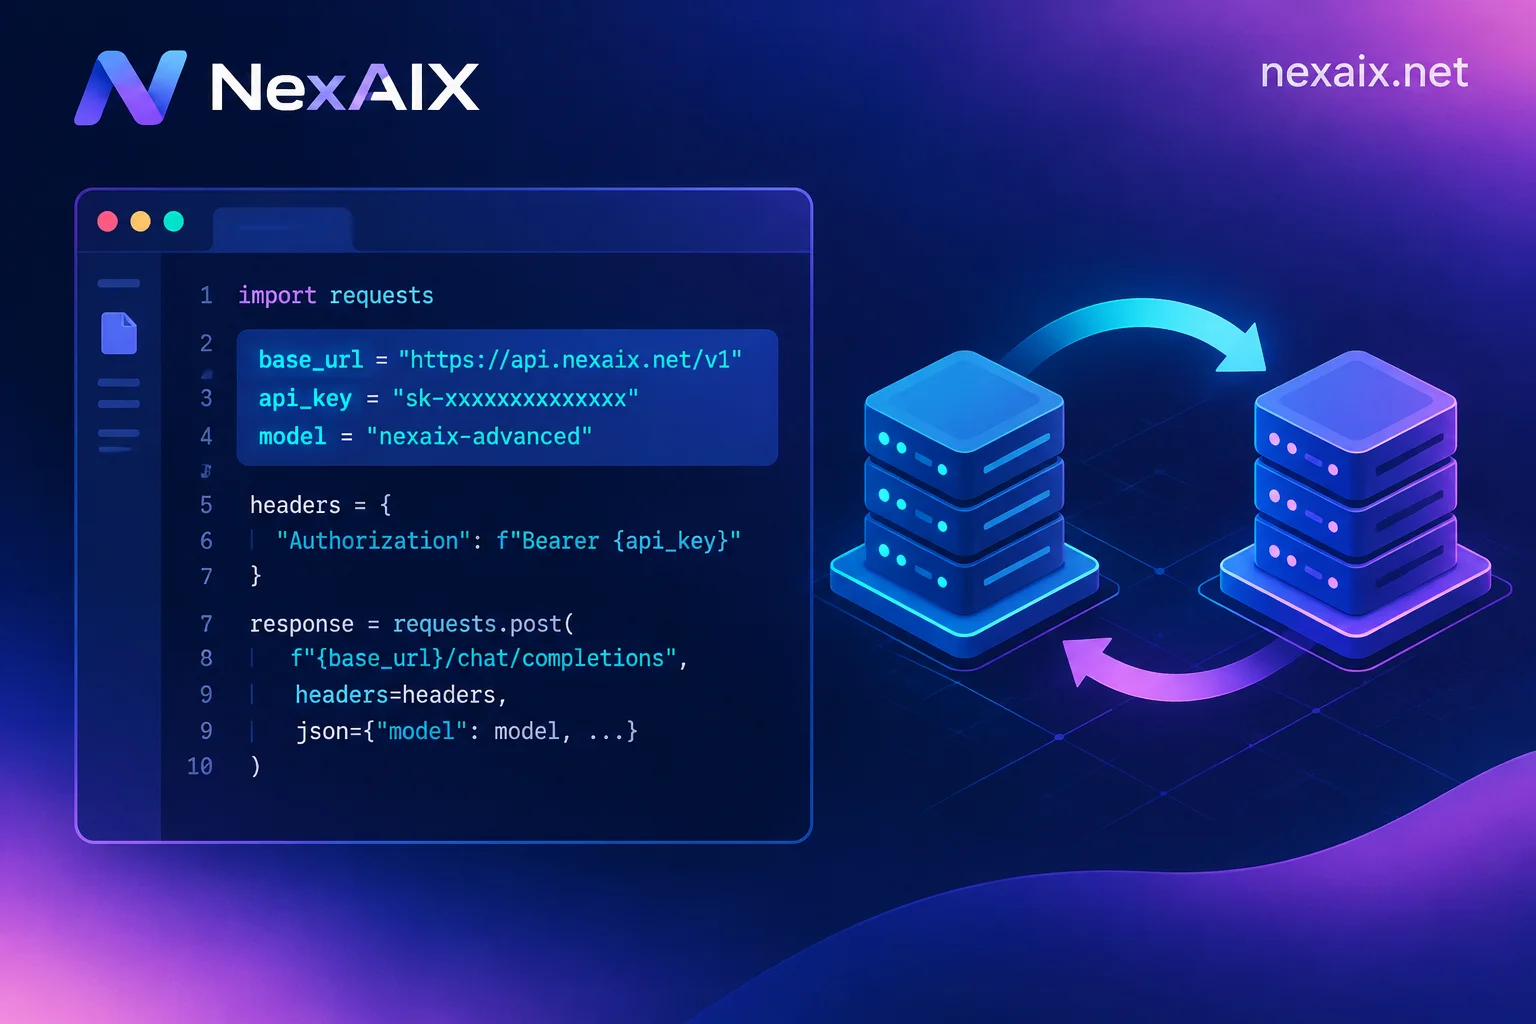
大模型请求超时,大多是长上下文和长输出的耗时超过了客户端、Nginx 或 Cloudflare 的默认等待时间。本文按“判断断点、开启流式、分段设置超时、调整代理、控制重试和输出长度”的顺序,给出 Python SDK 与 Nginx 的配置示例,并说明各项设置的适用条件。
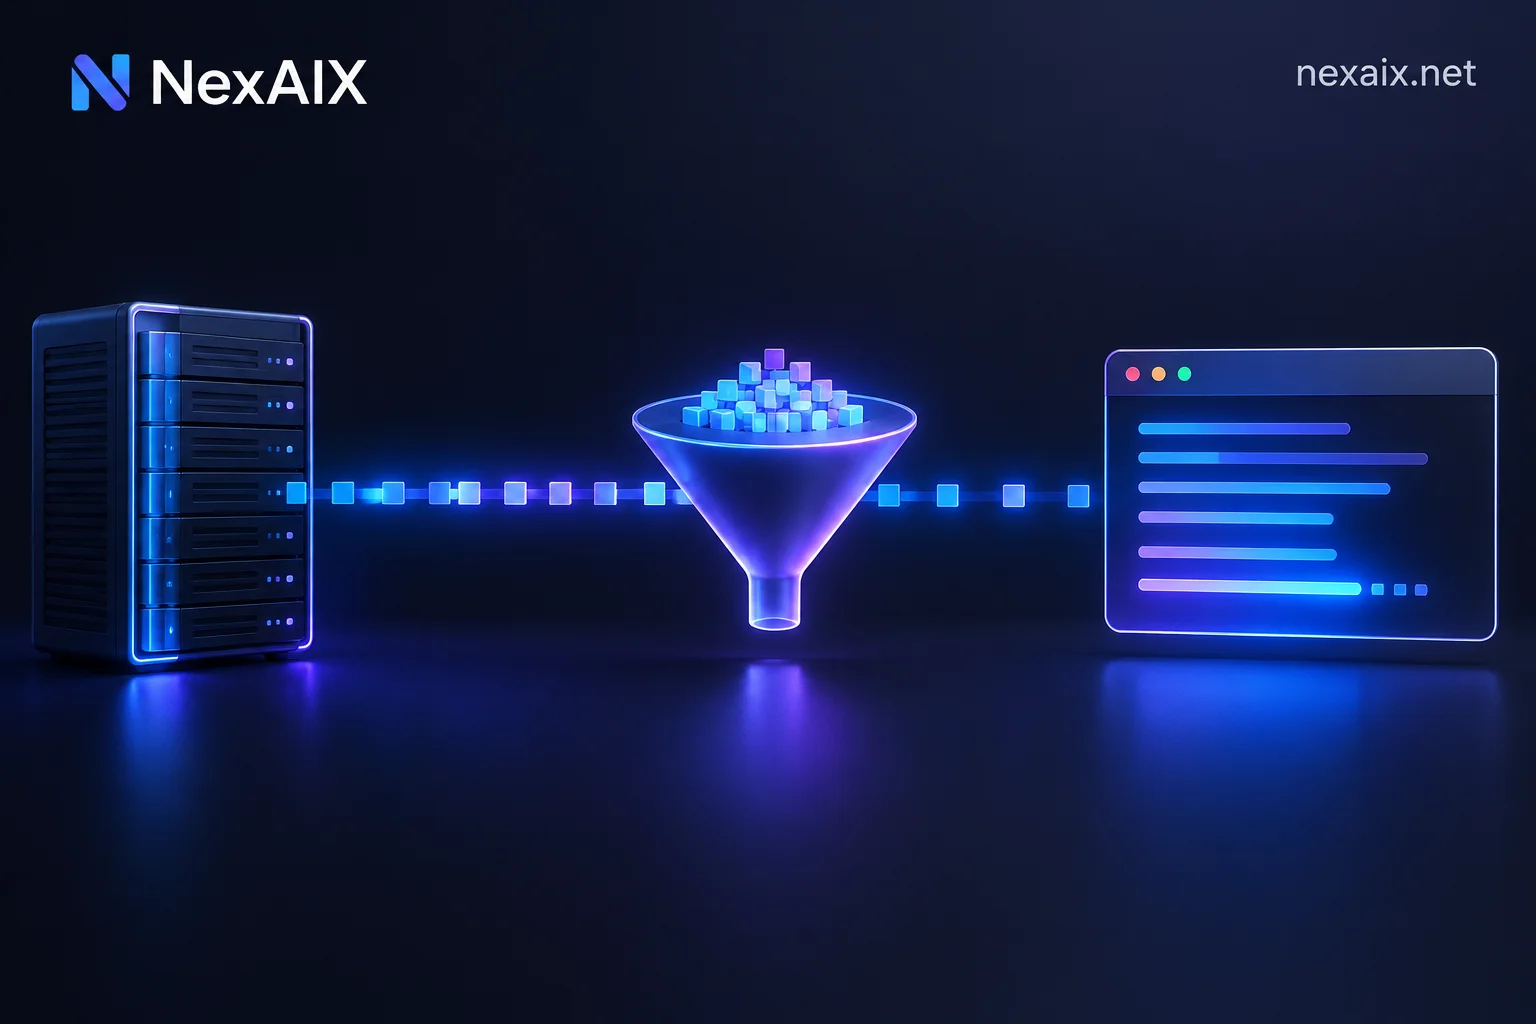
从一条能跑通的 curl 开始,讲清流式输出 API 的 SSE 报文结构、解析时容易漏掉的空 choices 与跨包问题、如何用 stream_options 拿到 Token 用量、反向代理缓冲导致「一次性吐出」的排查顺序,以及客户端断连时怎样中止上游请求。
0 条留言
 NexAIX-官方博客