 NexAIX-官方博客
先给结论:切到 Opus 5 只需要动这 5 处
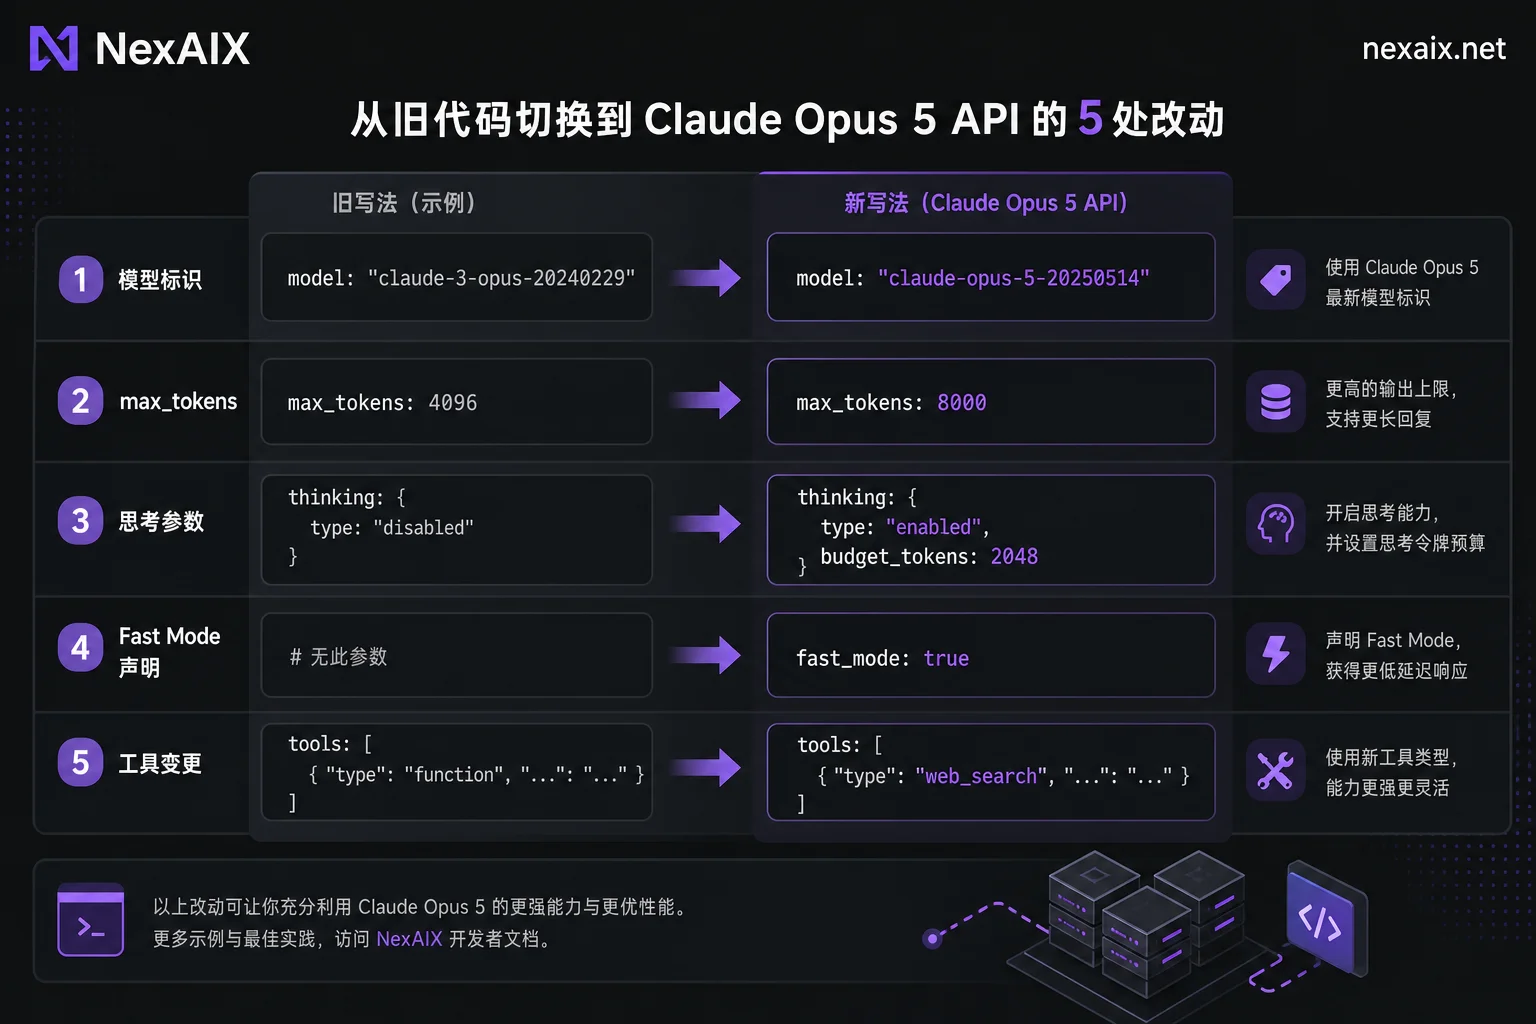
Claude Opus 5 API 单次输出最大 128000 tokens,超出一律返回 invalid_request_error。切换接入时,你原有的 Messages 或 OpenAI 兼容调用链路不用推倒重来,只需照下面这张表逐项核对请求字段:
| 改动点 | 旧写法(常见默认) | 新写法(Opus 5) | 不改的症状 |
|---|---|---|---|
| 模型标识 | claude-3-5-sonnet | claude-opus-5(或官方文档当前标识) | 请求 404 或命中旧模型 |
| 输出档位 | max_tokens: 8192 | max_tokens: 128000(上限) | 超过 128K 报 400,长文被截断 |
| 上下文预算 | 未显式分配 | 输入 + 输出 ≤ 1,000,000 tokens | 请求超限,输出被挤掉 |
| 思考传参 | budget_tokens: 4096 | effort: medium(low/high/max) | 400 错误,旧参数已禁用 |
| 工具变更 | 顶层 tools 数组整体替换 | 系统消息内 tool_addition / tool_removal 块 | Prompt Cache 前缀失效,历史不一致 |
其中模型标识、128K 上限、思考参数属于硬性规范,不改直接报错;上下文预算与工具增删属于工程优化,但会影响长任务稳定性。上述规格以 Anthropic 官方文档与平台模型页当前标注为准。若切换后遇到 400 参数校验报错,可对照 Claude API 400排查 逐项排查。
改动一:模型标识与 128K 输出档位怎么声明,超限返回什么
在 Claude Opus 5 API 的请求体里,model 字段直接写官方标识,max_tokens 最大声明为 128000。若你手滑填了 128001 或更大,API 会返回 invalid_request_error 参数校验错误,而不是自动截断。建议在客户端做一次前置校验,把 400 错误拦在发出请求之前。
一个可复制的最小请求片段(已省略认证字段):
{
  "model": "claude-opus-5",
  "max_tokens": 128000,
  "messages": [{"role": "user", "content": "写一篇长报告"}]
}
“claude opus 5 最大输出 128k 怎么设置”的关键就是 max_tokens 显式声明到 128000,别再用旧模型常见的 4K/8K 默认值。
改动二:1M 上下文的预算分配,输入塞多少才不会挤掉输出
Opus 5 的上下文窗口上限是 1,000,000 tokens,但这个窗口是输入加输出的总账,不是输入随便塞满 1M 还能保证 128K 输出。长文任务建议按最坏情况预留输出预算:
可用输入窗口 = 1,000,000 - max_tokens(计划输出上限)截断优先级可参考:系统提示 > 工具定义 > 近期对话轮次 > 历史摘要。把这条公式写进你的上下文管理模块,比事后撞 400 强得多。具体计费与窗口细分,可参考 长上下文API选型 并留意官方定价页标注。
改动三:自适应思考默认开启后,多轮历史与 thinking 块怎么传
Opus 5 默认启用自适应思考,通过 effort 参数(low / medium / high / max)调节思考强度。旧版固定 budget_tokens 传参已被禁,传了就返回 400。
在多轮对话和工具调用链条里,你必须完整保留并回传历史 turns 中的 thinking blocks,否则会破坏思考连续性甚至直接报错。常见的坏写法有三种:
- 客户端只保留 text 块,把 thinking 块丢了;
- 做历史压缩时顺手删掉 thinking;
- 跨网关转换格式时丢了 thinking 字段。
如果你用 OpenAI SDK 兼容多轮对话,传思考历史的方式可以参考 OpenAI SDK兼容多轮对话传思考历史 中的做法,原理相通。
改动四:Fast Mode 档位怎么开,哪些链路值得用
开启 Fast Mode 只需在请求里加 speed: "fast" 参数并带上对应 fast-mode beta 标头。输出生成速度约提升 2.5 倍,模型权重与推理质量完全一致,不是蒸馏或静默降级。具体机制可参考 Claude Platform Docs 的 Fast mode 文档。
适合开 Fast Mode 的场景:延迟敏感的交互式 Agent 循环、短工具调用轮次。不适合:批处理与超长离线生成对首 token 延迟不敏感,加速带来的体感收益有限;Fast Mode 是否影响计费以官方定价页与服务商模型页标注为准。
改动五:会话中途增删 tools,状态机要怎么改
会话中途改工具本身不会报错,但直接替换顶层 tools 数组会让前序 Prompt Cache 全部失效,历史上下文也容易错乱。正确做法是使用 Mid-conversation tool changes 能力:依赖 mid-conversation-tool-changes-2026-07-01 标头,在 messages 数组中插入一条 role: 'system' 消息,内容块为 tool_addition 或 tool_removal,而不是重写全局 tools 数组。这样既能增删工具,又能保持前序缓存命中。
注意:该能力在 Messages API 中属于 beta 功能,协议细节可参考 Mid-conversation system messages 文档,部分第三方网关可能尚未适配,接入前请查阅服务商文档确认协议映射。工具调用 API 的整体设计可参考 工具调用API。
长程 Agent 的最小骨架:工具集分阶段收敛怎么写
把上面五处改动串起来,一个长程 Agent 可以这样组织:初始阶段只声明规划类工具,进入执行阶段后用 tool_addition 注入领域工具,阶段结束用 tool_removal 收掉,同时保留 thinking blocks 和缓存前缀。
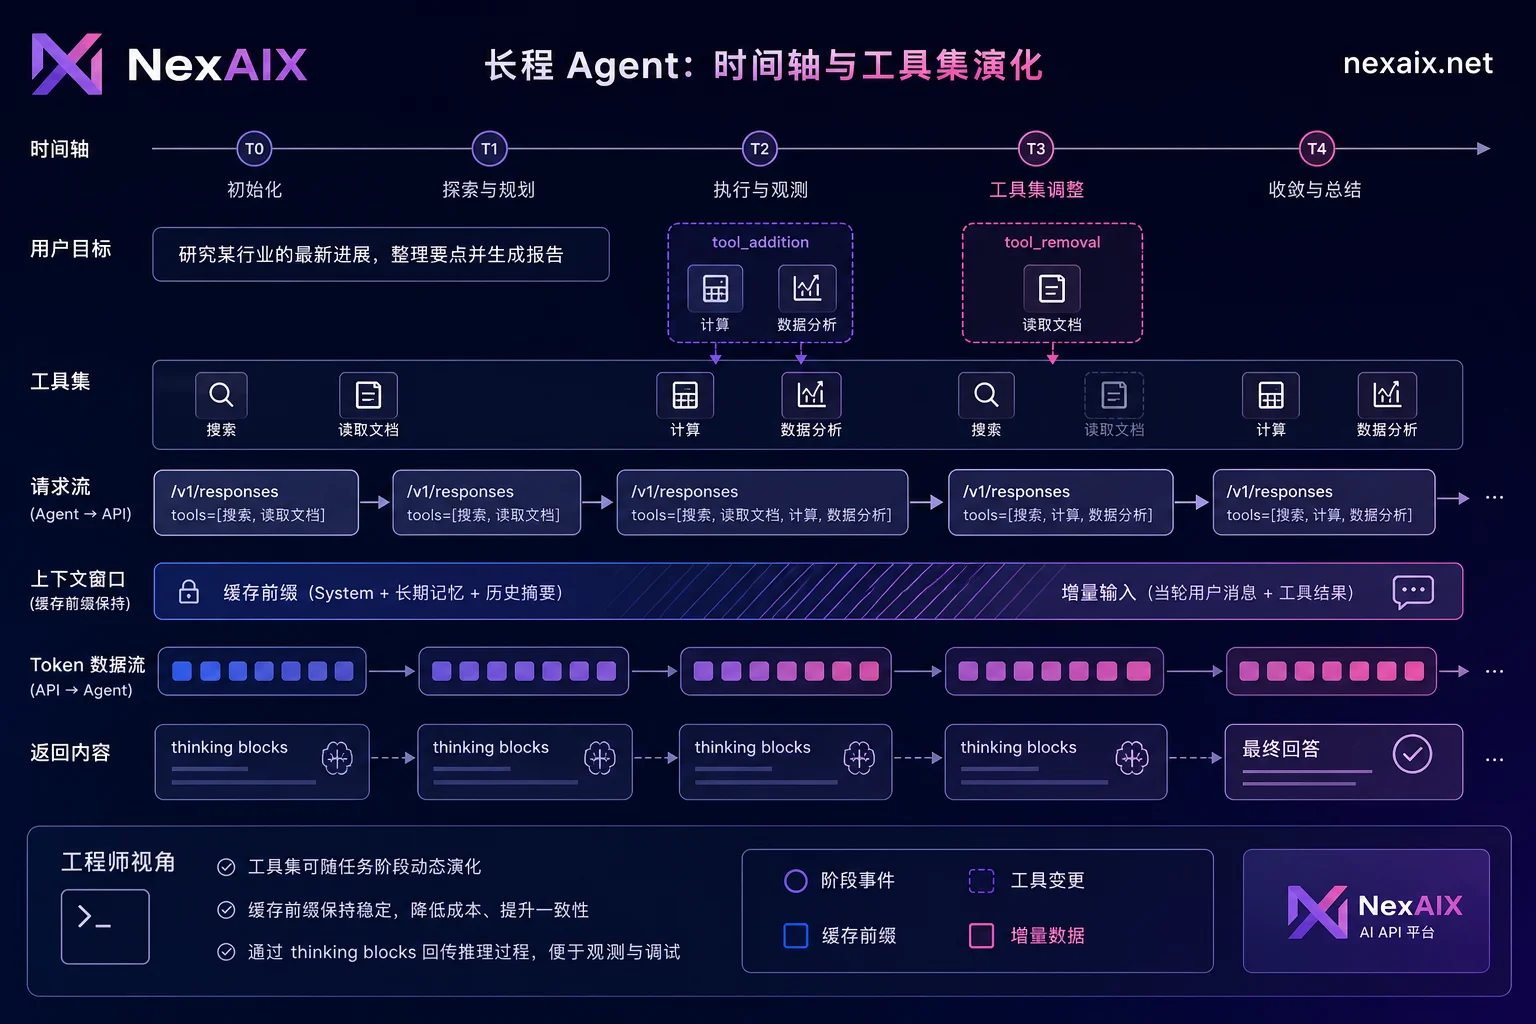
按阶段切换 effort 与 Fast Mode,能兼顾质量与延迟。状态机里要额外记录“当前生效工具集”,以便断线重放时恢复现场。
官方已确认 vs 必须自测:长上下文并发下的首 token 只能自己压
1M 上下文、128K 输出、effort 参数、Fast Mode 加速倍数、工具增删语法,这些是官方或权威平台已确认的规格。但“1M 上下文高并发下的 TTFT 零延迟衰减”这类说法属于网络传闻,官方没有公开统一 SLA。
自测方法:固定输入长度分档(如 100K、500K、1M),固定并发梯度(如 1、5、10),分别记录 TTFT 与整段完成时间,重复多轮取 P50/P95 分位数。
改完必测:接入后的回归清单
下面这份清单覆盖 Claude Opus 5 API 接入后最容易出问题的六个点。
- [ ] 流式输出与 thinking 块顺序是否正常
- [ ] 工具调用多轮回传是否完整
- [ ] 超长输出接近 128K 时的截断与 stop_reason
- [ ] 上下文接近 1M 上限时的行为
- [ ] 超时与 429 退避策略
- [ ] 错误码归因(400/404/429)
这份清单要在新旧模型上各跑一遍才有意义。做对照回归时,同一套 OpenAI 兼容代码只换 model 字段,就能在 NexAIX 上跑对比测试,base_url 为 https://api.nexaix.net/v1,支持流式输出与函数/工具调用。NexAIX 在模型满载时返回标准 429 与重试建议,不会静默切换到更便宜模型,返回体的 model 字段就是实际执行模型,方便你把失败归因到参数、网关还是容量。具体规格与价格以 NexAIX 模型页和更新日志为准。
常见问题
adaptive thinking 能不能关掉?
不能完全关掉。只能通过 effort 参数调节强度(low/medium/high/max),旧版 budget_tokens 传参已失效并返回 400。这一限制同样适用于 Claude Opus 5 API 接入后的思考参数配置。
opus 5 上下文窗口最大多少?
原生支持 1,000,000 tokens。注意这是输入与输出的总和,规划请求时需预留输出预算。
claude opus 5 最大输出 128k 怎么设置?
请求体里把 max_tokens 设为 128000,超过会触发 invalid_request_error。
Fast Mode 是否降质?
不降质。Fast Mode 使用完全相同的 Opus 权重,只是推理基础设施加速,输出 token 生成速度约提升 2.5 倍。
会话中途修改 tools 列表会报错吗?
不会直接报错,但直接改全局 tools 数组会让 Prompt Cache 失效。应用 tool_addition / tool_removal 系统消息来变更,才能保持历史与缓存一致。
Claude Opus 5 和 Sonnet 5 怎么选?
按任务推理强度、延迟和成本判断:复杂规划、长文推理选 Opus 5;高频、低延迟、成本敏感场景选 Sonnet 5。具体数值以官方文档为准。



评论(0)