 NexAIX-官方博客
如果你手上已经有一套基于 OpenAI SDK 的代码,想换成 Claude 跑,真正的成本通常不在模型能力,而在四个具体位置:system 参数放哪、messages 的结构约束、工具调用结果怎么回传、流式事件怎么解析。这四处改完,剩下的才是选型问题。反过来,如果是新项目还没写调用代码,先定协议比先定模型更省事。
先按任务分一次
- 长文档处理、跨文件代码改动、需要严格照着复杂系统指令走的流程:Claude 系列的理由是原生大上下文(普遍 200K 及以上)、长链条多步推理和代码任务上的表现,以及对复杂指令的遵循比较稳。
- 语音转写、TTS、实时语音这类多模态管线,或者需要一层高吞吐低延迟小模型做前置分流:GPT 系列周边更齐,且大量开源框架和 SDK 默认优先兼容 OpenAI 格式,接进去几乎不用改。
- 两边都做得了的通用文本任务:决定因素往往不是榜单分数,而是你现有代码是哪套协议、缓存能不能命中、配额和限速够不够你的并发。
具体模型版本和各自规格变动很快,选型时以模型页标注为准,别照着半年前的文章记型号。
两套协议差在哪
OpenAI 这边的主流标准是 POST /v1/chat/completions:messages 是一个扁平列表,system、user、assistant 都是数组里的一项,content 多数情况下直接是字符串。较新的 Responses API 是另一套参数组织方式,如果你同时维护两条路径,要当成两种格式看。
Anthropic 这边是 POST /v1/messages:system 被提到顶层,是独立参数而不是 messages 里的一项;messages 内部要求 user 和 assistant 严格交替,连续两条同角色需要合并;content 用结构化内容块(content blocks)组织,而不是一个字符串。
落到改造上,最常踩的两处:一是原来把系统提示拼在 messages[0],迁过去要抽出来放顶层;二是多轮历史里如果存在连续的 assistant 消息(工具调用中间态最容易出现),需要重新组装才能满足交替约束。
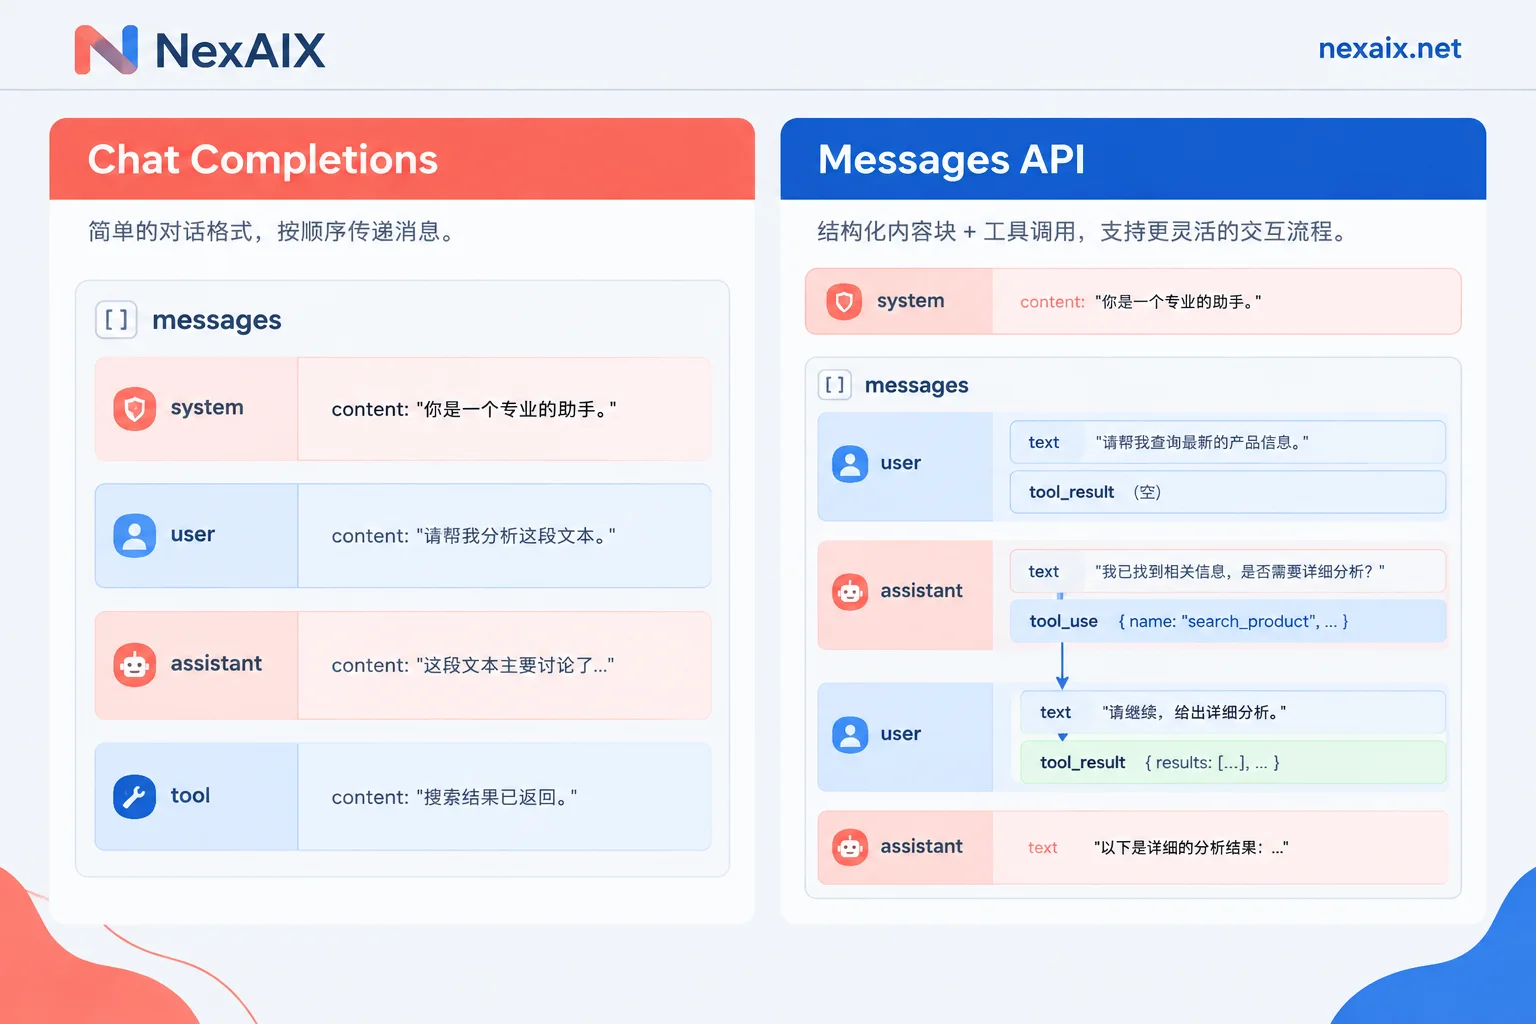
工具调用:状态组装方式不同
OpenAI 的路径是:模型在 assistant 消息里返回 tool_calls,你本地执行完,下一轮追加一条 role 为 tool 的独立消息,用 tool_call_id 对应回去。
Anthropic 的路径是:模型返回 tool_use 类型的内容块,你把 tool_result 类型的块放进下一条 user 消息里,用 tool_use_id 绑定。
差别的本质是:OpenAI 把工具结果当成一种独立角色,Anthropic 把它当成 user 回合里的一个块。用现成 Agent 框架时这段逻辑藏在执行器内部,你可能感觉不到;自己写工具循环就必须分开实现两套组装。工具循环本身怎么验证,可以参考Agent API 怎么接:从框架配置到工具调用的四个验证点。
流式:两种事件模型
OpenAI 侧你处理的是一连串 SSE chunk,从 delta.content 里取增量拼起来。Anthropic 侧是 content_block_start / content_block_delta / content_block_stop 这类事件,需要按块索引归位再拼装,尤其是同时有文本块和 tool_use 块的时候。两边的用量字段出现时机也不一样,统计 token 的代码别直接复用。流式解析和代理层卡顿的排查思路,见流式输出API怎么接:SSE 解析、Token 统计与代理卡顿排查。
Prompt Caching:一个自动,一个要你标
这是两家分歧最大、也最影响长期成本的一处。
OpenAI 是全自动策略:超过 1024 tokens 的静态前缀按 128 tokens 步长自动匹配,代码不用动,命中后输入部分大约减免一半成本。
Anthropic 是显式断点:你在请求里用 cache_control: {"type": "ephemeral"} 标出缓存边界。首次写入要付额外的写入费(约 1.25 倍),但命中读取的折扣可以到九成。代价是前缀顺序必须严格稳定。
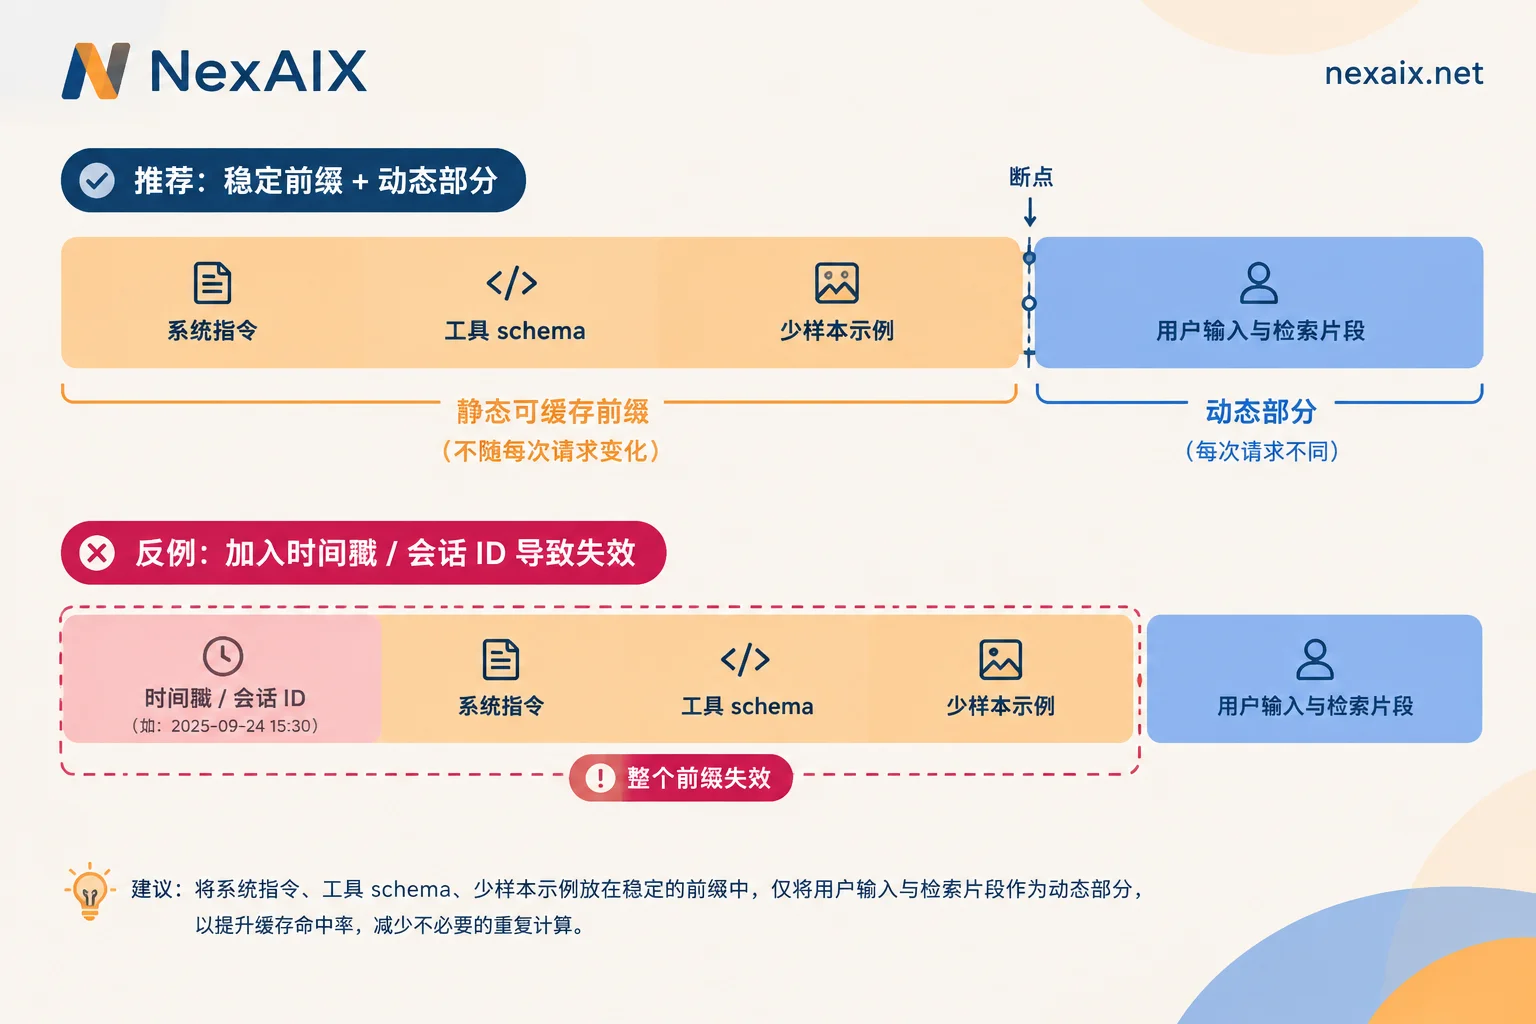
不管走哪边,实操结论是一样的:静态的系统指令、工具 schema、少样本示例排在前面,动态的用户输入和检索片段放后面。有些代码习惯把时间戳、会话 ID、当前日期拼在系统提示开头,这会让每次请求的前缀都不同,自动命中和显式断点会同时失效——查缓存不生效,先看这一处。
迁移:维护适配层,还是走统一端点
两条路,取舍很清楚。
一是在客户端写一层转换:把消息结构、工具回传、流式解析都做双向映射。好处是每个厂商的专有参数都能用到,坏处是上游接口一变你就得跟着改,两套流式解析长期都要测。
二是走 OpenAI 兼容端点:Chat Completions 格式已经是跨厂商适配的事实标准,网关把底层协议差异抹平,你只改 base_url 和 Key,就能在 GPT 和 Claude 模型之间切换调度。适合应用已经基于 OpenAI SDK 写好、想先把不同模型放在同一套代码里横向对比的情况。
NexAIX 属于第二条路:OpenAI 兼容端点 https://api.nexaix.net/v1,接入时只改 base_url。它的模型页会标明每个模型的供给方式——开源权重模型部署在自有算力集群,闭源模型走厂商官方授权渠道。这个标注值得先看一眼,因为它决定你拿到的是原厂行为还是自部署行为,会影响你对输出一致性的预期。当前上架了哪些模型、各自规格如何,以模型清单页为准。
一点边界要说清:如果你的成本模型重度依赖 Anthropic 的显式缓存断点,切到任何兼容端点之前,先确认 cache_control 这类专有参数是原样透传,还是由上游自行处理——这个以模型页和接入文档的说明为准,不要按经验假设。
上生产前把这四件事跑一遍
- 是否被降级。用固定 prompt 连跑几轮,对比输出完整度、实际可用上下文长度和 usage 字段是否稳定。换供给方之后这一步别省,NexAIX 把不换小模型、不降精度、不砍上下文写成承诺并给了验证方法,你也可以照同样思路验证任何渠道。注册就有测试额度,够跑一轮对照实验。
- 限流行为。读 429 返回的标头再决定退避,别固定 sleep。参考AI API 限流怎么处理?从 429 标头到退避重试与流量隔离和AI API 重试怎么设计。
- 截断判定。两家的最大输出参数和停止原因字段命名不同,迁移后如果你的代码只认一种,长回答会被静默当成正常结束。
- 对话内容的留存。厂商日志和中转层落盘是两层不同的风险,处理敏感数据前分别确认,可看AI API 隐私风险在哪两层。
最后一句判断:如果你的主要工作是长上下文推理和代码改动,且愿意为缓存写专门的前缀策略,值得让 Claude 侧的能力完整发挥;如果你的应用形态偏多模态管线、或者要在多个模型之间反复比价比效果,先把接入统一到 OpenAI 兼容格式,再去挑模型,返工最少。



评论(0)