 NexAIX-官方博客
手上有一个需要多步推理、带工具调用的任务,预算又不想跟着闭源旗舰走——gpt-oss-120b 是目前值得认真评估的一档。它是 OpenAI 在 2025 年 8 月以 Apache 2.0 协议发布的开源权重模型,混合专家架构,总参数约 117B,每次前向只激活 5.1B,靠 MXFP4 量化可以塞进单张 80GB 显存的卡(H100、MI300X 这一级)。对调用方来说,这三点决定了它的性价比区间和你要额外盯的风险。
先说结论式的判断,再讲参数和边界。
什么任务适合交给它
官方给出的定位是高推理密度与 Agent 类生产任务:核心推理基准接近 o4-mini,在数学、代码、函数调用与 Tau-Bench 这类工具使用评测上表现突出,原生支持完整思维链输出和 Structured Outputs。
落到实际场景,下面几类比较合适:
- Agent 主控循环。需要稳定按 schema 返回工具参数、多轮规划再收敛的场景,它的工具调用训练做得比较扎实。
- 代码辅助与重构分析。中等复杂度的跨文件推导、写测试、解释报错,不必每次都上闭源旗舰。
- 数据抽取与结构化输出。配合 JSON Schema 约束,比让小模型硬套模板稳。
- 推理强度可调的批处理。同一条链路上,简单条目用低档位、疑难条目升档,成本差别很明显。
反过来,纯粹的意图分类、短文改写、模板化客服回复这类活儿,用它是浪费——它默认要先生成一段思维链,首字延迟和 completion tokens 都比非推理模型高。这类任务该往更轻的模型上放。
多模态输入也不在它的能力范围内,涉及图片、音频的走别的型号。
接入:只改 base_url 这一行
gpt-oss-120b 完整兼容 OpenAI SDK 与 Responses API 协议。已经在用官方 SDK 的项目,改动只有两处——客户端的 base_url 指向你选的端点,model 换成对应的模型标识:
from openai import OpenAI

client = OpenAI(
    api_key="你的 Key",
    base_url="https://api.nexaix.net/v1",
)

resp = client.chat.completions.create(
    model="gpt-oss-120b",          # 以模型页标注的标识为准
    messages=[{"role": "user", "content": "..."}],
    reasoning_effort="medium",
    max_tokens=8000,
)
Node.js SDK 同理,改 baseURL。LangChain、LlamaIndex 这类框架里的 ChatOpenAI 类通常暴露 openai_api_base(或 base_url)参数,填同一个地址即可,不用换 provider 适配器。
模型标识是唯一容易踩坑的地方:不同平台对开源模型的命名不统一,有的带 openai/ 前缀,有的挂版本后缀。调用前去模型页确认一次实际字符串,比盯着报错猜省事。NexAIX 的模型清单页会标出每个模型的标识和供给方式——开源权重模型部署在自有算力集群,闭源模型走厂商官方授权渠道,gpt-oss-120b 属于前者。这个标注对后面要讲的验证环节有用:知道它是自有集群跑的权重,你才知道该验哪些指标。
reasoning_effort:延迟和成本的主要开关
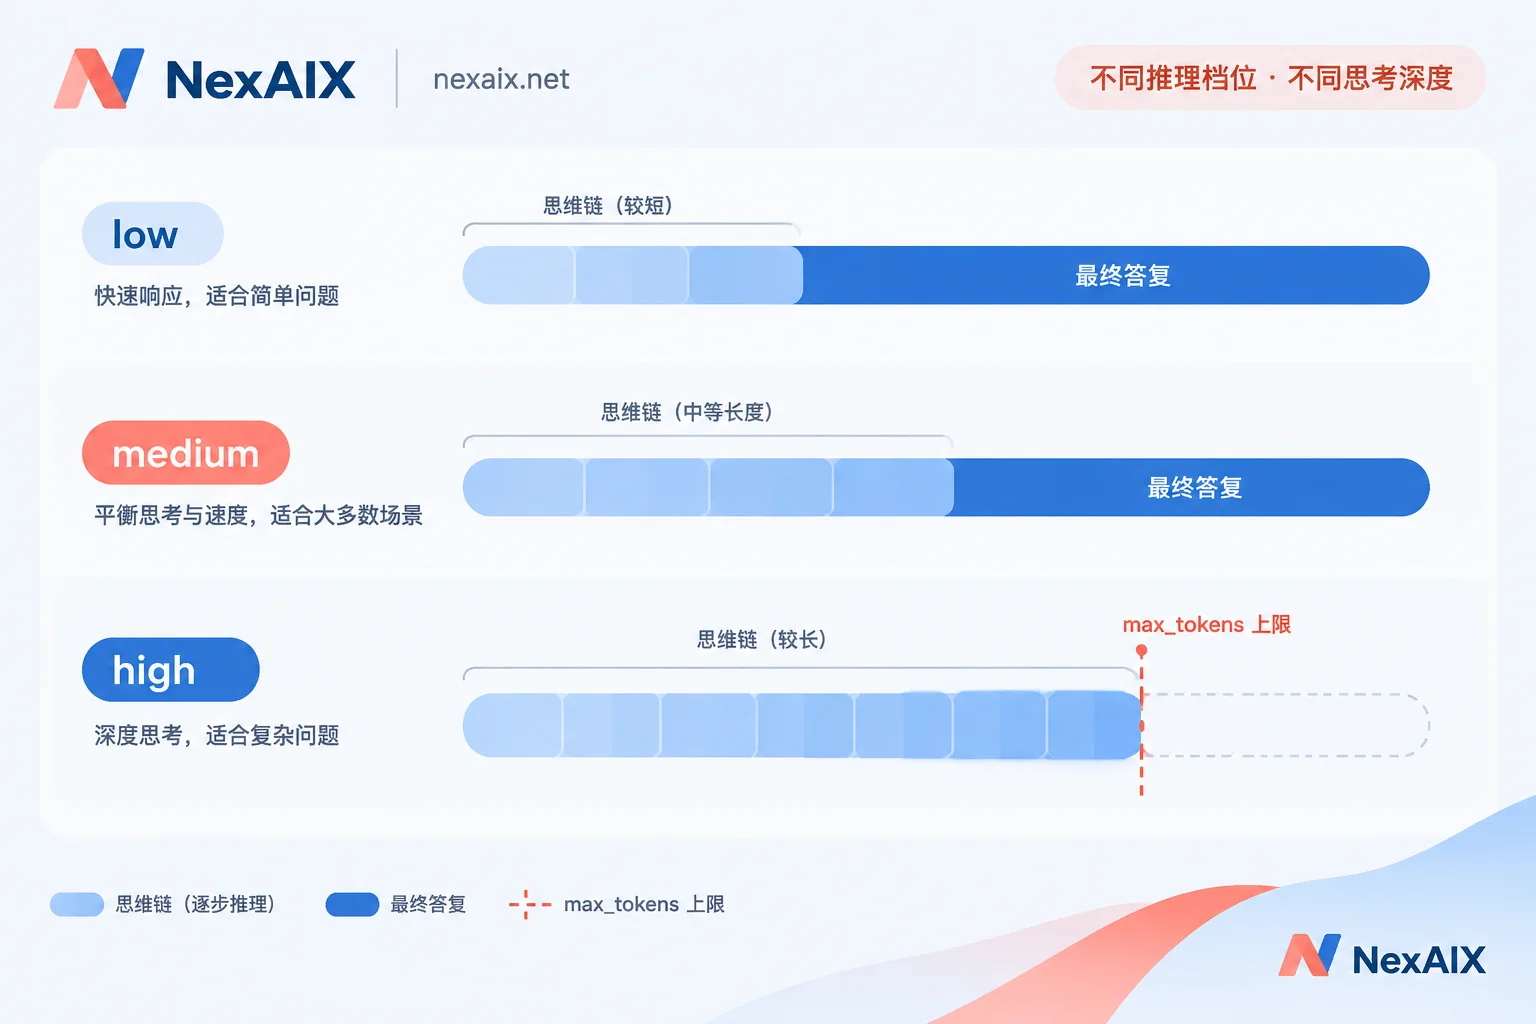
这个模型带 reasoning_effort 参数,一般支持 low / medium / high,默认 medium。它控制的是隐式推理预算,也就是模型在给出答案前愿意花多少 token 想。
实际怎么选:
- low:分类、抽取、格式转换、规则明确的判断。首字延迟和 completion tokens 都会明显下降,是交互式场景的默认选择。
- medium:多数业务逻辑、常规代码任务、Agent 的单步决策。
- high:数学推导、复杂算法、长链条规划、需要自我检查的场景。代价是响应时间和 token 消耗都会涨一大截。
建议不要在系统里写死一个档位。把它做成按任务类型或输入复杂度切换的参数,收益比调提示词大。如果你已经在别的推理模型上做过类似分档(比如Kimi K3 的 reasoning_effort 档位),那套路由逻辑基本可以直接复用。
最常见的故障:设了 max_tokens 却拿到空回复
这是接入推理模型时最容易被误判成「服务挂了」的问题。
模型会先生成思维链,再生成最终答复,两段都算 completion tokens。如果 max_tokens 设得太紧,比如按老习惯填了 512,模型可能思维链还没走完就被截断,返回的内容是空的或者半截推理,finish_reason 显示 length。这时候排查方向不是网络、不是鉴权,而是预算。
处理办法:
- 给足预算。高档位任务的
max_tokens留到几千甚至上万,具体看任务;宁可留宽,反正没用到的部分不计费。 - 先看 finish_reason。返回不正常时第一个检查这个字段,
length就是被截断,stop才是正常收尾。 - 流式下统计 usage。开
stream=True时把 usage 统计打进日志,观察一段时间真实的 completion tokens 分布,再反推合理的上限值。流式解析本身的坑(SSE 分片、代理缓冲导致的卡顿)可以参考流式输出接入的排查思路。 - 降档位也能救。如果预算实在不能放宽,把
reasoning_effort调低比硬砍max_tokens更安全。
上下文窗口方面,gpt-oss-120b 标准支持 131,072 tokens(128k)。但服务方开放多少是另一回事——单请求可用的上下文上限、以及 RPM/TPM 限速,去具体模型页看当前数值,别按模型卡的理论值去做容量规划。触发 429 之后的退避与隔离策略,可以照限流处理的通用做法来设计。
开源权重模型特有的降配风险,怎么验
闭源模型走官方渠道,权重不在服务方手上;开源权重模型不一样——谁都能拿到权重自己部署,也就谁都能动手脚。gpt-oss-120b 上常见的三种缩水方式:
一是激进量化。 模型原生按 MXFP4 设计,但服务方还可以往更低 bit 压。压完吞吐上去了、显存省了,代价是长链推理和代码生成的准确率下滑。验证办法是准备一组有确定答案的高难度题目——多步数学推导、需要精确边界条件的算法题、你自己业务里出过错的真实 case——固定 seed 和参数,跨时间、跨服务方跑同一批,对比准确率曲线。单次对话主观感觉不出来,批量对比才看得见。
二是路由到小模型。 同系列还有 gpt-oss-20b,参数量差一个数量级。真被换掉的话,复杂推理题的通过率会掉得很明显,响应速度反而变快。除了上面那组题,也可以留意返回里的 system_fingerprint 是否在你没改配置时发生变化。
三是悄悄截上下文。 宣称 128k,实际在服务端把超出部分裁掉。用大海捞针式测试验:在 60k、100k、120k 位置各埋一句只有你知道的事实,然后提问。取不出来就是被截了,不是模型记性差。这类验证在别的长上下文模型上也适用,做法可以参考中转服务的三类工程风险排查。
这三项测试值得固化成脚本,定期跑一次,把结果存档。换服务方、涨价、换套餐之后各跑一遍,比看任何宣传页都实在。
NexAIX 把不换小模型、不降精度、不砍上下文写进承诺,也把配额与限速公开出来,验证方法在这一页有说明——但承诺归承诺,上面那套脚本你自己也该有一份。
上线前的收尾清单
- 模型标识从模型页复制,不靠记忆;
reasoning_effort按任务分档,别全局写死high;max_tokens留足思维链空间,日志里记finish_reason和 usage;- 上下文和限速数值以模型页当前标注为准;
- 降配验证脚本写好,接入当天跑一次基线存档。
真要动手,最快的路径是拿测试额度先把上面五条跑一遍:确认模型标识、试三个推理档位的延迟差、埋一次针、记一组基线分数。跑完这四步,再决定要不要把生产流量切过去。



评论(0)