 NexAIX-官方博客
如果你手上已经有一套跑在 OpenAI SDK 上的代码,接 Qwen3.6 需要改的只有三处:base_url、api_key、model。真正需要想清楚的是前面两件事——这个任务该用哪一档 Qwen3.6,以及思考模式要不要开。下面按这个顺序说。
三个型号对应三类任务
Qwen3.6 是通义千问在 2026 年 4 月推出的一代模型,这一代的重点是智能体编程、工具调用、前端生成和多轮推理链的保留,不是通用聊天体验的小幅提升。系列内部分成两条线:
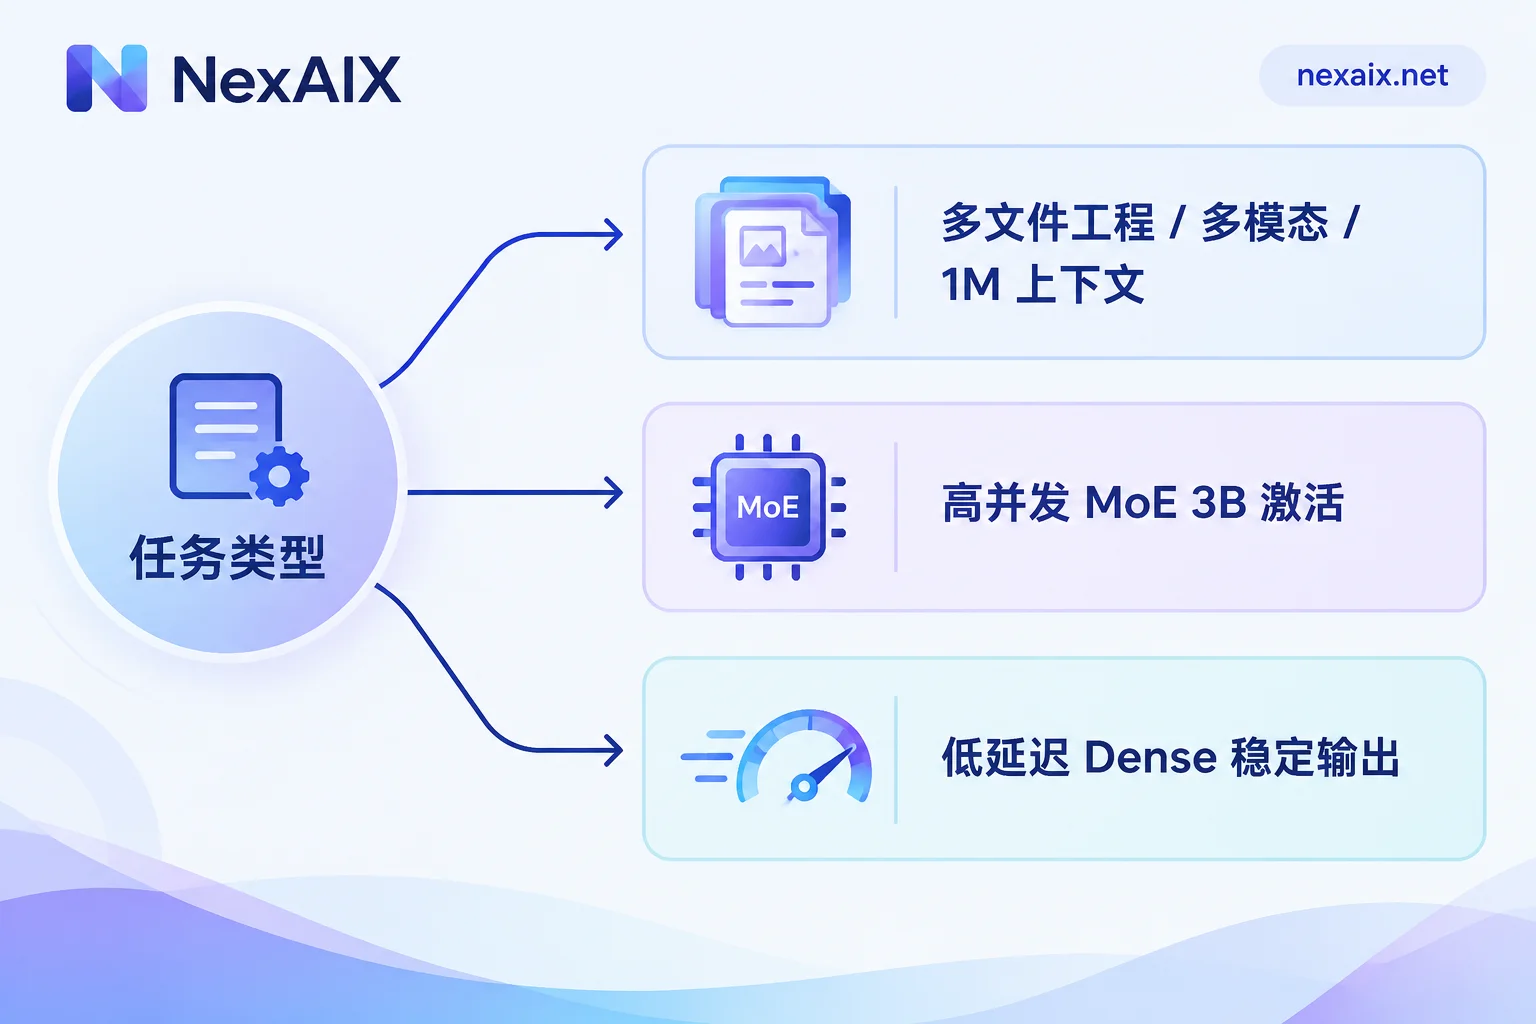
Qwen3.6-Plus:官方托管的闭源旗舰,默认 1M tokens 上下文。它的升级方向很明确——端到端自主修 bug、跨多文件理解一个工程、终端自动化操作,SWE-bench Verified 报到 78.8,另外还带图像和视频理解。如果你要做的是「把仓库丢给它,让它自己定位问题、改代码、跑验证」这类任务,或者在 Claude Code、OpenClaw 这种智能体壳子里当主力模型,用 Plus。多模态输入也只有这一档有。
Qwen3.6-35B-A3B:MoE 架构,总参数 35B,每个 token 只激活 3B。这是吞吐和质量的平衡点——高并发的线上问答、批量文本处理、中等复杂度的 Agent 子任务,用它比用 Plus 划算得多,延迟也更可控。
Qwen3.6-27B:Dense 架构。输出稳定性要求高、单请求延迟敏感的场景更适合它,比如结构化抽取、固定格式的内容生成。
两个开源版都基于 Gated DeltaNet 混合骨干,Apache 2.0 协议,原生支持 262,144(256K)tokens 上下文,可扩展到 1M。也就是说,除非你真的要一次塞进接近百万 token 的材料或者需要多模态,256K 在绝大多数长文档任务里够用,没必要默认往 Plus 上靠。
供给方式这一层值得顺手看一眼:开源权重模型和闭源旗舰的来路本来就不同,Plus 只能走厂商官方授权渠道,35B-A3B 和 27B 这类开放权重则可以由服务方自己部署在算力集群上。在 NexAIX,每个模型页会标明它属于哪一种,具体上线的模型 ID 和限速数字也在那里,接之前先去 模型清单 确认一下当前可用的名字,别照着博客里的字符串硬写。
接入:只改 base_url
Qwen3.6 全系走 OpenAI 兼容的 /v1/chat/completions,所以现有的 openai-python、Vercel AI SDK、LangChain、LlamaIndex 都不用换客户端。
from openai import OpenAI

client = OpenAI(
    api_key="你的 Key",
    base_url="https://api.nexaix.net/v1",
)

resp = client.chat.completions.create(
    model="以模型页标注的 ID 为准",
    messages=[{"role": "user", "content": "分析这段日志的异常原因"}],
    stream=True,
)
从其他服务迁过来时,最容易踩的不是端点,而是把旧模型名直接留在配置文件或环境变量里没改,结果报 model not found,却去排查网络。迁移时把模型名收成一个常量,别散落在各处。
思考模式:默认开着,你多半要手动关
Qwen3.6 默认启用思考模式。这意味着同一个 prompt,首 token 延迟和总 token 消耗都会比你迁移前的预期高一截,做实时对话、意图分类、短文案这类任务时,感受会很明显。
关掉有两种写法,取决于服务端支持哪一种:
# 写法一:模板参数
resp = client.chat.completions.create(
    model="...",
    messages=messages,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}},
)

# 写法二:推理力度档位
resp = client.chat.completions.create(
    model="...",
    messages=messages,
    extra_body={"reasoning_effort": "none"},
)
先用写法二试,不生效再用写法一,两者不要同时传。判断是否真的关掉了,不看耗时,看响应里还有没有 reasoning_content 字段,以及 usage 里的输出 token 是否回落到正常水平。
什么时候该保留思考模式:多步推理、代码调试、需要模型自己规划工具调用顺序的 Agent 任务。什么时候该关:分类打标、格式转换、检索结果的摘要重写、任何用户在等着看第一个字的交互。
reasoning_content 怎么解析
开启思考模式时,流式响应会把推理过程和最终回答分开:推理走 delta.reasoning_content,回答走 delta.content。
for chunk in resp:
    d = chunk.choices[0].delta
    rc = getattr(d, "reasoning_content", None)
    if rc:
        pass  # 折叠区展示,或直接丢弃
    if d.content:
        print(d.content, end="")
两个常见问题。一是老的流式解析代码只取 delta.content,思考阶段那几秒什么都收不到,前端看起来像卡死了——要么在收到 reasoning_content 时先打一个「思考中」的状态,要么直接关思考模式。二是把 reasoning_content 拼进下一轮的 messages 里当普通内容回传,上下文很快就撑爆了,质量也会飘。
关于流式链路本身的断流和代理缓冲问题,可以参考流式输出 API 怎么接里的排查顺序。
思考留存与工具调用
Qwen3.6 这一代引入了思考留存(Thinking Preservation):在多轮对话和自主代理的长管道里保留此前的推理链上下文,避免每一轮都从零重新推一遍,复杂任务和工具调用的执行稳定性因此更好。
落到代码上,关键是别在拼历史时把模型上一轮的推理痕迹随手抹掉或随手全塞回去,而是按服务端文档规定的字段结构原样回传该回传的部分。如果你自己写了一层 message 归一化逻辑(很多从别家迁过来的项目都有),检查它会不会把非标准字段直接丢弃。
工具调用走标准的 tools + JSON Schema,tool_choice 语义和 OpenAI 一致,流式下 tool_calls 的参数是分片到达的,要按 index 累加拼接后再解析 JSON。Agent 场景更完整的验证清单可以看 Agent API 怎么接。
长上下文和降配,怎么自己测
上下文数字写在文档上是一回事,实际能不能用是另一回事。上线前跑三个检查:
一、有效上下文实测。 构造一份接近你实际用量的长文档(比如 200K tokens),在开头、中段、末尾各埋一句可验证的事实,然后分别提问。如果中段问题答不出来而首尾能答,说明有效窗口比标称小,或者中间被截了。
二、看 usage 和返回的 model 字段。 每次请求都记录 usage.prompt_tokens、completion_tokens 和响应里的 model。输入 token 数明显小于你发出去的量,就是被截断了;model 字段和你请求的不一致,说明发生了替换。
三、固定回归集。 挑 20 到 30 条有标准答案的任务,temperature 设 0,定期跑一遍比对。通过率突然下滑时,先排查自己这边有没有改 prompt 或参数,再怀疑上游。
这三件事之所以要自己做,是因为「换成小模型」「降低精度」「砍短上下文」这类操作在 API 层面通常是静默的,只有行为能暴露。NexAIX 把不降配和配额限速公开写成了承诺,验证方法 也一并列在那一页,你可以照着跑一遍再决定要不要把生产流量切过去。
上线前还要处理的两件事
限速。 开源版和闭源旗舰的速率上限通常不在一个量级,Agent 任务一旦并行展开,触发 429 的概率比普通对话高得多。退避策略和哪些错误该重试,AI API 限流怎么处理里有可以直接抄的实现。
Key 隔离。 开发调试、线上服务、批处理任务用不同的 Key,配额和用量分开记。出问题时能一眼看出是哪条链路把额度吃光的,比事后翻日志快。
先拿测试额度把上面三个检查跑一遍,再决定用哪一档——比对着参数表猜靠谱。



评论(0)