 NexAIX-官方博客
在当前的 AI 应用与 Agent 工程实践中,单一模型包打天下的阶段已经过去。一个成熟的生产链路往往需要同时调度多个模型家族:用高推理能力的闭源模型处理复杂规划与核心代码生成,用高吞吐的开源权重模型承接长文档摘要、结构化信息抽取或高频工具调用,再配合多模态模型处理图文与视频帧解析。
为了降低多厂商接入的维护成本,OpenAI兼容API(以 OpenAI Chat Completions 规范为基准的接口形式)已经成为行业事实上的标准协议。然而,许多开发团队在把应用从 Demo 推向生产环境时都会发现:“宣称兼容 OpenAI”和“能在生产环境稳定混用”,中间隔着巨大的工程鸿沟。
之前我们已经探讨过改一行 base_url 把现有应用接到新端点的基础操作,也拆解过换大模型 API 时的三处必改配置与参数检查。本文将跳过基础语法,从架构负责人与 Agent 开发者的视角出发,聊聊在多模型混用时代,如何围绕“协议还原度、底层供给确定性、主动容灾与账单治理”来选型和架构你的 OpenAI 兼容 API 接入层。
一、为什么“名义兼容”会在生产环境频频翻车?
“OpenAI 兼容”并非一份带有强制合规测试的 RFC 标准,而是社区围绕 /v1/chat/completions 形成的一套约定。在简单的单轮文本对话中,几乎所有兼容端点都能跑通;但一旦进入多步 Agent 编排或高并发生产环境,协议边界的模糊性就会集中爆发:
- 工具调用(Function / Tool Calling)结构失真:Agent 依赖严格的 JSON Schema 描述工具并解析模型返回的调用指令。部分非标准中转层在做协议映射时,会丢失嵌套参数或改写
tool_calls数组结构,导致下游解析器直接抛出异常。 - 流式输出(Streaming)与多模态格式割裂:不同厂商原生接口的 SSE(Server-Sent Events)分片节奏与
finish_reason触发时机存在差异。如果兼容层没有按标准 Chat Completions 规范对齐,前端流式渲染就会出现卡顿或截断;同理,多模态输入若未统一遵循标准的image_url或 base64 结构,每换一个模型就要重写一套预处理逻辑。 - 隐式篡改与参数吞没:为了节省成本或掩盖上游报错,一些劣质聚合渠道会在后台静默截断超长上下文、吞掉
temperature与max_tokens参数,甚至注入隐藏的系统提示词,导致 Agent 行为在生产环境中不可预测。
要让“一套代码调遍多模型”真正落地,接入层必须在协议还原度与参数透传上做到严格对齐。
二、一套代码混用开源与闭源:真正的 Drop-in 架构
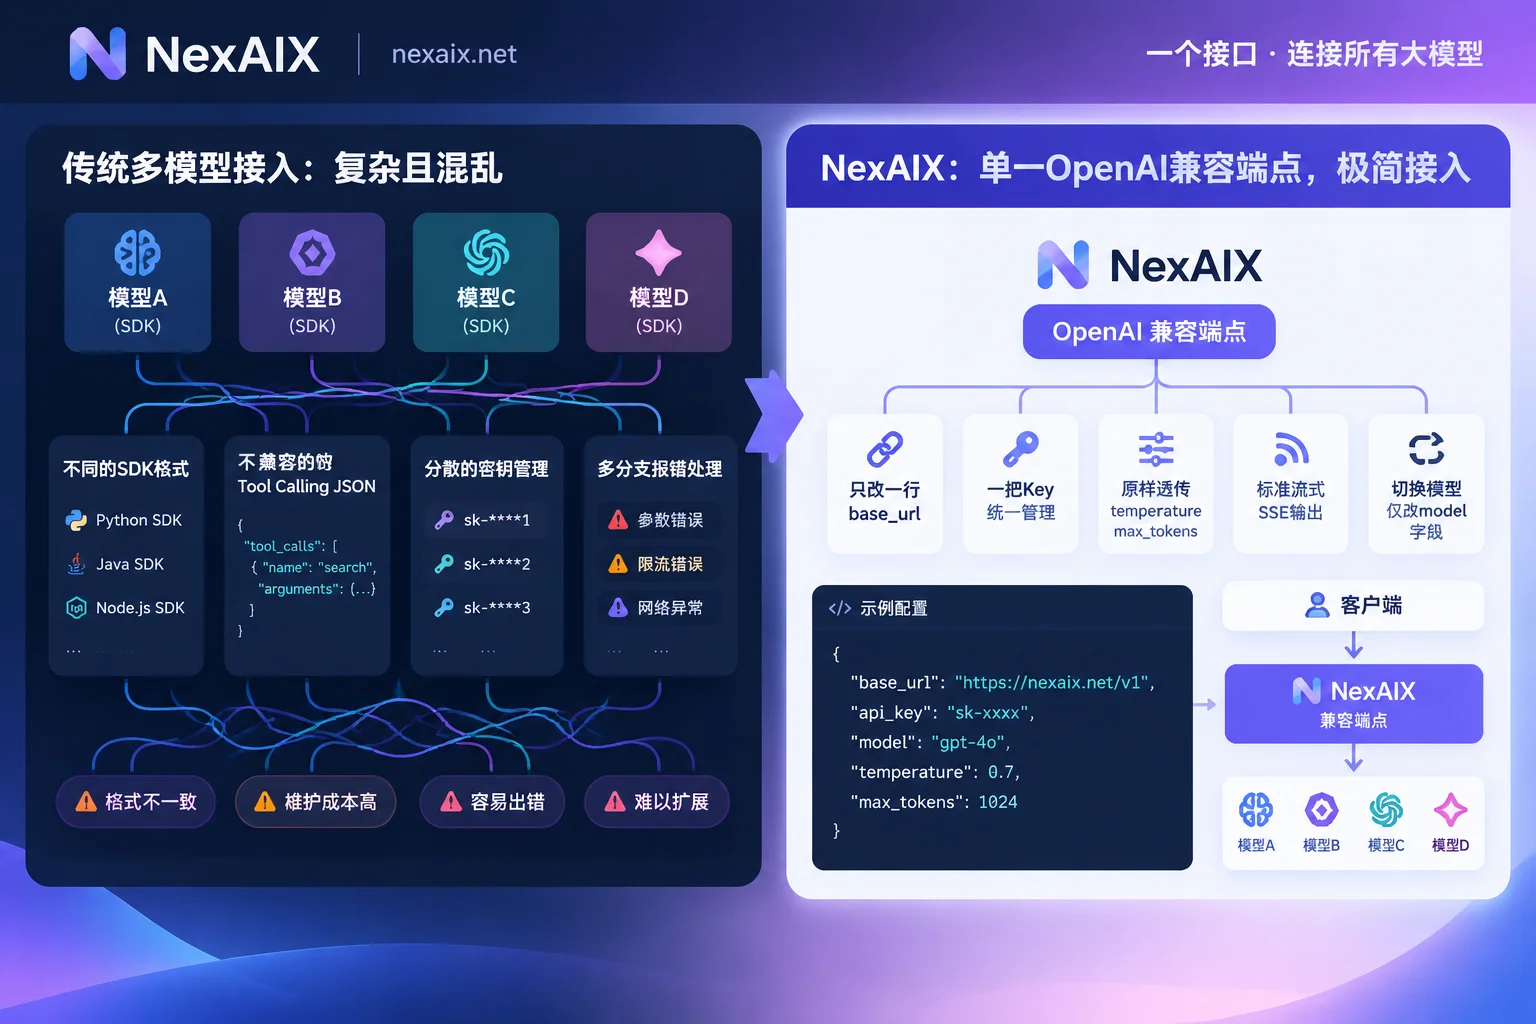
在 NexAIX 的设计中,OpenAI 兼容接入的核心目标是消除应用层的 if provider == xxx 分支判断。无论是调用开源权重模型还是闭源商业模型,接口行为保持高度一致:
- 核心能力全覆盖:严格按 OpenAI Chat Completions 规范实现,完整支持多轮对话、流式输出(Streaming)以及 Agent 核心依赖的函数/工具调用(Function/Tool Calling)。
- 多模态标准传参:针对支持多模态的模型(具体可在各模型页查看标注的输入模态),图像直接按 OpenAI 多模态格式传入
image_url或 base64 编码;视频输入则按抽帧后的图像序列传入,无需引入私有 SDK。 - 一行配置切换全局生态:已在用 OpenAI SDK 的项目,绝大多数只需将
base_url改为https://api.nexaix.net/v1并换上 NexAIX 的 API Key 即可运行。同时,所有支持自定义 OpenAIbase_url的开发框架与客户端——包括 LangChain、LlamaIndex、Vercel AI SDK、Dify、Cherry Studio、NextChat、Cline、OneAPI 等——均可直接无缝接入(如果你正在使用这些工具,可以参考我们整理的 LangChain、Dify 与 Cline 配置指南)。
多模型 Agent 角色分配代码示例
通过一把 Key 访问全部已开通模型,开源与闭源模型的切换仅需改动请求体中的 model 字段。在构建多步 Agent 时,你可以用同一个客户端实例完成不同角色的调度:
from openai import OpenAI

# 统一初始化:一个端点、一把 Key
client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key="YOUR_NEXAIX_API_KEY"
)

def run_agent_step(role: str, messages: list, tools: list = None):
    # 按任务角色动态指定 model 字段,无需更换 SDK 或重写请求结构
    model_map = {
        "planner": "gpt-5.6",          # 复杂规划与多模态理解:走官方授权闭源模型
        "coder": "glm-5.2",            # 代码生成与长上下文工具调用:走自有算力开源权重
        "extractor": "deepseek-v3"     # 高频结构化提取:走自有算力开源权重(具体型号以官网模型页为准)
    }

    target_model = model_map.get(role, "glm-5.2")

    kwargs = {
        "model": target_model,
        "messages": messages,
        "temperature": 0.2,
        "stream": False
    }
    if tools:
        kwargs["tools"] = tools

    response = client.chat.completions.create(**kwargs)
return response.choices[0].message选型与接入提示:在查阅 NexAIX 模型广场 时,单个模型详情页的 URL slug 会把模型 ID 里的点(.)换成横线(-)。例如查看glm-5.2的规格与三步接入代码时,页面地址为https://nexaix.net/models/glm-5-2/(直接用模型 ID 拼写/models/glm-5.2/会返回 404),而在 API 请求体里的model字段仍填写glm-5.2。如果清单以外有特定的开源权重模型需求,也可以将型号和预计用量发送至 [email protected],我们会在评估算力后回复排期。
三、穿透协议表象:看清底层的算力供给与参数透明
接口格式统一之后,决定生产环境稳定性的核心就落到了底层供给方式上。市面上的 OpenAI 兼容渠道鱼龙混杂,许多低价聚合站背后依赖的是个人账号拼凑的“号池”或逆向网页客户端协议,不仅随时面临封号断流,还会出现严重的降智与截断。
关于开源权重模型 API 和官方授权渠道的具体差异,我们在之前的文章中有过详细对比。NexAIX 在供给侧坚持只做两种透明模式,所有单个模型页均必填标注「自有算力部署」或「官方授权渠道」标签:
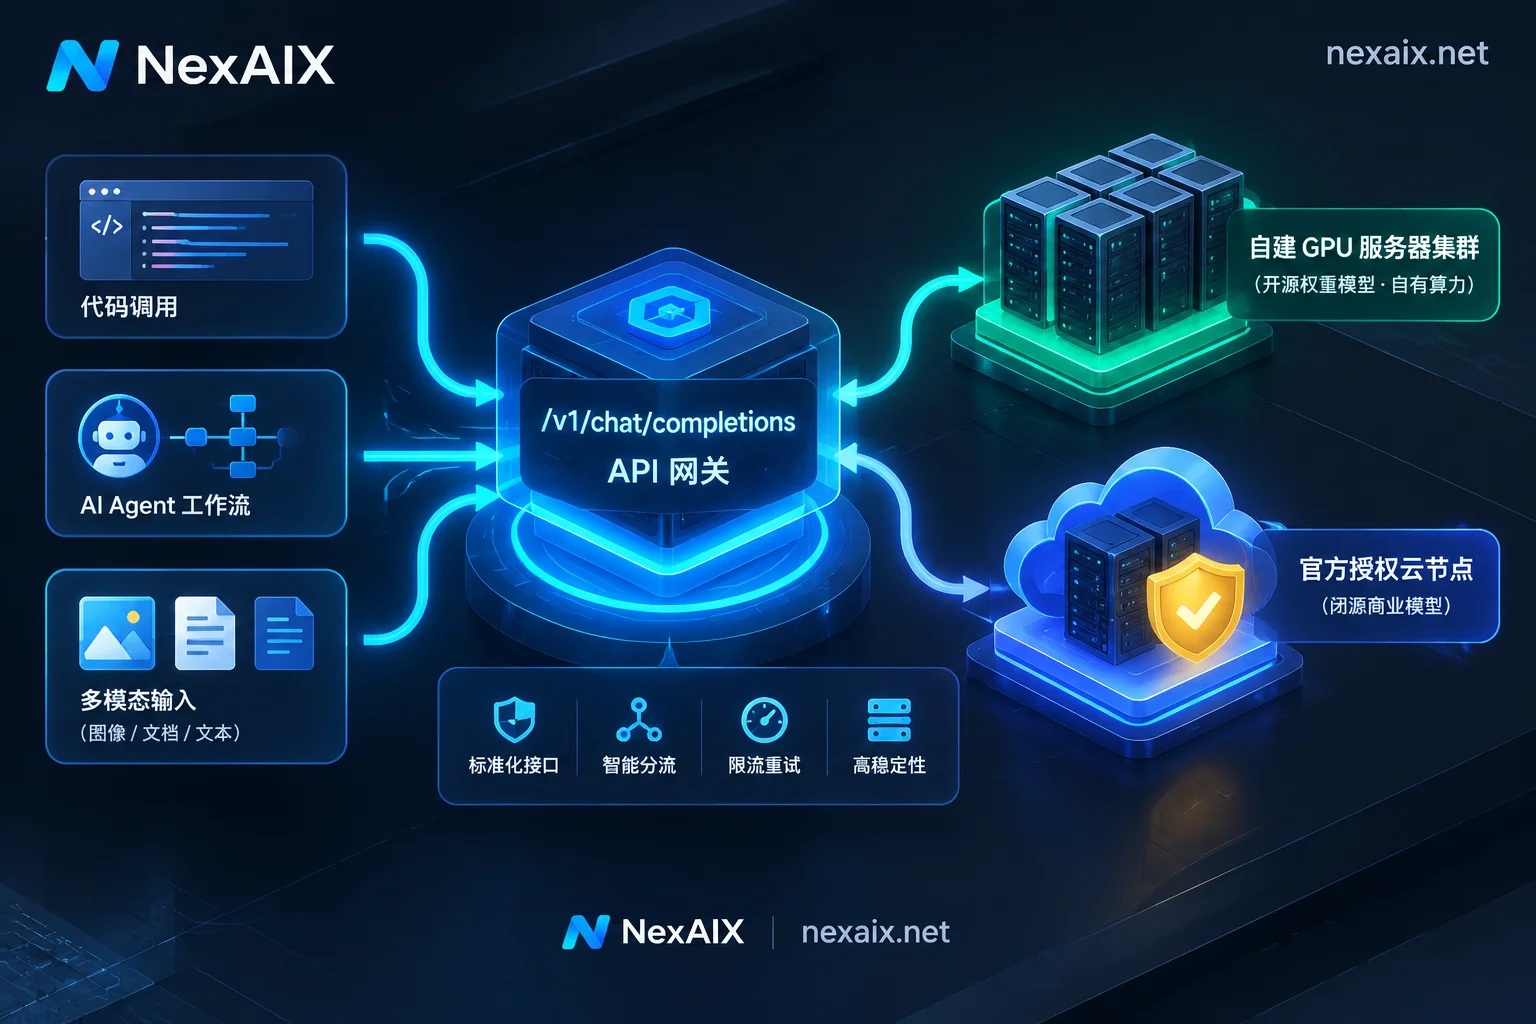
- 自有算力部署(开源权重模型):官方发布的开源权重(当前官网列有 Kimi、GLM、DeepSeek、MiniMax、Qwen、gpt-oss 系列)直接部署在自建与自租机房的自有 GPU 集群上,由团队自己运维,绝不转售第三方额度。每个模型页均明确标注上下文窗口、最大输出、推理精度(如 BF16、FP8、MXFP4 等,按模型实际标注)和开源许可。
- 官方授权渠道(闭源商业模型):当前官网列有的 Claude、GPT-5.6、Grok、Gemini 系列闭源模型,全部走厂商官方商用授权,有合同、有发票、可审计,不用号池、不逆向客户端协议(想了解这两种供给与号池、逆向中转的本质区别及自查方法,请参阅渠道透明度说明)。
坚持“四不降配”与可验证承诺
在协议转发层,NexAIX 严格执行不降配承诺:返回体里的 model 字段就是实际执行的模型;不换小模型、不降精度、不截断上下文和最大输出、不注入隐藏系统提示词,且请求中的 temperature、top_p、max_tokens 原样透传。
工程团队完全不需要仅凭口头信任,可以直接在业务代码中用四种方法自查(详见怎么确认 API 返回的是不是原版模型):
- 固定 prompt 和随机种子复测输出一致性;
- 核对响应体中的
model字段; - 用接近模型上限的长度进行上下文与最大输出压测;
- 让模型复述收到的全部消息,检验是否存在隐藏注入。
四、生产环境治理:显式 429 容灾、按 Key 隔离与零日志边界
当多模型调用进入高频生产阶段,技术负责人最关心的往往是三个治理问题:突发满载时怎么表现?多个 Agent 或业务线怎么分账与控权?核心业务数据会不会泄露?
1. 拒绝“暗箱换模”,用标准 429 支撑应用层主动容灾
很多聚合网关会宣传所谓的“智能路由与自动故障转移”,但这在严谨的 Agent 生产环境中往往是把双刃剑:当主力模型限流时,网关若在后台静默把请求切给另一个能力或推理精度不同的模型,极易导致结构化输出失败或业务逻辑错乱。
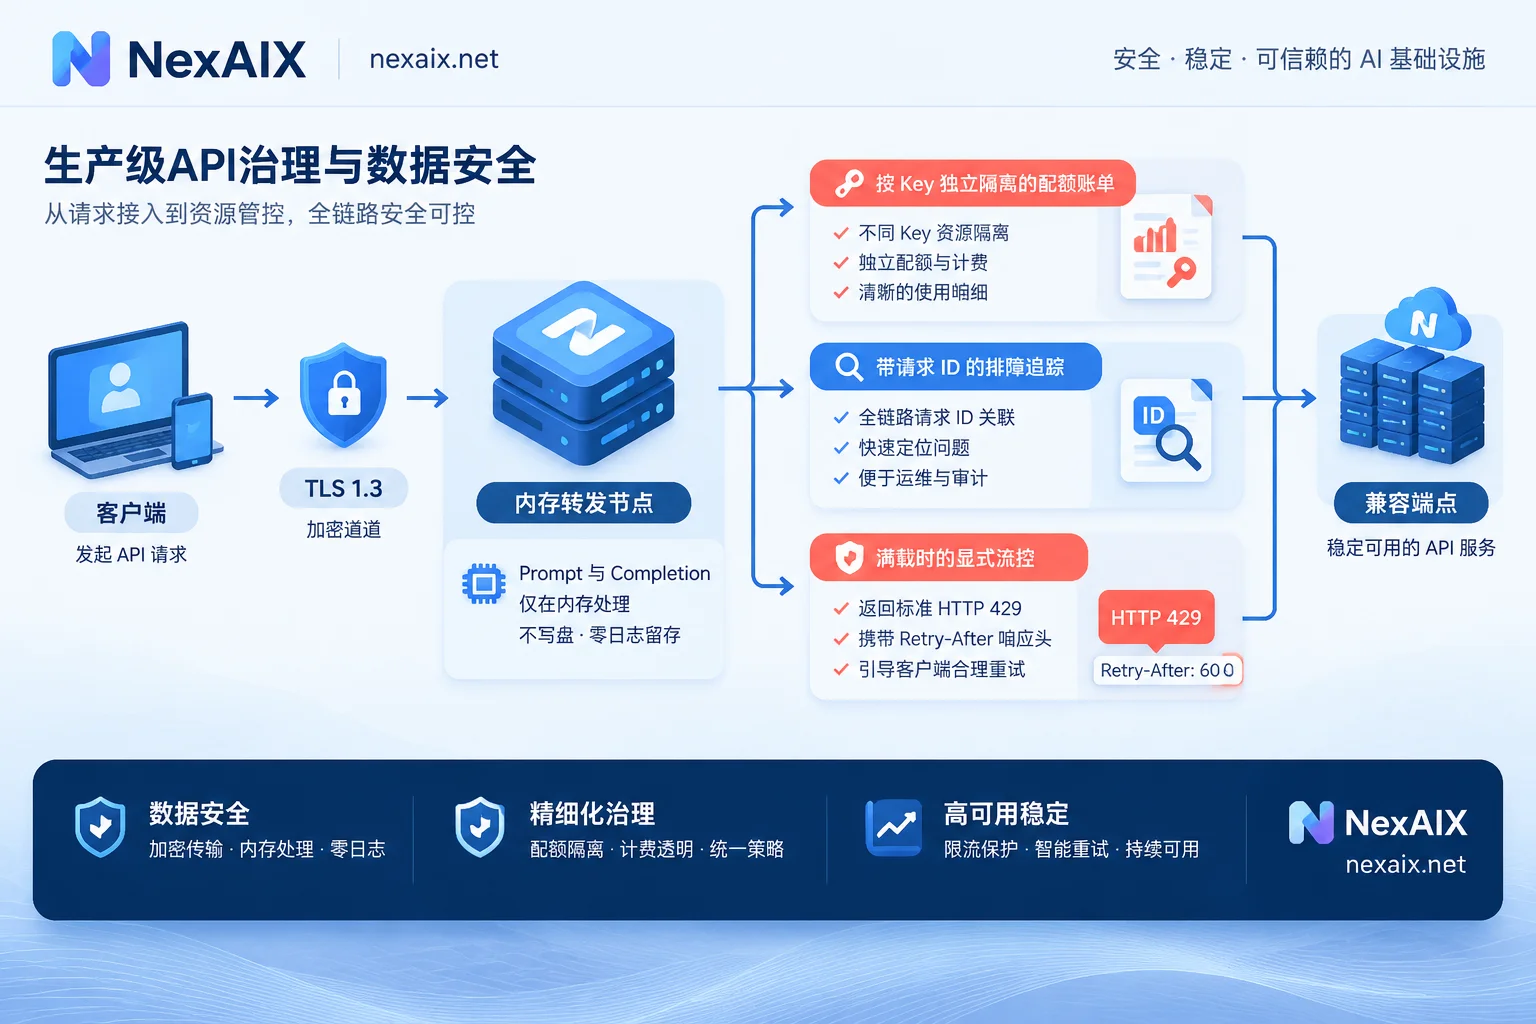
NexAIX 采用单一供应方、单一端点的确定性策略,不做自动路由与故障转移:
- 开源模型的容量来自自有 GPU 集群,闭源模型受上游配额约束。
- 每把 Key 设有独立的 RPM、TPM 和并发上限(需要更高配额可随时申请,我们会按实际容量答复)。
- 当遇到突发流量满载时,系统会立即返回标准
429状态码并附带Retry-After响应头,绝不无限期挂起连接,也绝不会私自改用更便宜的模型顶替(同时提醒:处理百万级等超长上下文时,首 token 延迟和费用会随输入长度自然上升,架构设计时需做好流式读取与超时预留,详见高吞吐与限速机制以及429 等错误码重试指南)。
拿到明确的 429 和 Retry-After 后,控制权完全交还给你的工程代码——你可以清晰地决定是按秒退避重试、进入消息队列排队,还是在应用层显式切换到备选的 model。
2. 按 Key 隔离配额与分项账单
月底打开好几个控制台对账、或者一把主密钥全团队混用导致泄露后不敢吊销,是多模型开发中的常见痛点。在 NexAIX 中:
- 每把 Key 独立隔离:每把 API Key 拥有独立的配额、独立的权限以及独立的用量账单。你可以按项目、环境(开发/测试/生产)或不同的 Agent 分配专属 Key,一旦某把 Key 意外泄露,可以单独吊销而不影响其他业务线(参考 AI API Key 隔离最佳实践)。
- 精细化对账与排障:登录控制台即可导出用量明细,账单按模型清晰分项;同时每次 API 调用均会返回唯一的请求 ID,遇到任何异常排障时,只需带着请求 ID 联系技术支持即可快速定位,无需提供敏感的业务报文。
3. 明确的数据留存与合规边界
在数据安全方面,NexAIX 坚持严格的不记录对话策略:
- 本站侧零落盘:从客户端到推理节点全程采用 TLS 1.3 加密;你的
prompt和completion只在内存中转发,请求结束即释放,不写盘;不用于训练,也不转给做训练的第三方。系统仅保留用于计费与排障的元数据(请求 ID、模型名、token 计数、时间戳、状态码)。 - 客观说明上游边界:以上零日志承诺是 NexAIX 本站这一侧的严格保障。对于闭源模型,请求到达上游厂商后按厂商各自的条款处理,各家不同,本站无法代为承诺(目前官网上只有 Claude 的两个模型页单独标明了上游留存情况:Opus 5 支持零数据保留,Fable 5 目前有 30 天留存;具体政策请以官网各模型页说明为准)。
五、结语:三步开启生产级多模型接入
把多模型调用统一到一套干净、透明、可验证的 OpenAI 兼容 API 上,不仅能把研发团队从繁琐的 SDK 适配与对账中解放出来,更能为 AI 应用的长期演进提供坚实的底座。
如果你正在为新项目选型,或计划将现有的多模型应用迁移到更稳定的生产端点,现在就可以按以下三步快速验证:
- 获取测试额度:访问 NexAIX 控制台 使用邮箱注册,注册即送测试额度,无需提交繁琐的企业资质即可创建你的第一把 API Key。
- 挑选目标模型:前往 模型广场 查看在售的开源权重模型(自有算力部署)与闭源模型(官方授权渠道),核对所需的上下文、推理精度与多模态能力。
- 平滑切换与企业对接:将代码或客户端中的
base_url替换为https://api.nexaix.net/v1即可跑通测试。对于步入规模化生产的团队与企业,NexAIX 拥有正规主体,能签合同、开发票,支持签署服务协议与数据处理协议;若有更高的合规要求,欢迎发邮件至 [email protected] 探讨独立资源池与私有化部署方案。


评论(0)