AI API 错误码怎么看:400、401、404、429、5xx 与 529 的原因、重试与降级

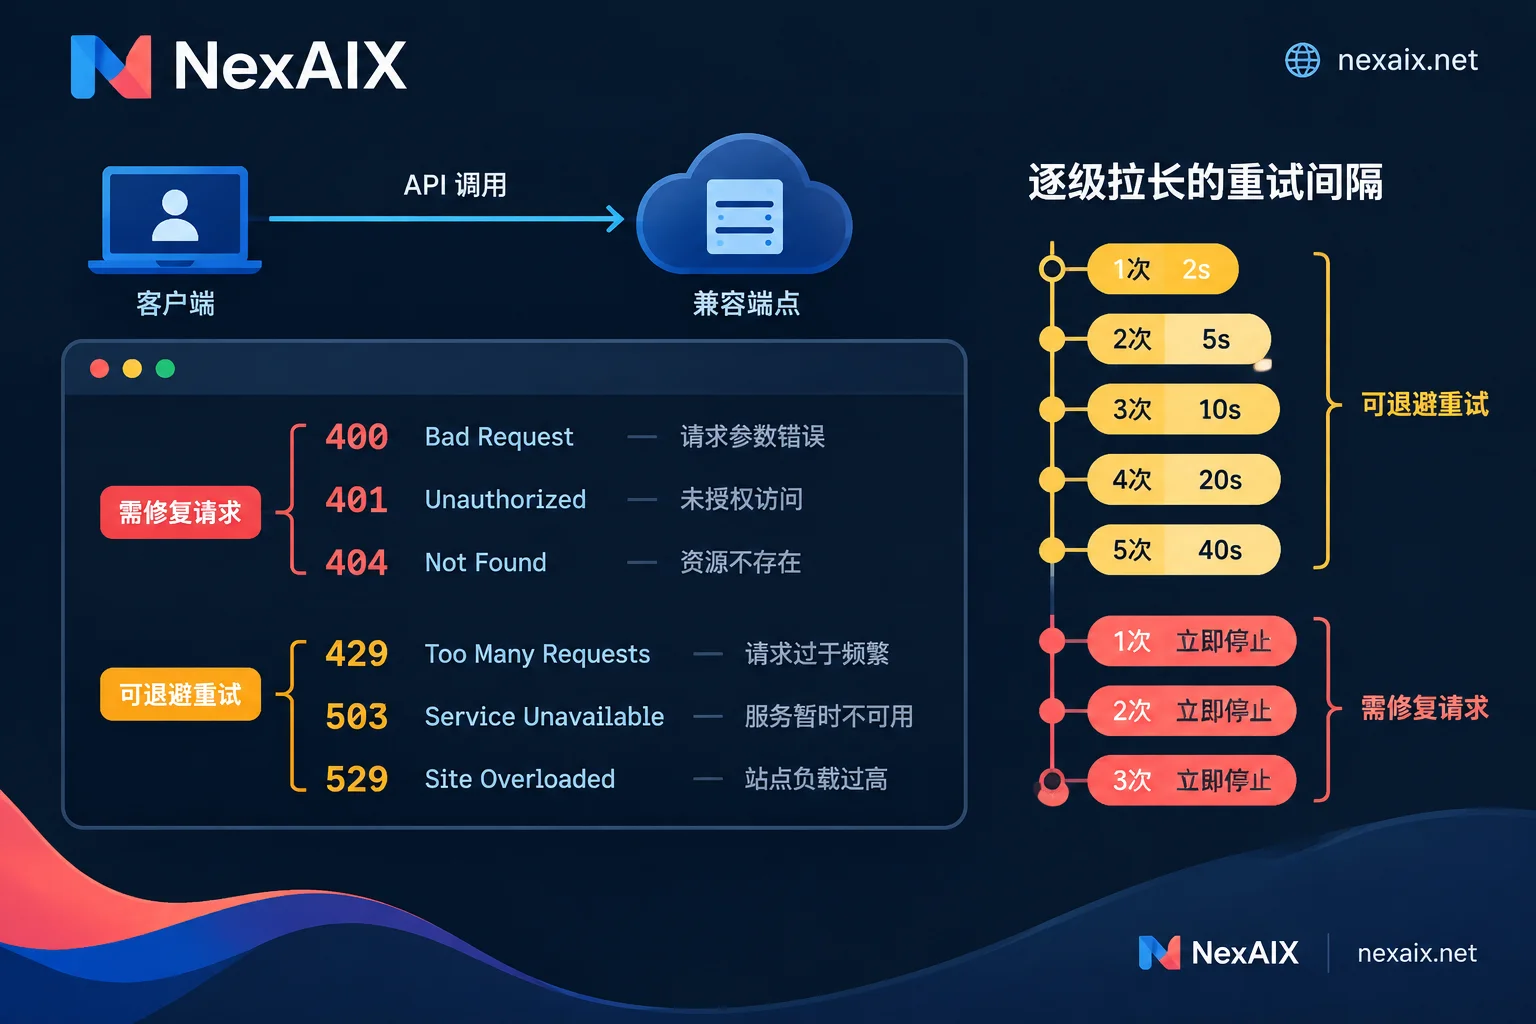
按“改了请求才会好”和“等一会儿可能就好”两类,讲清大模型 API 常见错误码的原因和排查顺序。重点区分 429 的速率限制与额度耗尽,并给出退避重试、断路器和降级的写法,避免空转重试和重试风暴。

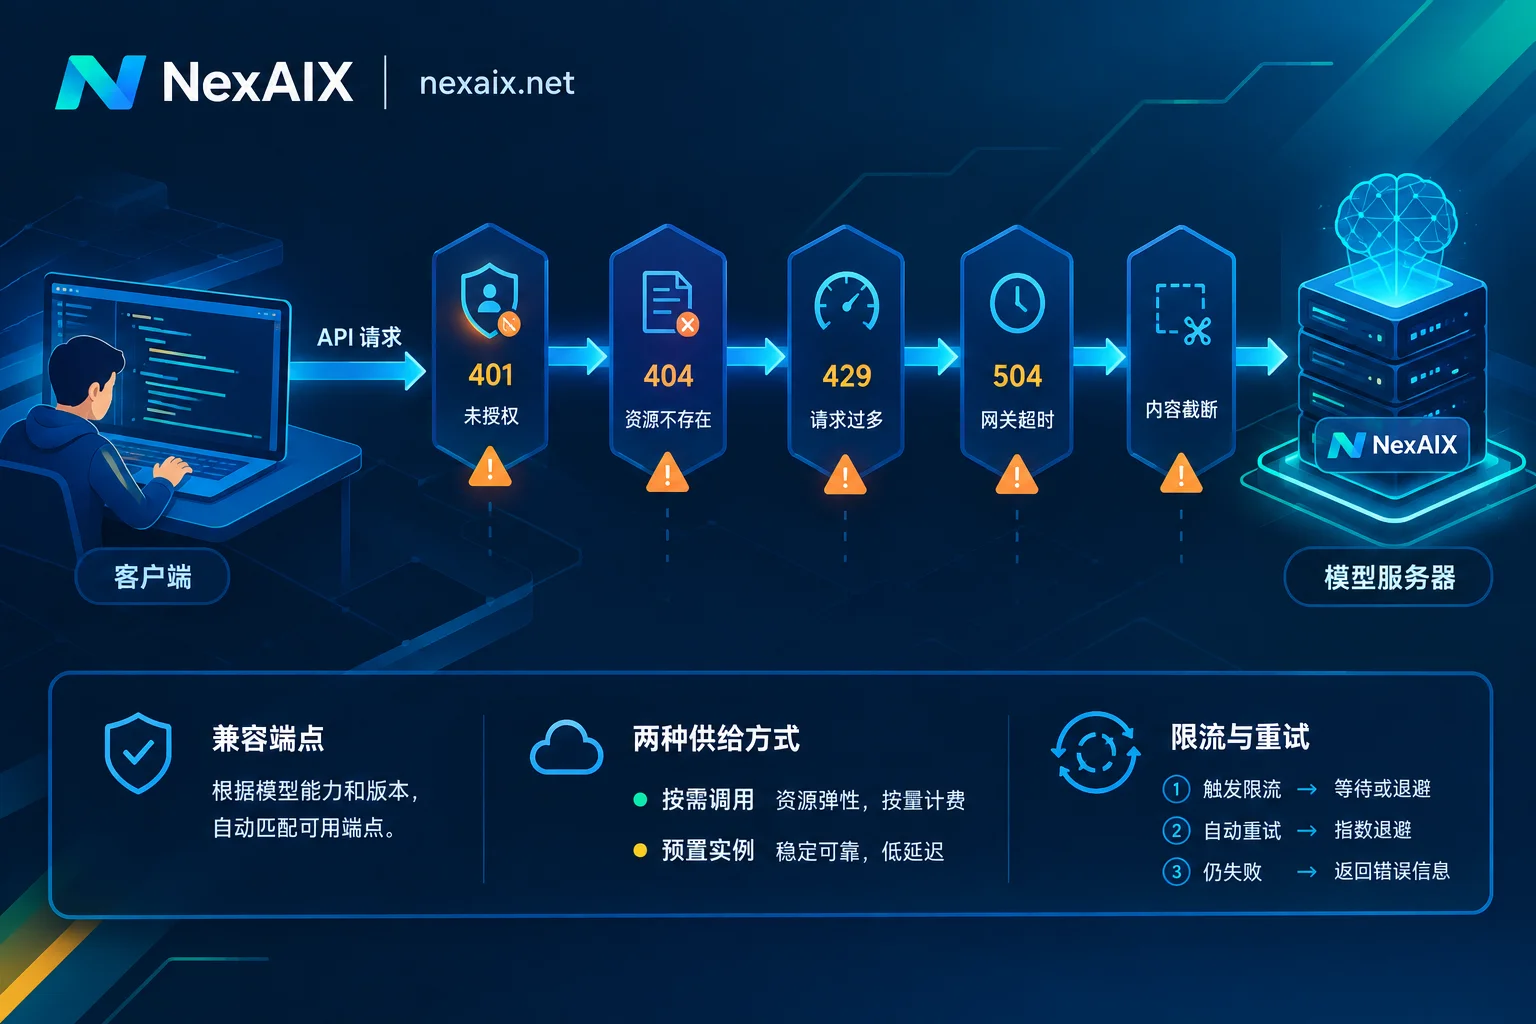
AI API 故障排查:从 401、404、429 到超时、截断和降配怀疑,按顺序定位

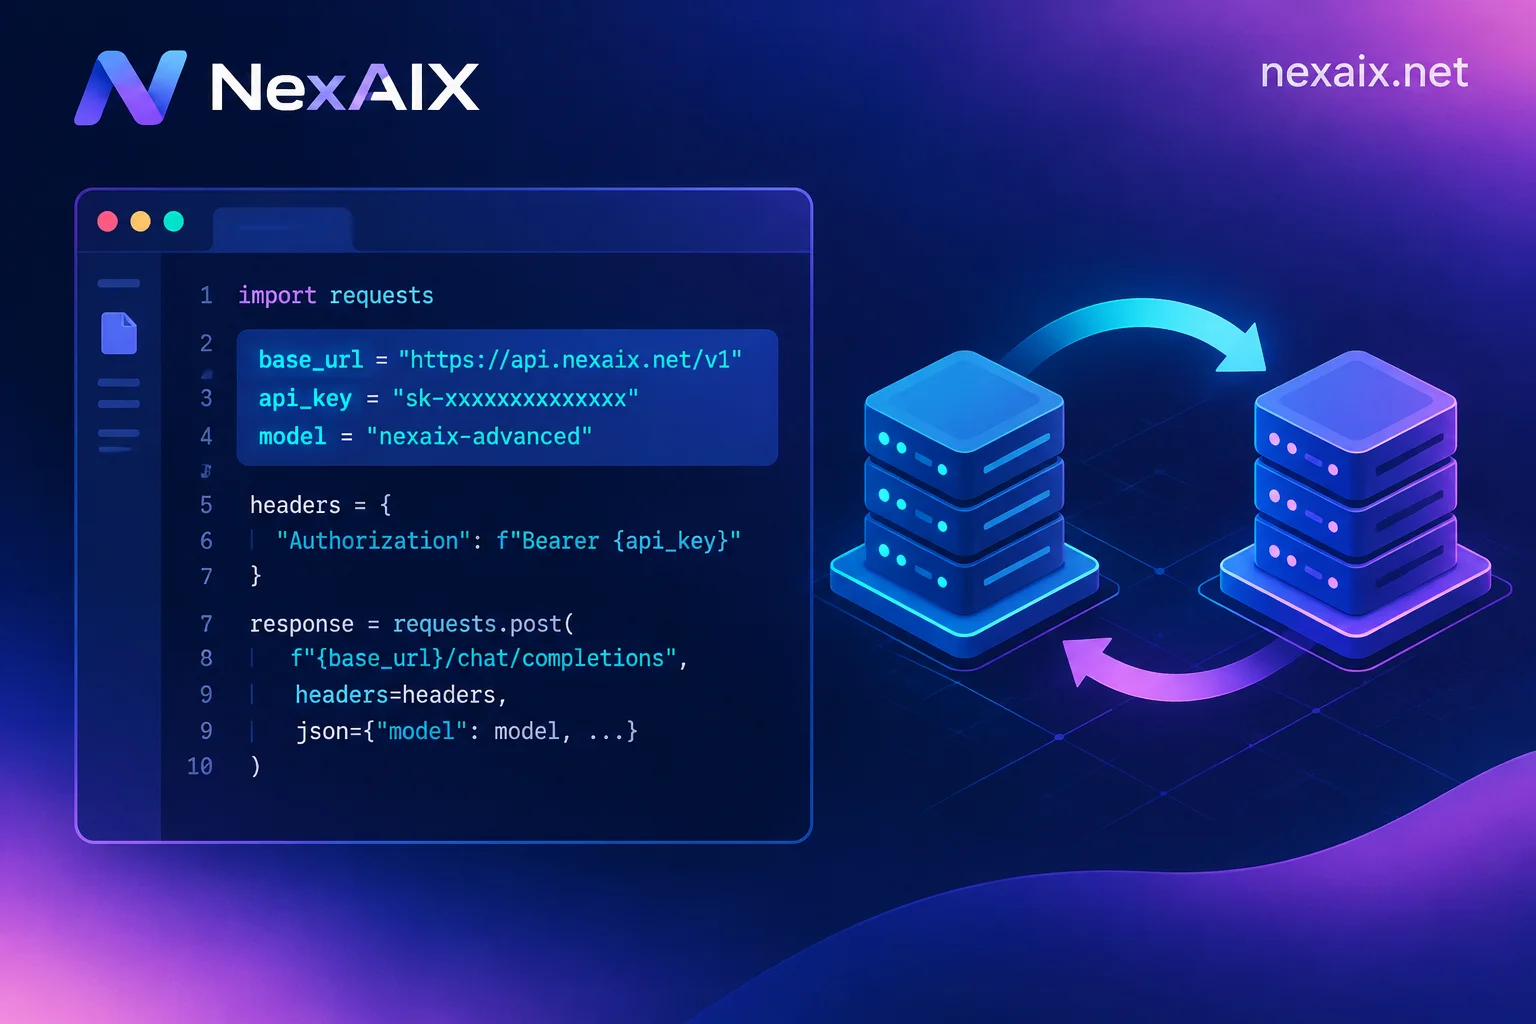
调用大模型 API 出错时,先看状态码和响应体里的错误类型,再用最小请求判断问题在客户端还是服务端。本文按认证、路径与模型 ID、限流与配额、5xx 与超时、上下文截断、降配验证的顺序,说明每类问题的判断方法和对应处理。
AI API吞吐量怎么测、怎么提:并发数、RPM/TPM 限流与延迟的取舍

说明如何用每秒输出词元数和每秒完成请求数衡量 AI API 吞吐量,如何通过阶梯压测找到合适的并发数,并按 RPM、TPM 限额估算容量。文章还给出连接复用、Prompt 缓存、控制词元用量和带抖动的 429 退避代码,帮助在吞吐量和首字延迟之间做取舍。

AI API 重试怎么设计:哪些错该重试、退避等多久、流式中断怎么办

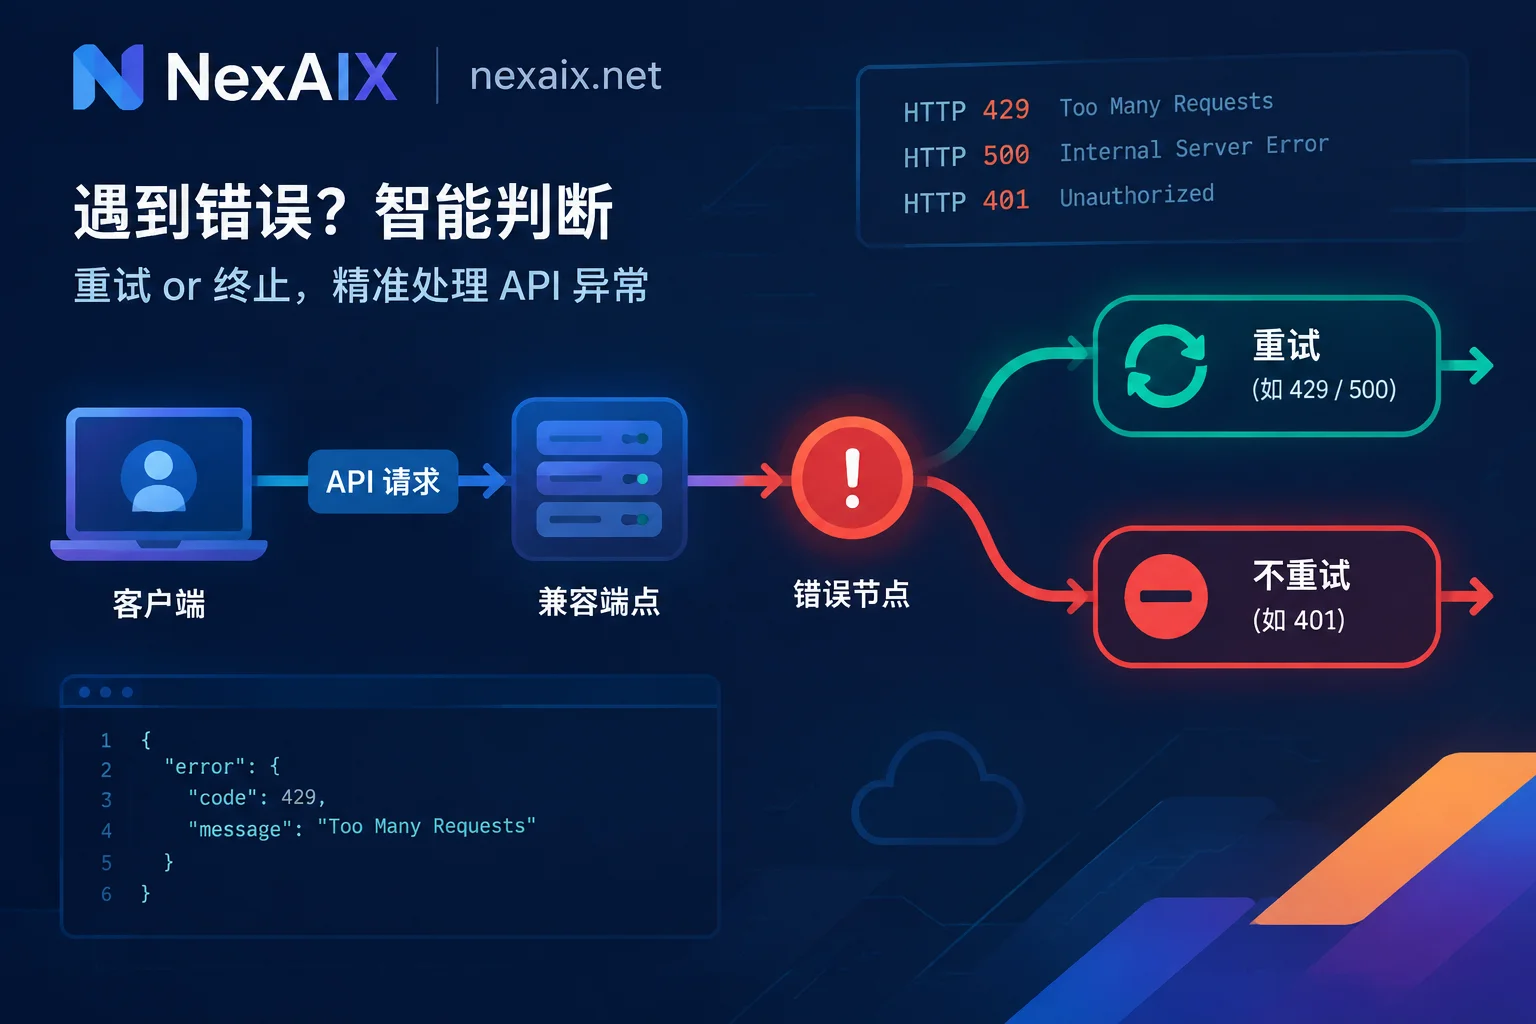
把大模型调用的错误分成「可重试的瞬态故障」和「重试也没用的确定性故障」,给出 Retry-After 优先、带抖动指数退避的参数取法,以及流式中断、SDK 内置重试嵌套、工具调用副作用这三个容易踩坑的场景的处理方式。

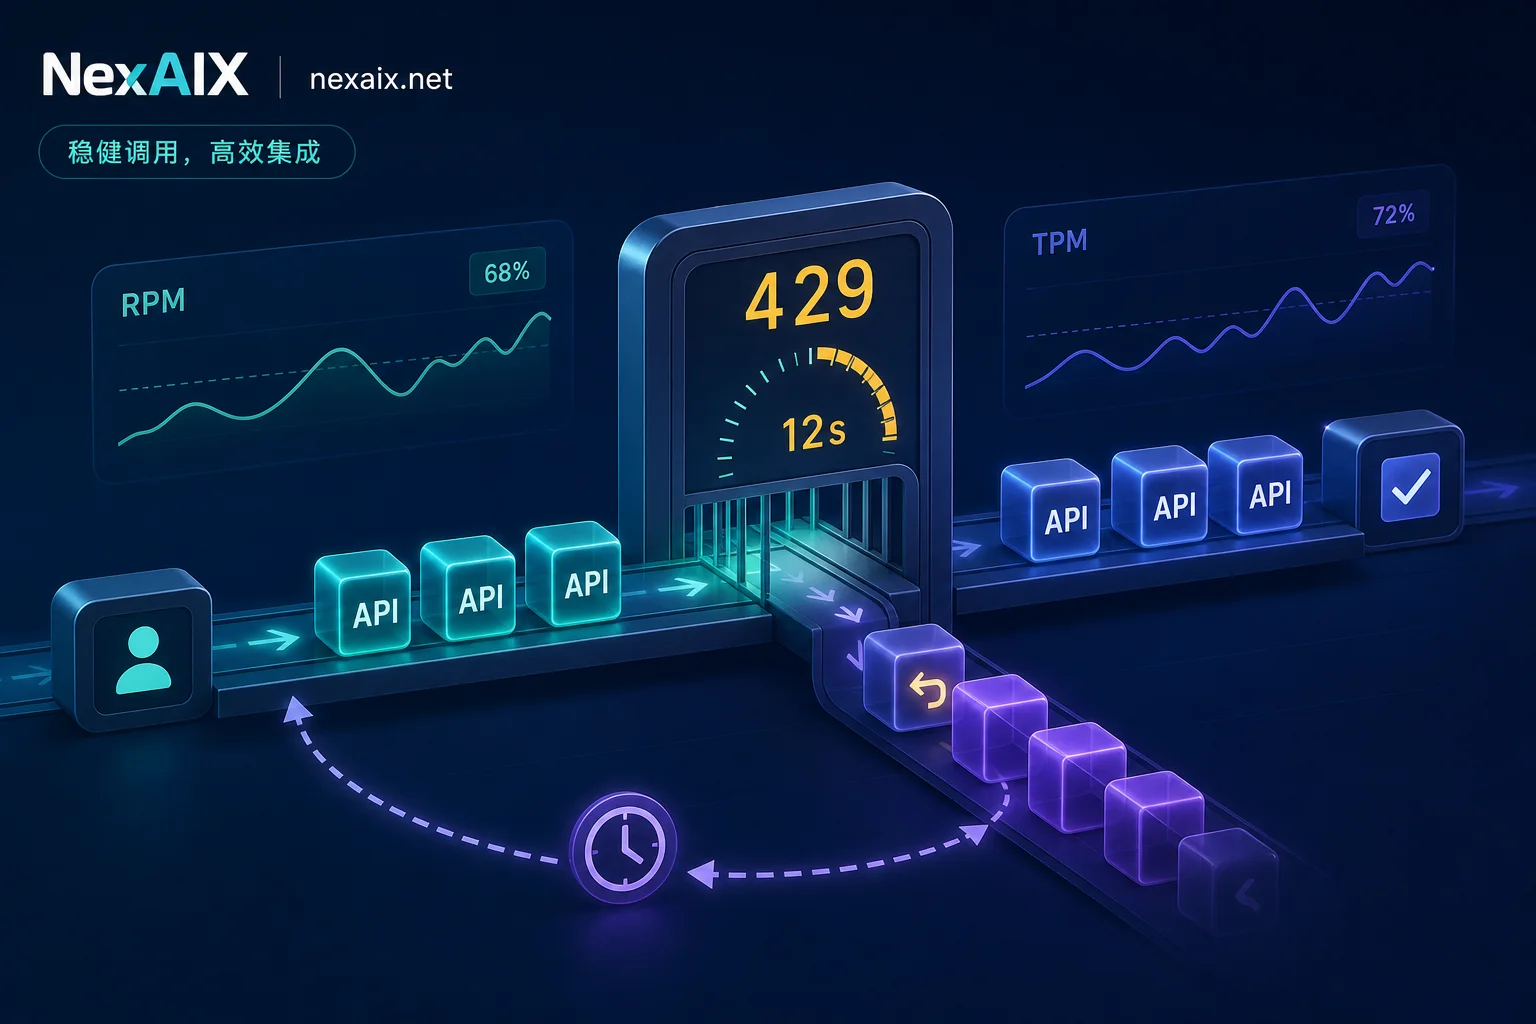
AI API 限流怎么处理?从 429 标头到退避重试与流量隔离

调用大模型 API 撞上 429 时,先看响应标头和 error code 再决定重试策略:带 Retry-After 就按它等,配额耗尽必须立刻停。文章给出限流的四个度量维度、六个余量标头的用法、带抖动的指数退避骨架,以及用令牌桶、max_tokens 收紧和按 Key 隔离在架构层规避限流的做法。