 NexAIX-官方博客
进入 2026 年下半年,大模型领域的“上下文窗口竞赛”已经跨过百万级(1M Token)门槛。无论是全量代码库重构、数十份财务与法务尽调文档的交叉比对,还是长时序 AI Agent 在多轮工具调用中不断累积的沙箱状态与环境记忆,长上下文 API(Long-Context API) 都已从早期的“尝鲜参数”演变为生产系统的核心基础设施。
然而,许多技术团队在将业务从数千 Token 的短对话迁移至几十万乃至上百万 Token 的长上下文调用时,往往会遭遇严重的工程断层:标称支持百万窗口的接口在实际调用中频繁丢失中间关键事实、首字返回时间(TTFT)长到触发网关超时、甚至在某些非正规渠道中遭遇无报错的“静默截断”。
本文将从长上下文推理的底层物理瓶颈出发,系统拆解生产环境中长上下文 API 的四大隐形陷阱,并提供一套涵盖防截断压测、流式超时治理与多模型混合调度的工程落地方案。
一、 为什么“标称百万窗口”不等于“生产可用”?拆解四大工程陷阱
在评估长上下文 API 时,模型发布方宣传的窗口上限只是理论容量。当单次请求携带数十万 Token 进入推理集群时,底层的计算与访存模式会发生质变,进而暴露出四个层面的生产隐患:
1. 显存墙下的“静默截断”与精度缩水
在大模型推理的输入阶段(Prefill),系统需要全量计算输入序列并生成海量的键值缓存(KV Cache)。随着上下文长度线性增长,KV Cache 对 GPU 高带宽显存(HBM)的占用呈数量级飙升。
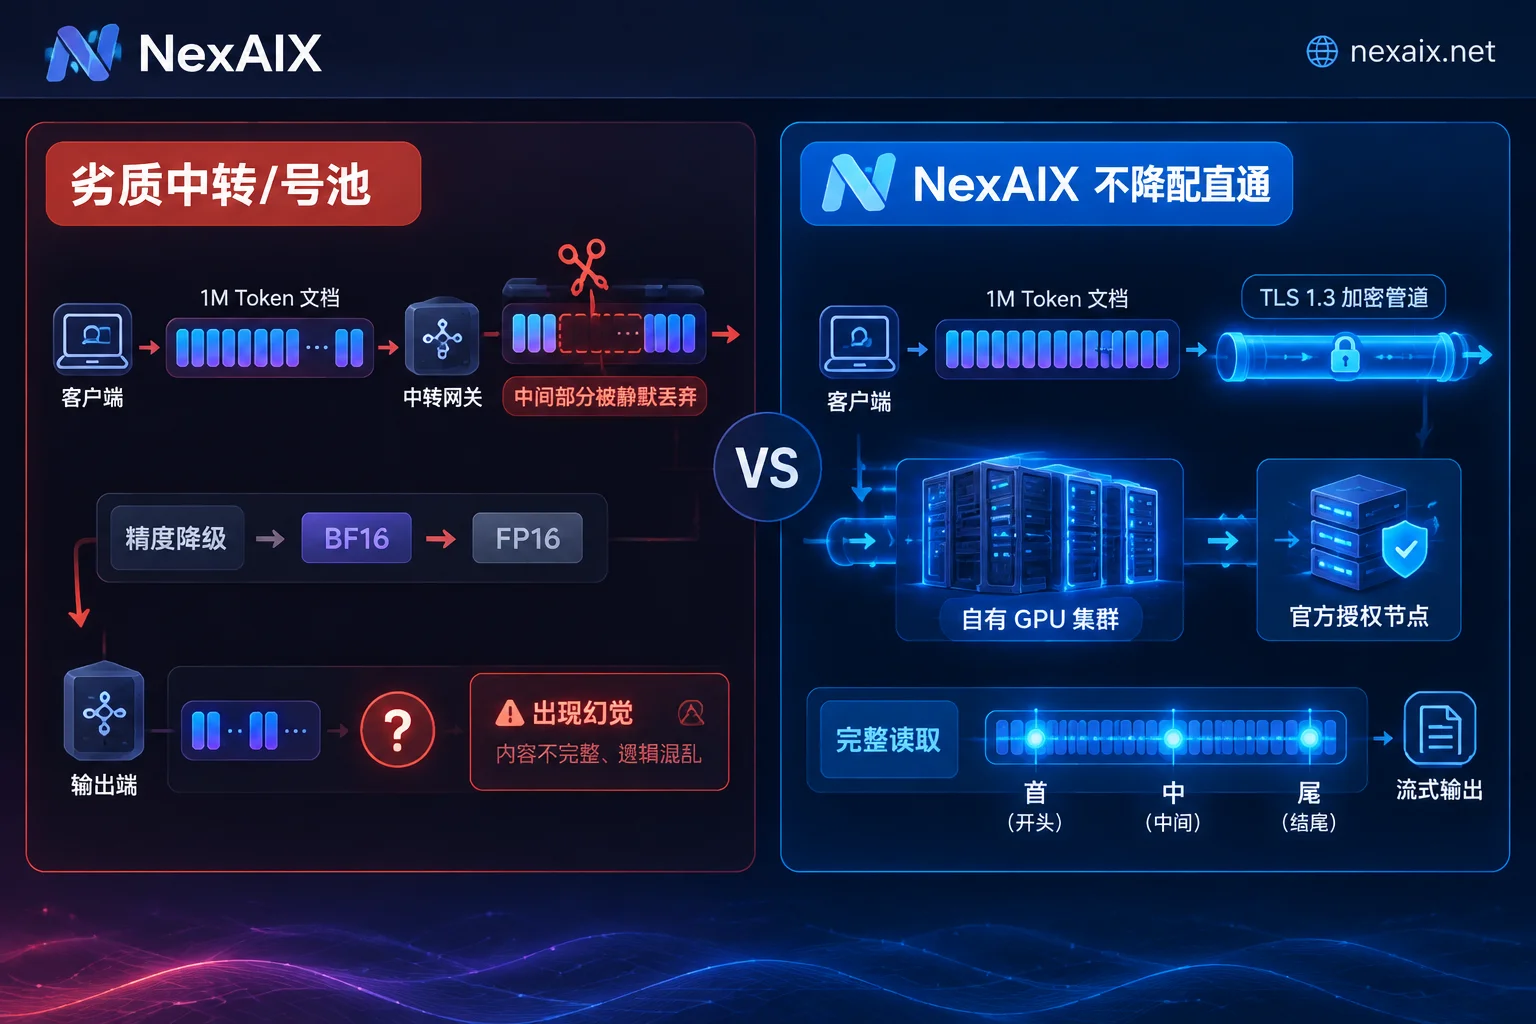
为了省下昂贵的显存开销,部分缺乏算力保障的劣质中转站或号池代理,会在网关层对超长 Prompt 进行静默滑动窗口截断(悄悄丢弃中间段落以保住首尾指令),或者将模型权重与激活值强行量化至极低精度。这会导致客户端收到看似正常的 200 OK 响应,但模型实际上根本没有“看到”被截断的文档内容。(关于输出侧截断的排查,可参考站内文章《大模型 API 输出被截断怎么办:先看 finish_reason,再按原因逐条修》)。
2. “迷失在中间”(Lost-in-the-Middle)与多跳推理衰减
行业主流的长文本评测(如 RULER、AI-Needle 等多任务基准)表明,即便模型在单点“大海捞针”(Single-Fact NIAH)中拿到高分,在面对跨段落多事实召回(Multi-Needle)或长链路逻辑推理时,200K 到 1M 区间内的有效召回准确率仍可能出现显著滑坡。如果底层推理引擎的精度(如 BF16 与 FP8 的选择)未经严格对齐,这种中间注意力的衰减会进一步恶化,直接引发合同漏审或代码幻觉。
3. Prefill 计算洪峰引发的 TTFT 飙升与网关断连
长上下文请求是典型的“重输入、轻输出”或“长输入、长思考”任务。当一次性送入 50 万 Token 时,推理节点需要数秒甚至数十秒才能完成 Prefill 阶段的注意力矩阵计算。这会导致首 Token 延迟(TTFT)与费用随输入长度显著上升。如果客户端沿用短文本时代的非流式调用或短超时配置,连接极易在收到第一个字节前被负载均衡器主动掐断。
4. 核心资产全量投喂带来的数据留存焦虑
在使用传统 RAG(检索增强生成)时,开发者每次只向 API 发送召回的几个零散切片;而在长上下文范式下,团队往往会将整个微服务的代码仓库、未公开的并购协议或全年财务底稿一次性装入 Prompt。如果 API 平台在磁盘上记录明文日志,或通过逆向客户端协议经由不明第三方中转,企业的核心商业机密将面临极高的泄露风险。
二、 生产级长上下文 API 选型的四条硬指标
针对上述工程陷阱,技术负责人在为团队引入长上下文 API 时,不能只看每百万 Token 的账面单价,而应建立一套可审计、可验证的基础设施准入标准:
1. 算力与渠道透明:拒绝号池与逆向包装
长上下文任务对单次请求的显存连续性和并发配额要求极高。个人账号拼凑的“号池”或逆向网页端接口,通常带有严苛的隐式长度限制与极其脆弱的会话状态,根本无法支撑生产级长文本负载。
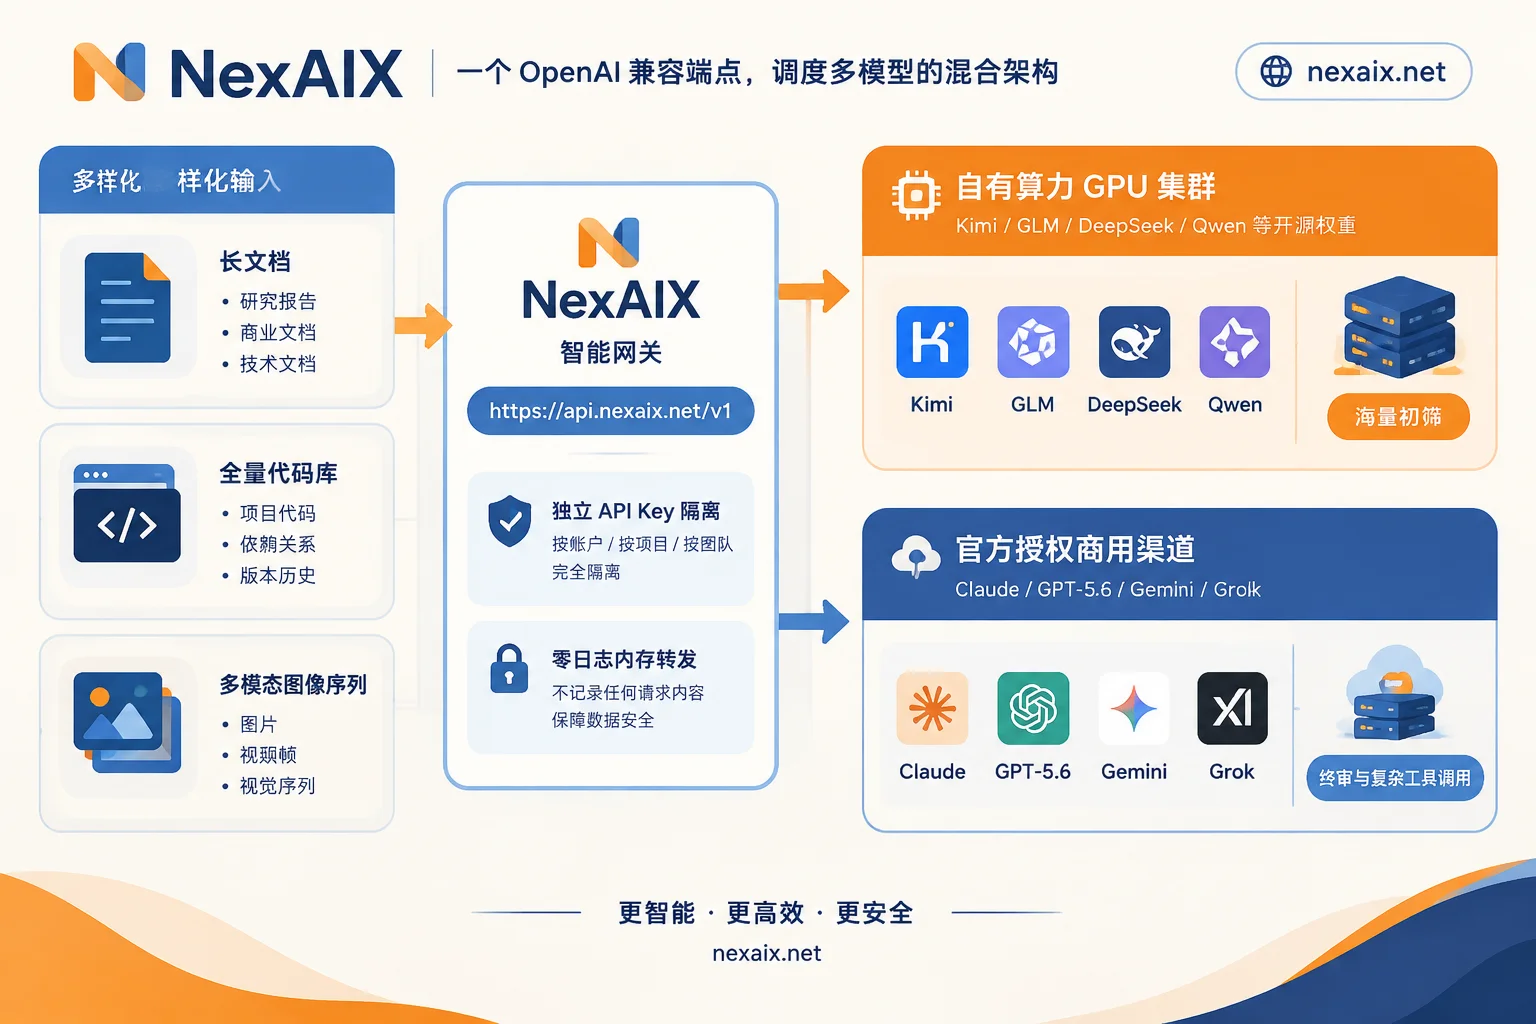
在 NexAIX 的供给体系中,所有模型仅采用两种透明供给方式(详见透明度与渠道说明):
- 自有算力部署(开源权重):将官方发布的开源权重直接部署在自建与自租机房的自有 GPU 集群上,由自有团队独立运维,绝不转售第三方额度。官网当前涵盖 Kimi、GLM、DeepSeek、MiniMax、Qwen、gpt-oss 等主流系列,并在每个模型页清晰标注上下文上限、最大输出、推理精度(如 BF16、FP8、MXFP4 等)及开源许可。(相关模型选型细节可参考《Kimi API 接入与迁移指南》与《GLM API 接入与选型指南》)。
- 官方授权渠道(闭源模型):针对 Claude、GPT-5.6、Grok、Gemini 等闭源旗舰系列,严格走厂商官方商用授权渠道,有合同、有发票、可审计,绝不使用号池或逆向客户端协议。
2. 原生不降配:上下文、最大输出与参数 100% 透传
长上下文应用最怕中间层“自作聪明”地压缩输入。NexAIX 严格执行不降配承诺:
- 返回体中的
model字段即为实际执行推理的模型,绝不偷换小参数模型或暗降推理精度(关于精度差异可参考《模型推理精度 BF16 和 FP8 有什么区别》)。 - 不截断上下文和最大输出,不注入任何隐藏系统提示词(System Prompt)。
- 请求中的
temperature、top_p、max_tokens等控制参数原样透传至底层推理引擎。
3. 明确的高负载限流契约(429 + Retry-After)
长上下文请求会瞬间消耗大量 TPM(每分钟 Token 数)配额。在 NexAIX 的高吞吐架构下,开源模型容量由自有 GPU 集群直接支撑,闭源模型受上游官方配额约束。每把 API Key 均设有明确的 RPM、TPM 与并发上限(如需更高配额可联系申请,按实际容量评估答复)。
当集群遭遇突发洪峰满载时,接口会明确返回标准的 HTTP 429 状态码并携带 Retry-After 响应头——绝不无限期挂起连接拖死业务线程,也绝不在后台静默降级至便宜模型,将退避重试或切换备选模型的控制权完整交还给业务方的编排代码。
4. 内存级无痕转发与清晰的合规边界
针对长文档投喂的隐私顾虑,NexAIX 在平台侧实行严格的不记录对话机制:
- 用户的
prompt和completion仅在内存中完成转发,请求结束即刻释放,绝不写盘,不用于任何模型训练,也不转交给做训练的第三方。 - 平台仅保留用于账单核算与排障的元数据(请求 ID、模型名、Token 计数、时间戳、状态码),且从客户端到推理节点全程采用 TLS 1.3 加密。
- 客观透明的上游边界:对于闭源模型,请求到达厂商侧后的数据留存按各厂商官方商用条款执行,本站不作虚假代承诺。目前官网在 Claude 两个模型页单独注明了上游留存规则(如 Opus 5 支持零数据保留,Fable 5 目前有 30 天留存),其余模型以官网模型页实时标注为准。
三、 动手验证:如何对长上下文 API 进行“防截断与召回”压测?
在将百万上下文接入核心业务前,建议工程团队使用 NexAIX 提供的四种自查方法(固定 Prompt 与随机种子复测、核对 model 字段、接近上限的长度压测、让模型复述收到的全部消息)进行上线前验收。(完整验真体系可参考《怎么确认 API 返回的是不是原版模型:四类可复核的检查方法》)。
下面以 Python 的 OpenAI 兼容 SDK 为例,演示如何构造一个多位置暗桩(Multi-Needle)长上下文压测脚本,一次性检验接口的真实窗口深度、流式首字延迟与参数透传完整性:
import time
from openai import OpenAI

# 1. 仅需修改 base_url 与 api_key,即可无缝接入 NexAIX
client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key="sk-your-nexaix-api-key",
    # 超长输入 Prefill 耗时较长,建议显式放宽连接与读取超时
    timeout=300.0
)

def build_long_context_payload(target_chars: int = 400000) -> str:
    """构造包含首、中、尾三个唯一校验暗桩的长文本负载"""
    needle_head = "【暗桩A-位于头部:项目代号为 AURORA-7749】"
    needle_mid  = "【暗桩B-位于50%深水区:核心清算阈值为 0.0428%】"
    needle_tail = "【暗桩C-位于尾部:最终审批哈希为 9f86d081884c】"

    filler_unit = "这是一段用于压测长上下文窗口容量的非结构化行业基准背景文本。" * 20
    half_filler_len = (target_chars // 2) // len(filler_unit)

    part_1 = filler_unit * half_filler_len
    part_2 = filler_unit * half_filler_len

    return f"{needle_head}\n{part_1}\n{needle_mid}\n{part_2}\n{needle_tail}"

def verify_long_context_api(model_id: str):
    long_document = build_long_context_payload()
    prompt = (
        f"请仔细阅读以下长文档,不要遗漏任何中间信息:\n\n{long_document}\n\n"
        "请严格按 JSON 格式提取文档中的三个暗桩信息:项目代号、核心清算阈值、最终审批哈希。"
    )

    start_time = time.time()
    first_token_time = None
    actual_model = None
    collected_content = []

    # 2. 强烈建议对超长上下文开启 stream=True,避免网关等待超时
    response = client.chat.completions.create(
        model=model_id,  # 例如传入模型页标注的 model ID,如 glm-5.2
        messages=[
            {"role": "system", "content": "你是一个严谨的文档审计助手。"},
            {"role": "user", "content": prompt}
        ],
        temperature=0.0,
        max_tokens=512,
        stream=True
    )

    for chunk in response:
        if first_token_time is None and chunk.choices and chunk.choices[0].delta.content:
            first_token_time = time.time() - start_time
            actual_model = chunk.model
        if chunk.choices and chunk.choices[0].delta.content:
            collected_content.append(chunk.choices[0].delta.content)

    total_time = time.time() - start_time
    print(f"[验证结果] 实际执行模型: {actual_model}")
    print(f"[性能指标] 首 Token 延迟 (TTFT): {first_token_time:.2f}s | 总耗时: {total_time:.2f}s")
    print(f"[召回内容] {''.join(collected_content)}")

if __name__ == "__main__":
    # 实际可用模型 ID 及上下文规格请以 https://nexaix.net/models/ 为准
verify_long_context_api("glm-5.2")接入细节提示:在查阅 NexAIX 模型目录 时,单个模型详情页的 URL 采用将点号替换为横线的slug格式(例如访问https://nexaix.net/models/glm-5-2/查看上下文规格、推理精度与三步接入代码,直接拼写/models/glm-5.2/会返回 404),但在代码的model请求字段中,仍需按页面标注填写原始模型 ID(如glm-5.2)。
四、 架构实战:长上下文多模型混合调度与成本治理
在真实的企业级应用中,把所有请求无脑丢给最昂贵的闭源百万上下文模型,往往会导致算力账单失控。(关于成本核算的更多技巧,可参考《AI API 成本优化实战指南:从 Agent 多模型分层、隐性损耗排查到多 Key 账单治理》)。
借助 NexAIX 的 OpenAI 兼容单端点能力,开发团队只需维护一个 base_url(https://api.nexaix.net/v1)和一把 API Key,即可在完全相同的接口规范下,通过切换 model 字段实现开源与闭源长上下文模型的灵活编排:
- 海量非结构化清洗与初筛(自有算力开源权重):
面对数百万字的原始日志、招股书或全量代码仓扫描,优先调用部署在 NexAIX 自有 GPU 集群上的 Kimi、GLM、DeepSeek、MiniMax 或 Qwen 系列模型。不仅能获得极具竞争力的吞吐性价比,还能依托自有算力保障高并发下的容量稳定性。 - 高密度终审与复杂工具编排(官方授权闭源旗舰):
将提炼后的核心上下文与多步决策链,交由官方授权渠道的 Claude、GPT-5.6、Gemini 或 Grok 系列完成最终的逻辑校验或函数调用(Function Calling)。 - 多模态长上下文无缝融合:
当长文档中包含大量架构图、财报图表或长视频抽帧序列时,可按模型详情页标注的“输入模态”直接选用支持视觉输入的模型,图像按标准 OpenAI 多模态格式传image_url或base64,视频按抽帧后的图像序列传入,无需重构网关代码。 - 生态工具零改造接入:
如果团队使用 LangChain、LlamaIndex、Vercel AI SDK 构建文档流水线,或使用 Dify、Cherry Studio、NextChat、Cline、OneAPI 进行日常研发辅助,只需将自定义 OpenAI 地址指向 NexAIX,即可立刻解锁全部已开通的长上下文模型。 - 按 Key 隔离与精准排障:
在生产环境中,建议为“长文档批处理流水线”与“在线实时交互 Agent”分别创建独立的 API Key。NexAIX 支持每把 Key 独立配额、独立权限与按模型分项的独立用量账单;一旦某个业务线出现异常调用或密钥泄露,可随时单独吊销。同时,每次 API 调用均会返回唯一的请求 ID(Request ID),遇到超时或限流排障时,直接携带请求 ID 联系技术支持即可快速定位链路状态。
五、 总结与快速接入指南
当上下文窗口迈入百万 Token 时代,决定 AI 应用成败的往往不再是评测榜单上的理论分数,而是底层 API 基础设施能否做到真窗口不截断、真精度不降配、高负载不挂起、敏感文档不落盘。
无论你是正在为现有 RAG 系统做长上下文升级的架构师,还是在生产环境维护复杂 Agent 的技术负责人,都可以通过以下三步在 NexAIX 快速完成验证:
- 领额度开测:访问 NexAIX 控制台(api.nexaix.net) 使用邮箱直接注册,无需企业资质,注册即送测试额度,一键生成 API Key 并支持随时导出用量明细。
- 选定目标模型:前往 模型广场(nexaix.net/models) 核对所需开源或闭源模型的上下文长度、最大输出、推理精度与三步接入代码;如果业务依赖清单以外的特定开源权重长文本模型,可直接发送型号与预计用量至 [email protected],工程团队评估算力后将及时回复排期。
- 企业级合规保障:针对有严格审计要求的团队与企业客户,NexAIX 具备完整实体主体,支持签署正式商用合同、开具发票、签署服务协议(SLA)与数据处理协议(DPA);对于核心涉密长文档场景,还可进一步联系 [email protected] 洽谈独立资源池与私有化部署方案。


评论(0)