 NexAIX-官方博客
尽管各大模型厂商的百万 Token 标价在持续下探,许多技术团队在月底核对账单时依然会遭遇“成本惊吓”。随着业务从单轮对话转向多步推理的 AI Agent 与自动化编码工作流,Token 已经从单纯的技术参数演变为直接影响项目 ROI 的经营指标。
在生产环境中,一个复杂的 Agent 任务往往包含读取文件、调用工具、解析报错与多轮自我修正,单次任务触发 50 到上百次连续 API 调用已成常态,Token 消耗速度是传统聊天场景的 10 到 100 倍。更棘手的是,不少团队发现账单失控并非因为业务量暴增,而是源于架构层面的“全量任务无差别调用旗舰模型”、低价渠道暗中降配引发的反复重试,或是某把托管在第三方工具里的 API Key 发生泄露与死循环调用。
真正的 AI API 成本优化,绝不是去寻找来路不明的廉价逆向接口,而是建立一套“模型按需分层、单次损耗可控、渠道真实不降配、账单按 Key 清晰归集”的工程体系。本文将从四个生产级实战维度,拆解如何在不牺牲业务交付质量的前提下把 AI 账单算明白、控下来。
一、 为什么 Token 单价降了,总账单却失控了?
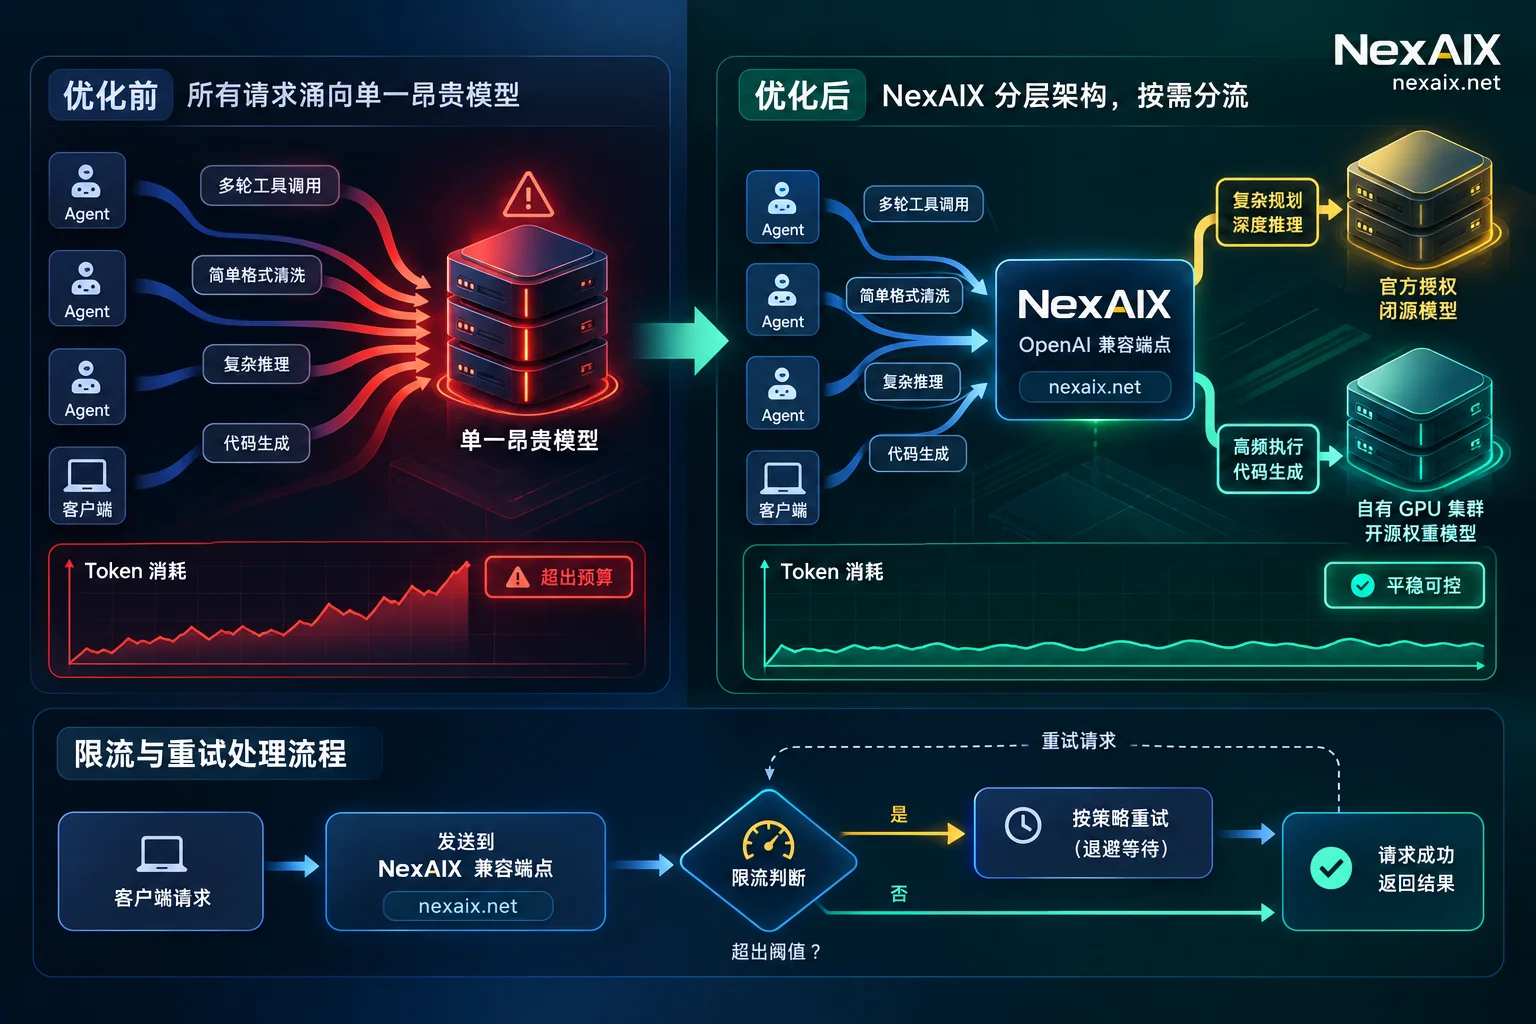
在动手改代码之前,技术负责人需要先定位吞噬预算的四个常见黑洞:
- 算力错配(杀鸡用牛刀):在自动化工作流中,意图识别、JSON 格式清洗、日志提取等轻量级子任务占了调用总量的 70% 以上,却与核心架构设计、复杂代码重构共用同一个高单价的闭源旗舰模型。
- 上下文滚雪球:Agent 每执行一步工具调用,都将完整的历史对话和冗长的工具原始返回(如整页 HTML 或未裁剪的报错堆栈)原封不动地塞回下一次请求。需要注意,超长输入不仅成倍放大输入 Token 计费,还会显著推高首 Token 延迟(TTFT)与整体调用费用。
- 重试风暴与隐性损耗:为了省钱接入了非正规的“低价中转”,结果上游暗中把模型偷换成小模型、量化降配或截断上下文,导致结构化输出频繁解析失败。业务侧的自动重试机制被触发,原本 1 次能成功的任务变成了 5 次无效调用,综合成本反而翻倍。
- 粗放的 Key 管理与突发泄漏:多个项目、开发者的本地 IDE 插件(如各类 AI 编程助手)共用同一把主 Key。一旦某个外部工具发生安全泄漏或某个测试脚本陷入死循环,缺乏独立配额限制的 Key 会在几小时内刷出高额账单。
二、 架构层降本:闭源旗舰与自有算力开源模型的分层组合
降低单次任务成本最直接的杠杆,是将工作流拆解,让不同档位的模型各司其职:用头部闭源模型做“大脑”负责复杂规划与兜底,用高性价比的开源权重模型做“手脚”执行高频子任务。
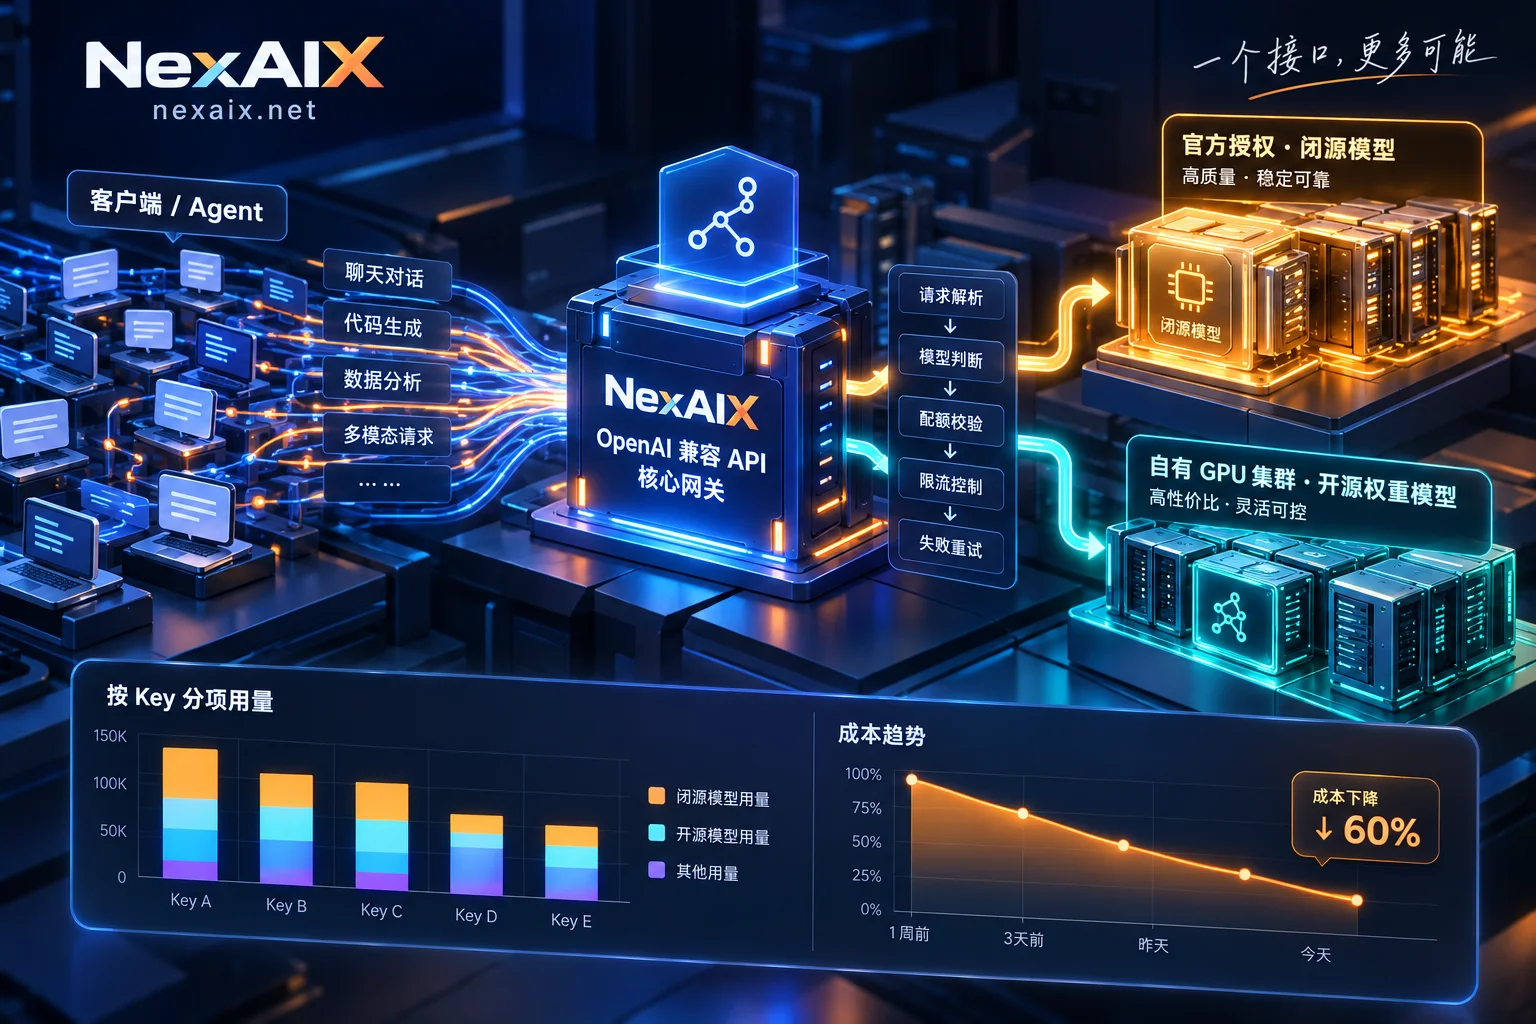
在过去,这种混合架构意味着团队要同时对接五六家厂商的 SDK、维护多套鉴权逻辑和不同的接口参数。而通过 NexAIX 的 OpenAI 兼容接入端点,开发者只需将项目的 base_url 改为 https://api.nexaix.net/v1,用一把 Key 就能以完全一致的接口格式调用全部已开通的闭源与开源模型。
1. 两类确定性供给,按场景精准匹配
在 NexAIX 模型广场 中,所有模型均明确标注了供给方式、上下文窗口、最大输出与推理精度,方便团队按成本与能力做分层选型:
- 核心规划与高难推理(官方授权渠道闭源模型):针对复杂系统架构、多模态深度理解或高难度决策,可直接调用
Claude、GPT-5.6、Grok、Gemini等系列模型。NexAIX 的闭源模型均走厂商官方商用授权,有合同、有发票、可审计,绝不使用号池或逆向客户端协议。 - 高频执行与日常编码(自有算力部署开源权重模型):针对代码补全、文档摘要、数据清洗、RAG 检索重排等占调用量绝大多数的环节,可切换至
DeepSeek、Kimi、GLM、MiniMax、Qwen或gpt-oss系列。这些开源权重模型由 NexAIX 部署在自建与自租机房的自有 GPU 集群上,自己运维,不转售第三方额度,模型页透明标注BF16、FP8、MXFP4等推理精度(关于精度对性能与成本的影响,可参考《模型推理精度 BF16 和 FP8 有什么区别:显存、速度、质量与选型》)。
2. 代码级无缝切换与显式降级控制
由于开源与闭源模型共享同一套 OpenAI Chat Completions 规范(含流式输出、函数/工具调用、多轮对话),在代码里做模型分层只需要修改 model 字段。如果现有应用从其他平台迁入,具体改动细节可查阅《换大模型 API 要改哪些代码:三处必改配置,加四类参数兼容检查》。
在生产环境中,我们建议由业务代码自己掌握路由与回退的决定权。NexAIX 坚持单一供应方、单一端点的透明原则,当遇到突发流量满载时,系统会返回标准的 HTTP 429 状态码并附带 Retry-After 响应头,绝不会在后台静默把你的请求转发给更便宜的模型。开发者可以基于明确的状态码,在业务层编写可控的分层与回退逻辑:
from openai import OpenAI, RateLimitError
import time

client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key="YOUR_NEXAIX_API_KEY"
)

def run_agent_step(task_type: str, messages: list, max_output: int = 1024):
    # 根据任务复杂度显式分层:复杂规划用闭源旗舰,高频子任务用自有算力开源模型
    # 具体模型 ID 请以 https://nexaix.net/models/ 实时列表为准
    target_model = "gpt-5.6" if task_type == "complex_planning" else "glm-5.2"

    try:
        response = client.chat.completions.create(
            model=target_model,
            messages=messages,
            max_tokens=max_output,
            temperature=0.2
        )
        # 核对返回体中的实际执行模型,确保账单与预期一致
        assert response.model == target_model
        return response.choices[0].message.content

    except RateLimitError as e:
        # 收到标准 429 时的显式处理策略:读取 Retry-After 退避,或由业务主动切备用模型
        print(f"触发配额限流,准备退避或切换模型: {e}")
        time.sleep(2)
        # 业务方自主决定是否切换至同档位其他开源权重模型(如 deepseek 或 kimi 系列)
raise小贴士:在查阅单个模型规格与接入代码时,模型页 URL 的 slug 需将模型 ID 里的点换成横线(例如访问https://nexaix.net/models/glm-5-2/查看规格),而在 API 请求体里的model字段仍填写glm-5.2。如果团队有清单以外的开源权重模型需求,可将型号和预计用量发送至[email protected],我们会评估算力后回复排期。
三、 载荷层降本:控制长上下文膨胀与输出截断损耗
选对了模型之后,下一步是拧干每次请求里的“水分”。
- 控制输入历史长度,避免无意义的全量重发:在构建多轮对话或 Agent 循环时,不要把所有历史消息无脑追加到
messages数组中。正如前文所述,超长输入会导致首 Token 延迟和单次费用随输入长度同步上升。针对历史记录,建议只保留最近 N 轮完整交互,更早的上下文通过轻量级开源模型压缩为精简摘要;针对工具调用返回的超长 JSON 或网页源码,先在本地代码做字段过滤再喂给模型。(延伸阅读:《模型上下文窗口对比:窗口与输出上限怎么算,截断、延迟和限流怎么避》) - 合理设置
max_tokens,杜绝截断引发的整次重跑:很多开发者要么不设max_tokens任由模型长篇大论消耗昂贵的输出 Token,要么设得太小导致 JSON 输出在半途被截断(finish_reason: length),致使解析报错、整次请求作废重来。在接入前,请务必在 NexAIX 模型页 核对目标模型的“上下文窗口”与“最大输出”上限,配合精简的 System Prompt 要求模型直接输出结构化结果。(排查截断问题可参考《大模型 API 输出被截断怎么办:先看 finish_reason,再按原因逐条修》)
四、 规避“假低价”陷阱:为什么暗中降配反而让总成本翻倍?
在调研 AI API 成本优化 方案时,许多团队容易被市面上打着“一折官方价”旗号的中转站吸引。然而在实际生产中,这类依靠个人号池拼凑或逆向网页端协议的渠道,往往是导致综合研发成本飙升的罪魁祸首。
为了维持极低报价的利润,不良渠道常采用四类隐蔽手段:
- 将高价模型的请求动态偷换为廉价小模型;
- 将官方原版的
BF16/FP8权重私自降配为极低比特量化版; - 在网关层偷偷截断长上下文或限制最大输出长度;
- 注入隐藏的系统提示词要求模型“简短回答”,破坏业务原有的指令遵循能力。
一旦遭遇这些暗箱操作,你的 Agent 工具调用准确率和代码生成一次通过率会断崖式下跌。原本一次调用就能跑通的自动化流水线,会因为格式错误、逻辑幻觉而触发成百上千次重试,甚至需要工程师花费大量工时去排查“为什么昨天还能跑通的 Prompt 今天突然失效了”。
如何用工程手段确保“每一分钱都买到足额算力”?
NexAIX 在架构设计上严格执行 不降配承诺 与 渠道透明原则:返回体里的 model 字段就是实际执行的模型;不换小模型、不降精度、不截断上下文和最大输出、不注入隐藏系统提示词,且 temperature、top_p、max_tokens 等参数原样透传。
我们不要求用户仅凭口头信任,你可以随时使用以下四种方法对 API 进行独立复核(详细操作步骤见《怎么确认 API 返回的是不是原版模型:四类可复核的检查方法》):
- 固定 Prompt 与随机种子复测:设置低
temperature与固定参数,比对输出质量与逻辑深度是否稳定一致。 - 核对响应体
model字段:检查返回 JSON 中的模型标识是否与请求完全匹配。 - 极限长度压测:构造接近模型标称上限的上下文与输出请求,验证是否存在隐性截断。
- 复述指令自查:要求模型完整复述其收到的全部系统消息与前置指令,排查是否存在网关层私自注入的隐藏 Prompt。
五、 账单与安全治理:按 Key 隔离配额,把每一笔开销算清楚
即便模型选型和代码逻辑都做了优化,如果缺乏完善的密钥与账单管理机制,团队依然面临“账单糊涂账”和“密钥泄露被盗刷”的财务风险。近期行业内多次发生第三方开发工具安全漏洞导致托管在其中的 API Key 泄露、数小时内被恶意刷走数百上千美元的案例。
在生产级成本治理中,必须摒弃“全公司一把 Key 走天下”的做法,利用 NexAIX 的按 Key 隔离与分项账单机制建立财务防火墙(关于密钥管理的更多工程实践,请参考《AI API Key 怎么拿、怎么存、怎么分:从本地开发到生产的接入与隔离》):
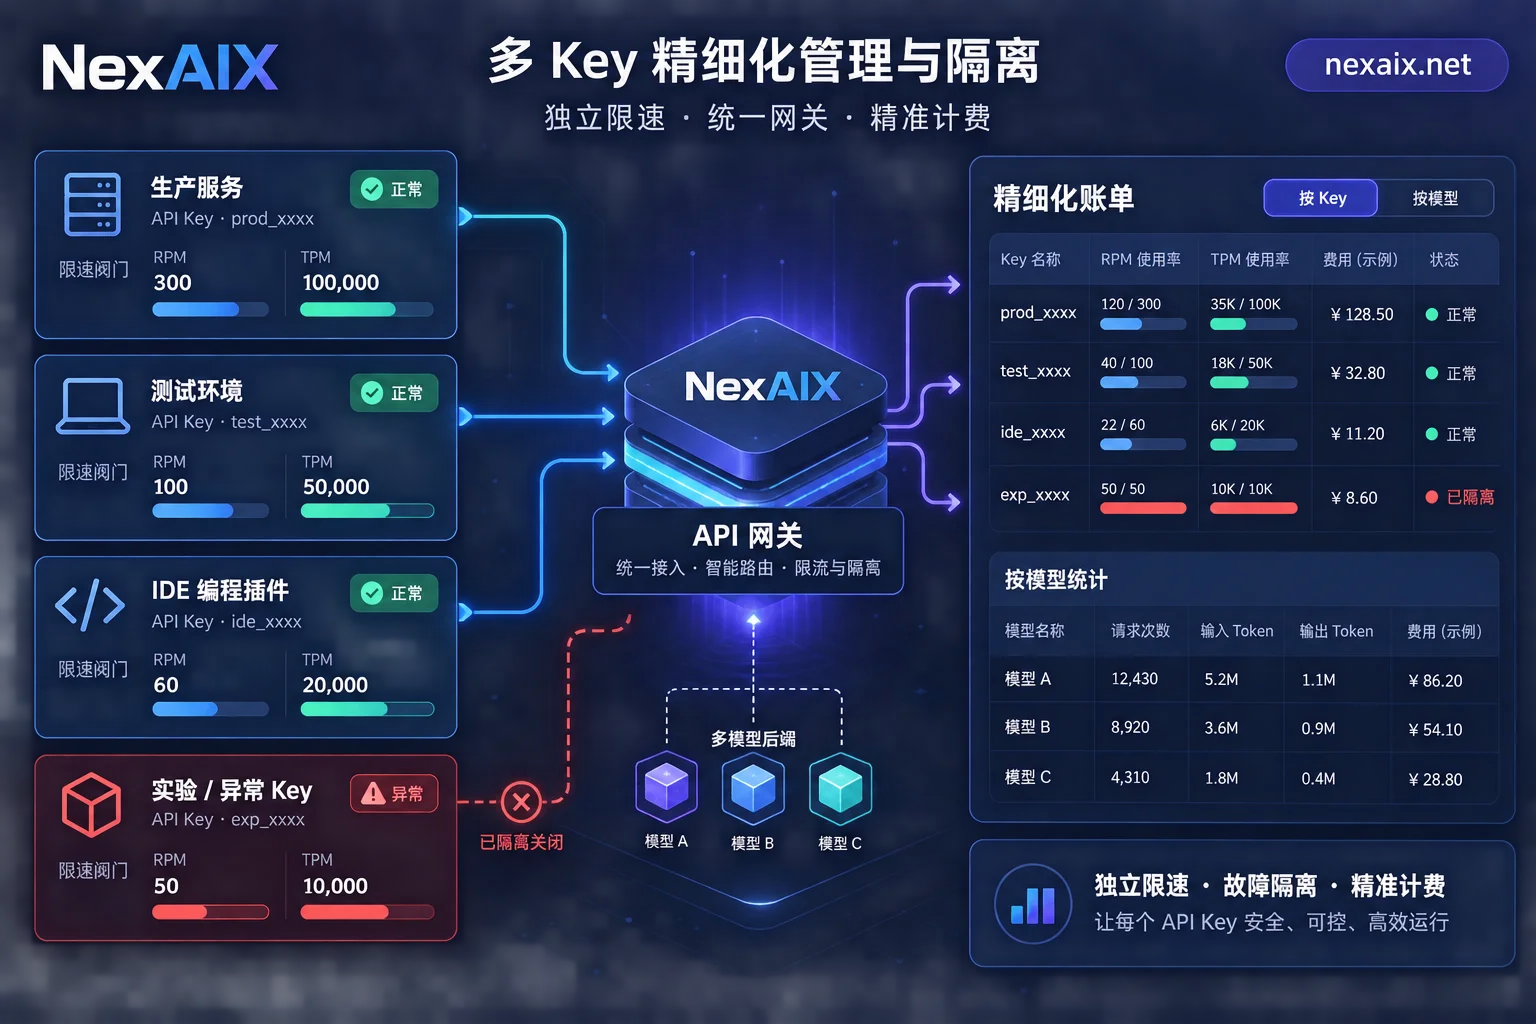
- 一场景一 Key,独立配额与权限:在 NexAIX 控制台 中,你可以为生产环境核心服务、内部测试流水线、以及每位工程师的 Cline / Cherry Studio / Dify 等客户端分别创建独立的 API Key。每把 Key 拥有独立的 RPM(每分钟请求数)、TPM(每分钟 Token 数)和并发上限。
- 故障与泄露的秒级止损:一旦某个开源插件爆出安全漏洞,或者某个实验性 Agent 陷入死循环疯狂发包,独立 Key 的速率上限会率先挡住异常流量洪峰(超出即返回 429);管理员也能在控制台单独吊销该把受影响的 Key,而不会导致线上核心生产服务中断。如果正常业务增长需要更高吞吐,也可随时联系申请提升配额(详见 吞吐量与限速说明)。
- 按 Key 与按模型分项对账:月底复盘 ROI 时,无需在混杂的总账单里盲目猜测。NexAIX 支持按每把 Key 导出独立用量账单,且账单按模型分项统计。哪个微服务耗费了多少旗舰模型 Token、哪个内部工具用了多少开源模型算力,全部一目了然。
- 请求级排障与零日志隐私保护:每次 API 调用都会返回唯一的请求 ID(Request ID)并记录模型名、Token 计数、时间戳与状态码。当发现某次调用耗时或 Token 消耗异常时,技术团队可带着请求 ID 快速定位问题。同时,NexAIX 严格执行 不记录对话策略:你的 Prompt 和 Completion 只在内存中通过 TLS 1.3 加密转发,请求结束即释放、不写盘、绝不用于训练(闭源模型到达上游厂商后的留存政策按各厂商条款执行,如 Claude Opus 5 支持零数据保留,详情以具体模型页标注为准)。
六、 总结:从“盲目砍预算”到“精细化算力治理”
把 AI API 的成本降下来,靠的不是减少 AI 的使用频率,而是把每一分算力都花在刀刃上。回顾整套优化路径,技术团队完全可以在一个迭代周期内完成改造:
- 接入层统一:通过
https://api.nexaix.net/v1统一收口多模型调用,免去维护多套 SDK 的工程成本; - 任务层分流:核心推理走官方授权闭源模型,高频执行走自有 GPU 集群部署的开源权重模型;
- 渠道层保真:认准不降配、不偷换模型、参数原样透传的透明供给,消灭因质量劣化引发的无效重试;
- 治理层隔离:按项目与工具拆分 API Key,利用独立 RPM/TPM 配额防刷,依靠分项账单精准核算每个业务模块的真实成本。
现在,你只需使用邮箱访问 NexAIX 控制台 (api.nexaix.net) 即可完成注册。注册即送测试额度,无需繁琐的企业资质审批,拿把新 Key 就能立即对你的 Agent 工作流开展 A/B 成本压测。对于有合规审计、企业合同与增值税发票需求,或需要评估独立资源池与私有化部署的团队,欢迎随时通过 [email protected] 与我们的工程团队取得联系。


评论(0)