 NexAIX-官方博客
2026 年下半年,维护大模型生产环境的工程团队正在经历一场密集的「接口重构潮」。
继 2026 年 8 月 26 日 OpenAI 与 Azure 同步彻底关停 Assistants API(所有 /v1/assistants 与 /v1/threads 请求直接报错且无延期通道)之后,10 月份官方又密集更新了废弃时间表:不仅早期跟风迁移所依赖的 Dashboard Prompt 对象被列入了 2026 年 11 月 30 日的废弃名单,连 Custom GPTs 也定于 12 月迎来下线;与此同时,厂商正大力将开发者推向带有服务端状态绑定(store: true)的 Responses API 与 Decisions API 等专有新原语。
很多团队在经历了「DALL-E 迁往过渡模型、不到半年又面临二次迁移」或「Threads 历史数据无法自动导入 Conversations」的折腾后意識到:真正的 OpenAI API迁移,不应只是把代码从一个厂商的旧私有接口改写到另一个新私有接口,而是趁机将架构解耦,回归行业通用的标准无状态接口,建立起随时可跨模型、跨算力切换的主动权。
如果你已经了解过基础的GPT API 模型下线潮应对策略或换大模型 API 要改哪些代码,本文将站在架构演进与工程落地的视角,拆解如何完成从「专有状态锁定」到「标准无状态多模型架构」的平滑迁移与生产级灰度验证。
一、2026 年 OpenAI API 迁移的三个工程痛点
在启动代码改造前,技术负责人需要先看清当前 API 迁移中导致返工最多的三个结构性问题:
1. 服务端状态锁定带来的二次迁移成本
无论是已经关停的 Assistants Threads,还是如今主推的 Conversations 接口,本质上都是把对话上下文、工具执行状态托管在单一厂商的云端存储里。一旦遇到接口废弃,官方通常不提供自动化的历史数据迁移工具,工程团队不得不自己写脚本做异构数据回填与格式转换。更棘手的是,当业务出于成本或合规原因需要引入 Claude、Gemini 或开源权重模型时,被托管在单一厂商服务端的状态数据根本无法跨平台流转。
2. 专有原语演进过快,应用层适配疲于奔命
从早期的 Function Calling 语法调整,到 Assistants 轮询机制(while run.status)的彻底废弃,再到新推出的各类专属接口,如果业务代码深度耦合了某一家的专有 SDK 原语,每当上游调整产品线,业务层就要跟着重写核心逻辑。
3. 多模型并存期的「配置与协议碎片化」
为了规避单一上游的限流或故障,很多团队在迁移时会同时引入闭源旗舰与开源模型。但如果直接对接多家原生接口,就会掉进另一个坑:Anthropic、Google 与各家开源模型在消息角色交替约束、流式分块结构以及推理参数上各执一词,同时运维团队还要管理多套 Base URL、多把 API Key、多份账单与不同的企业合同。
二、架构解耦:为什么高可用团队都在回归标准 Chat Completions?
面对频繁更迭的专有接口,越来越多成熟团队在执行 OpenAI API迁移 时,选择了「退一步海阔天空」的策略:将状态收归本地,将通信层统一收敛到标准的 OpenAI Chat Completions 规范。
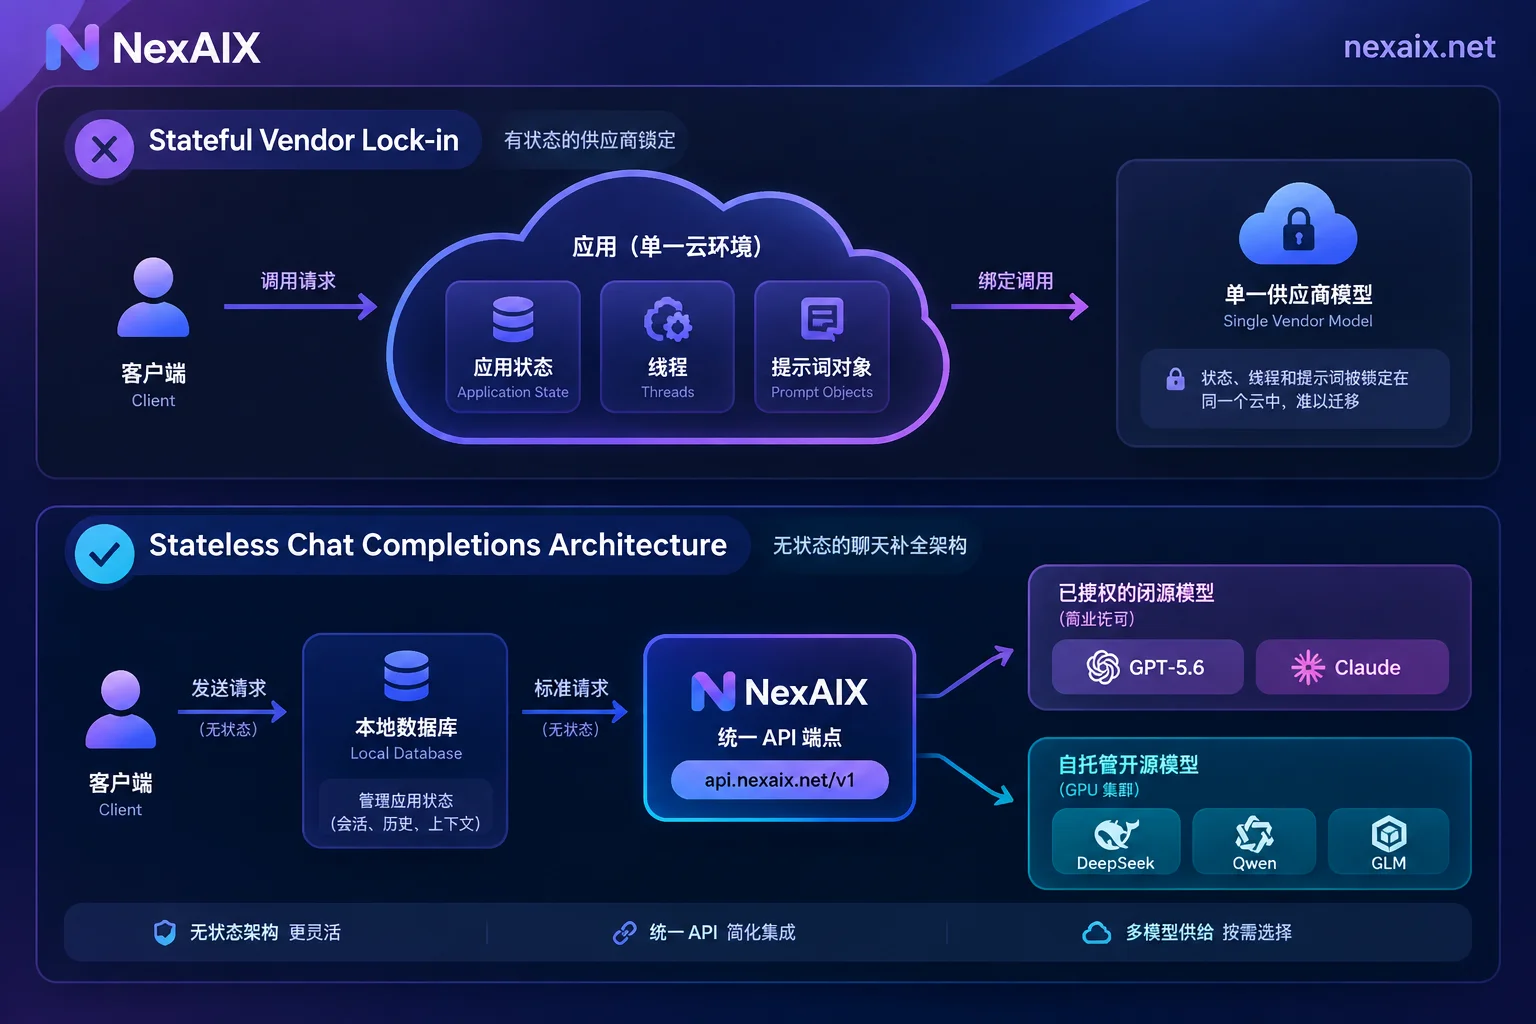
具体而言,这种解耦架构遵循两个核心原则:
- 状态本地化,调用无状态化:
把系统提示词(system/instructions)、多轮历史消息(messages)以及工具定义(tools)保存在团队自己的数据库或缓存中,每次请求通过标准的 Chat Completions 接口全量或滑动窗口式传入。修改提示词只是改一行数据库配置,切换模型只是改一个请求字段。 - 单端点统一接入开源与闭源模型:
通过 NexAIX 的 OpenAI 兼容接入端点,原本使用 OpenAI SDK、LangChain、LlamaIndex、Vercel AI SDK,或是 Dify、Cherry Studio、NextChat、Cline、OneAPI 的项目,绝大多数只需要把base_url改为https://api.nexaix.net/v1,并换上 NexAIX 的 API Key 即可跑通。
在这种架构下,你用同一把 Key、同一套请求代码,既可以调用通过官方授权渠道提供的闭源模型(如 GPT-5.6、Claude、Grok、Gemini 系列),也可以无缝切换到跑在 NexAIX 自有算力部署集群上的开源权重模型(如 DeepSeek、Qwen、GLM、Kimi、MiniMax、gpt-oss 系列),彻底告别为每个新模型重写适配层的历史。关于多模型编排的更多选型细节,可以参考我们的OpenAI兼容API生产级选型指南。
三、代码与参数级迁移核对清单
将应用从旧模型或专有接口迁移到统一的 OpenAI 兼容端点时,除了替换 base_url 和 api_key,还需要重点核查以下四个工程细节,防止在生产环境踩坑:
1. 模型 ID 与文档路由核对
切忌凭记忆硬编码模型名称。在迁移前,建议先前往 NexAIX 模型列表 查看当前在售模型的准确参数。每个独立模型页都会清晰标注该模型的供给方式(「自有算力部署」或「官方授权渠道」)、发布方、许可协议、上下文窗口、最大输出长度、推理精度(如 BF16、FP8、MXFP4 等)以及三步接入代码。
工程避坑提示:在查阅单个模型详情页时,请注意 URL 中的slug规则是把模型 ID 里的点(.)换成横线(-)。例如查看glm-5.2的规格与代码时,访问路径为https://nexaix.net/models/glm-5-2/(直接用点号拼接会返回 404),而在实际发起 API 请求的 JSON 体中,model字段依然填写准确的模型 IDglm-5.2。
如果业务依赖清单以外的特定开源权重模型,也不必自行维护昂贵的 GPU 集群,直接通过邮件([email protected])提交型号与预计用量,团队评估算力后会回复排期。
2. 工具调用(Tool Calling)与流式输出(Streaming)验证
在从 Assistants API 迁出时,原先由服务端黑盒执行的工具循环需要改为客户端显式管理:模型返回 tool_calls 后,业务层执行本地函数并将结果组装为 tool 角色消息再次发起请求。NexAIX 的端点严格按照 OpenAI Chat Completions 规范实现,原生支持流式输出、函数/工具调用与多轮对话,全部已开通模型均支持流式响应,可直接复用现有的流式解析逻辑(具体语言实现可参考 Python 调用 AI API 教程 与 Node.js 调用接入指南)。
3. 多模态输入格式对齐
如果你的迁移涉及视觉理解或视频分析应用,请先在模型页核对目标模型的「输入模态」标签。在请求格式上,图像统一按 OpenAI 标准多模态格式传入 image_url 或 base64 编码;对于视频内容,则按抽帧后的图像序列传入,保持接口层的高度一致。
4. 参数透传与「零降配」自查
许多团队在迁移到第三方兼容端点时,最担心遇到「表面调的是旗舰模型,背后被路由到微调小模型或低精度量化版」的隐性降配问题。
在 NexAIX 的不降配机制下,响应体里的 model 字段严格对应实际执行的模型——不换小模型、不降精度、不截断上下文和最大输出、绝不注入隐藏系统提示词,且你传入的 temperature、top_p、max_tokens 等参数均原样透传。迁移测试阶段,工程团队可以直接使用官方提供的四种方法做盲测复核:
- 固定 prompt 与随机种子进行一致性复测;
- 核对返回体中的
model字段; - 使用接近模型页标注上限的超长文本进行上下文与输出长度压测;
- 让模型复述收到的全部完整消息,排查是否存在隐藏提示词注入。
四、生产环境四步灰度切换与回滚实战
在生产环境中执行 OpenAI API迁移,标准不是「本地跑通 Demo」,而是在真实并发流量下,输出质量、延迟分布、错误率与账单成本均符合预期。推荐采用「四步渐进式灰度策略」:
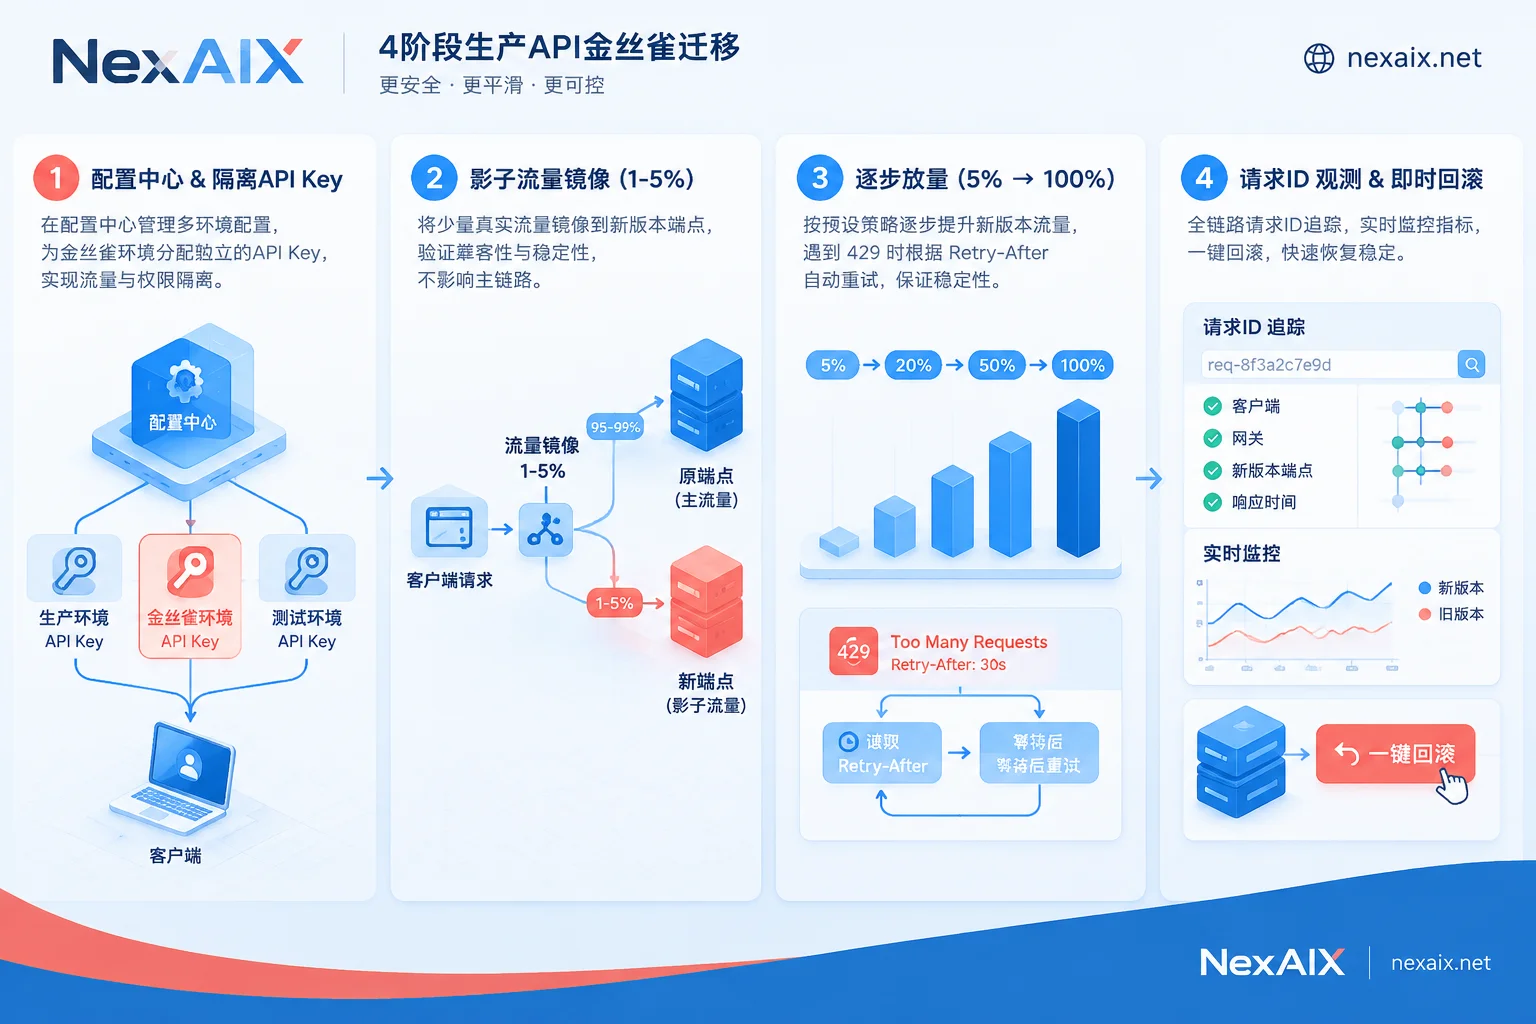
第一步:建立独立 Key 与配置中心开关
不要把新端点的凭证硬编码在代码里,也不要与旧环境共用同一把密钥。你可以先用邮箱在 NexAIX 控制台 注册(无需企业资质,注册即送测试额度),为本次迁移任务单独创建一把 API Key。
在生产架构中,NexAIX 支持按 Key 隔离:每把 Key 拥有独立的配额、独立的权限和独立的用量账单,万一发生泄露可单独吊销而不影响其他服务。将 base_url、api_key 和 model 放入配置中心,确保无需重新发版就能秒级切换流量走向。
第二步:影子流量(Shadow Traffic)对比验证
在正式切流前,将线上 1%~5% 的真实非敏感请求异步复制一份发送到新端点(只记录日志与耗时,不返回给终端用户)。重点对比三项指标:
- 首 Token 延迟(TTFT)与吞吐表现:注意超长输入的首 Token 延迟和费用会随输入长度自然上升。
- 返回格式兼容性:验证 JSON 结构或函数调用参数是否能被现有业务解析器正常消费。
- 成本核算:在控制台导出按模型分项的用量明细,对比单次任务演进前后的真实 Token 消耗。
第三步:按比例放量与确定性的 429 容错设计
完成影子验证后,按 5% → 20% → 50% → 100% 的阶梯逐步放大生产流量。在这个阶段,限流与满载处理是保障高可用的核心:
NexAIX 坚持单一供应方、单一端点的透明策略,不做黑盒自动路由,也不会在算力紧张时悄悄把你的请求转给更便宜的模型。开源模型的容量来自自有 GPU 集群,闭源模型受上游官方配额约束;每把 Key 设有明确的 RPM、TPM 和并发上限(若业务放量需要更高配额,可随时联系申请,团队会按实际容量答复)。
当遇到突发流量触及上限或满载时,服务端会迅速返回标准的 HTTP 429 状态码并附带 Retry-After 响应头,绝不无限期挂起连接拖垮你的应用线程池。客户端只需结合该响应头实现确定性的退避重试,或在业务层自主决定排队还是切往备用模型(详见 吞吐量与限流机制说明 以及 API 错误码重试与降级指南)。
第四步:基于 Request ID 的快速排障与回滚预案
在灰度放量期间,任何异常都需要分钟级定位。NexAIX 的每次调用都会返回唯一的请求 ID(Request ID)。由于平台严格执行不记录对话策略,服务端只保留请求 ID、模型名、token 计数、时间戳和状态码这五项基础元数据;排障时,工程师只需带着请求 ID 联系技术支持,即可快速定位链路状态。
五、合规审计与数据隐私:企业级迁移的底线验收
对于金融、医疗、政企及出海 SaaS 团队而言,API 迁移往往还要经过法务与安全团队的合规审查。这也是许多团队从「野生中转」或「单一海外直连」迁往 NexAIX 的核心原因:
- 供给渠道透明可审计:
NexAIX 只做「自有算力部署」与「官方授权渠道」两种供给,绝不使用个人号池拼凑,也绝不逆向客户端协议。开源权重部署在自建与自租机房的自有 GPU 集群上,自己运维,不转售第三方额度;闭源模型走厂商官方商用授权,有正规主体、有合同、能开发票、可审计。你可以通过 渠道透明度自查指南 了解正规供给与号池逆向中转的本质区别。 - 零日志与端到端加密:
在 NexAIX 零日志架构下,从客户端到推理节点全程采用 TLS 1.3 加密;你的prompt和completion仅在内存中完成转发,请求结束即刻释放,绝不写盘,更不会用于模型训练或转交给做训练的第三方。 - 客观透明的上游数据留存说明:
这是 NexAIX 这一侧的严格承诺。当调用闭源模型时,请求到达上游厂商后将按厂商各自的商用条款处理,各家政策不同,本站不做虚假代承诺(例如当前在售的 Claude 系列中,Opus 5 模型页明确标注支持上游零数据保留,而 Fable 5 目前有 30 天上游留存,具体均以官网对应模型页说明为准)。 - 企业级协议与私有化支持:
针对有严格合规要求的中大型团队,NexAIX 支持签署正式的服务协议(SLA)与数据处理协议(DPA);若业务需要独立资源池或私有化部署方案,也可直接发邮件至 [email protected] 联系评估。
结语:把接口还原给标准,把选择权留给自己
大模型技术栈的迭代不会停歇,未来还会有更多模型版本更替与专有 API 兴衰。一次高质量的 OpenAI API迁移,核心价值在于帮工程团队摆脱对单一专有协议和服务端状态的依赖,建立起一套「标准接口 + 透明算力 + 多模型自由切换」的韧性架构。
现在就可以前往 NexAIX 控制台 免费注册领取测试额度,将你的测试环境 base_url 指向 https://api.nexaix.net/v1,用几分钟时间跑通第一次跨模型无状态调用,为生产环境的平稳演进做好准备。


评论(0)