 NexAIX-官方博客
手上有一段要改的 agent 代码,或者一个跑几十轮工具调用的流水线,想换成 GLM-5.2 试试——这篇按这个顺序走:先判断值不值得换,再改配置,然后处理 1M 上下文带来的超时和截断,最后确认你调到的确实是这个模型。
先判断:这个任务值不值得上 GLM-5.2
GLM-5.2 是智谱(Z.ai)发布的开源权重旗舰模型,MIT 协议,定位写得很直白:长程任务(Long-Horizon Tasks)和智能体工程(Agentic Engineering)。在 SWE-Bench Pro、FrontierSWE 这类复杂软件工程基准上,官方公布的成绩接近 Claude Opus 4.8 和 GPT-5.5。
把它翻译成你手上的任务,大致是这几类值得换:
- 跨几十个文件的重构、带编译反馈循环的修 bug,中间要连续调用工具而不跑偏;
- 整个代码库或者上百页文档一次性喂进去做检索和分析,靠的是 1M token 的工程级上下文;
- 自建 agent 框架里那个负责规划和拆解的节点,对多轮一致性要求高。
反过来,单轮的分类、抽取、短问答、意图识别,换过来不会带来收益。长程模型的推理开销和首 token 延迟摆在那里,这类任务留给更小更快的模型,把 GLM-5.2 用在真正需要它的那一两个环节上,是更常见的做法。
MIT 协议这件事值得单独记一笔:权重可以公开取用,意味着同一个模型名可能来自完全不同的供给方——官方平台、各类中转、自建集群。这直接决定了本文最后一节要做的验证。
改配置:base_url 和模型名,其余别动
GLM-5.2 的 API 兼容 OpenAI 接口规范。接 SDK、接 Cursor、接 Claude Code、接自己写的 agent 框架,都是同一个动作:把请求端点换成 OpenAI 兼容端点,模型名写成对应的 GLM-5.2 标识,业务里的 messages 构造、工具定义、流式解析全部不用重写。
Python SDK 的写法:
from openai import OpenAI

client = OpenAI(
    api_key="你的 Key",
    base_url="https://api.nexaix.net/v1",
    timeout=600.0,  # 长程任务务必显式调大,别用默认值
)

resp = client.chat.completions.create(
    model="glm-5.2",
    messages=[{"role": "user", "content": "..."}],
    max_tokens=32000,
    stream=True,
)
各类客户端的入口位置不同,但改的东西是一样的:Cursor 在模型设置里填自定义 OpenAI Base URL 和模型名;Claude Code 这类工具通过环境变量指向兼容端点;LangChain、LlamaIndex 之类框架用它们的 OpenAI-compatible provider,把 base_url 和 model 传进去。这些客户端对自定义端点的支持程度会随版本变化,配置项叫什么名字以你装的那个版本的文档为准。
模型名的准确写法以你所用平台的模型页为准,别照抄博客里的字符串。如果你在挑供给渠道,NexAIX 的模型清单与供给方式里每个模型都标了是开源权重自有算力部署还是闭源官方授权渠道,单个模型页上有上下文长度、最大输出、限速这些会直接影响你配置的规格,先看这一页再动代码能省一轮返工。
思考深度、工具调用和缓存
GLM-5.2 支持混合推理和多档思考深度(Flexible Thinking Effort),你可以按任务在深度推理和响应延迟之间调。规划类节点开高档,格式化输出、简单改写开低档或关掉,是比较实用的分法。
有个坑要提前说:这个参数在 OpenAI 兼容接口下的字段命名,各家还没统一——可能是 reasoning_effort,也可能是 thinking_budget 之类的透传字段。所以别一上来就在业务代码里硬编码。先发一条最小请求,把参数带上,看回包是正常返回、字段被忽略,还是直接 400,确认之后再封装。不同平台对未知字段的处理策略不一样,这也是换渠道时最容易静默失效的一处。
函数调用(Function Calling)、结构化输出(Structured Output)和上下文缓存都是原生支持的。agent 场景下,建议在正式跑之前单独验一遍 tool_calls 的返回是否严格贴合你给的 JSON Schema,尤其是嵌套参数和枚举值——这一步的通过率决定了长链路的整体成功率,具体验证点可以参考 Agent API 怎么接:从框架配置到工具调用的四个验证点。
用缓存的前提是前缀稳定:把系统提示、工具定义、仓库摘要这类逐轮不变的内容固定放在 messages 最前面,变化的部分往后追加。顺序一乱,缓存就失效了。
1M 上下文的三个坑
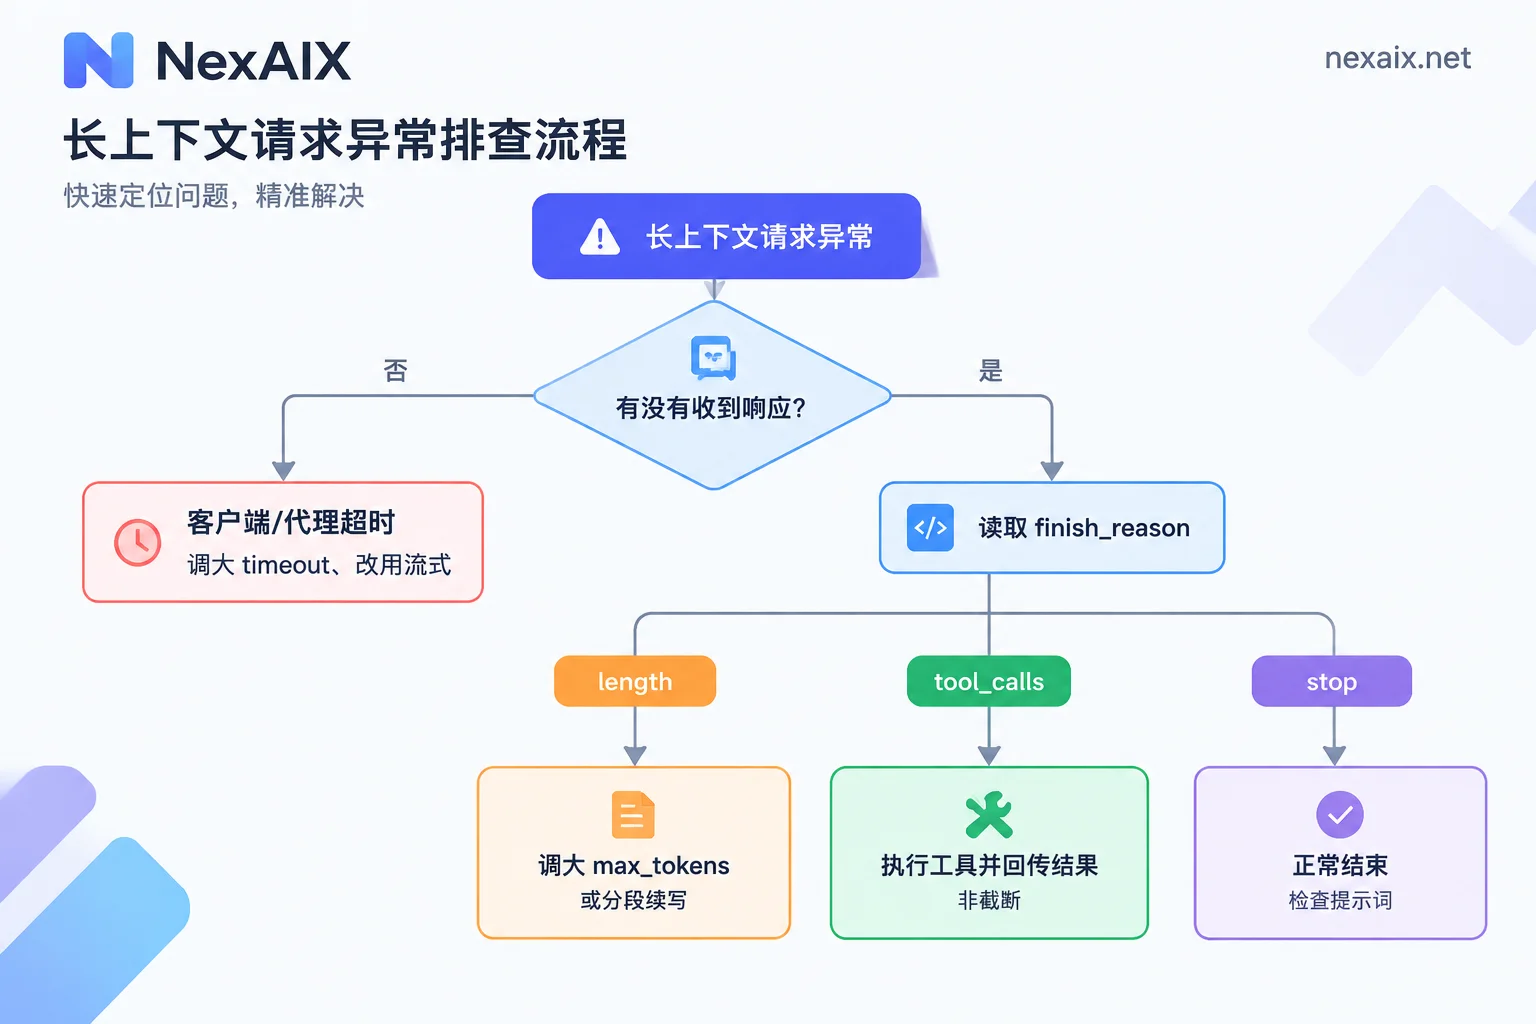
超时。 这是长上下文最常见的失败形态,而且报错信息经常误导人——看起来像网络问题,实际是客户端读取超时。1M 上下文的 prefill 计算密度很大,SDK 默认 timeout 往往不够,请求路径上的反向代理、网关还各有一套空闲超时。两件事一起做:SDK 或 HTTP 客户端里显式调大 timeout;能用流式就用流式,首 token 早点回来,中间设备也不会因为长时间无数据而掐断连接。流式解析本身的坑见 流式输出 API 怎么接:SSE 解析、Token 统计与代理卡顿排查。
截断。 输出看着不完整时,不要靠肉眼判断,去读响应里的 finish_reason:
length:撞到了max_tokens或者单次输出上限,调大参数,或者把任务拆成多段续写;tool_calls:这不是截断,是模型在等你执行工具并回传结果;stop:正常结束,内容短是提示词的问题,不是接口的问题。
流式场景下别忘了读最后一个 chunk 的 finish_reason,很多人只拼接了 delta 就丢掉了这个字段,于是把正常的 length 截断误判成模型能力不行。
延迟和限流。 GLM-5.2 在架构上做了针对性优化:引入 IndexShare 机制,每 4 层稀疏注意力共享同一个索引器,使 1M 上下文下的 per-token FLOPs 降低约 2.9 倍;投机解码的多 Token 预测(MTP)层也做了改进,提升了接受长度和吞吐。但这是相对同规模长上下文方案的优化,不等于喂 1M 和喂 8K 一样快。工程上还是老三样:只塞真正需要的内容、稳定前缀吃缓存、长任务拆段。
并发上长请求会很快吃掉 token 级配额,429 比短请求场景来得更早。退避策略先看响应头带不带 retry-after,别一上来就固定 sleep,细节见 AI API 限流怎么处理?从 429 标头到退避重试与流量隔离。
确认你调到的真是 GLM-5.2
开源权重模型的接入方多,这一步不能省。两类需要区分的情况:
一是官方侧的别名转发。 智谱开放平台在版本更新中,对部分套餐(如 GLM Coding Plan)的历史模型别名启用了自动转发规则,比如把 GLM-5.2 路由到更高版本的 GLM-5.3。这本身通常是升级而不是缩水,但如果你正在做版本对齐的回归测试,或者下游解析强依赖某个版本的输出风格,静默换版本会让结果不可复现。选套餐和写调用代码时,先确认你用的通道是固定版本还是跟随转发。
二是第三方节点的降配。 换小模型顶包、量化降精度、悄悄砍上下文窗口,这三种在表层回包上都看不出来。可做的探针有三条:
- 长上下文压力测试。 在 100K 以上的输入里,在开头、中间、结尾三个位置各埋一条唯一标记,跑多次问检索准确率。窗口被砍过的节点,靠前的标记会系统性丢失。
- 多轮复杂推理链一致性。 同一个需要连续推理的任务跑若干次,看结论和中间步骤是否稳定。精度被降过的部署,表现是波动变大,而不是单次答错。
- 回包字段核对。 记录每次响应里的 model 字段和 usage 统计,进日志长期比对。字段能证明的东西有限,但版本悄悄变了它通常会先露出来。
提醒一句:单次质量下滑不能直接判定为降配。提示词改动、温度参数、缓存命中与否都会影响输出,得靠多次采样和固定测试集来看趋势。判定逻辑可以参考 稳定 AI API 怎么选?版本标识与路由回退的核验方法,以及 API 中转站选型三大工程风险 里关于供给透明度的部分。
如果你不想自己从零搭这套验证,可以直接对着 NexAIX 的四条承诺与验证方法逐条复核——不换小模型、不降精度、不砍上下文、配额与限速公开,每条都写了对应的验证手段,你也可以拿自己的探针去跑一遍。
上线前过一遍
- base_url 和模型名改完,其余调用逻辑保持不动;
- timeout 显式设过,长任务走流式;
- 日志里记
finish_reason和 usage,不靠肉眼判断截断; - 思考档位字段先用最小请求试通,再封装进业务代码;
- 429 的退避读
retry-after,不同业务用不同的 Key 隔离,避免一条链路把配额吃光影响其他功能; - 留一个固定的长上下文测试集,定期跑,作为版本变化的基线。
真要动手,最省事的顺序是:先在模型页确认 GLM-5.2 的供给方式、上下文上限和单次最大输出,再拿注册赠送的测试额度把上面那几条探针跑一遍,确认没问题了再把生产流量切过去。接入文档和获取 API Key 的入口在官网导航里。


评论(0)