 NexAIX-官方博客
2026 年 10 月中旬,MiniMax 推出了主打高频生产力与编码工作流的 MiniMax M3.1 Flash,并宣布开放模型开源权重;加上此前已经开源权重的旗舰模型 MiniMax M3 以及经典的长文本基座 MiniMax-M1、MiniMax-Text-01,MiniMax 系列在百万级(1M)上下文处理、原生多模态理解与 Agent 工具调用上形成了完整的模型梯队。
不过,工程团队在将 MiniMax API 接入现有生产环境时,往往会遇到三类实际问题:
- 模型梯队与边界怎么选:M3.1 Flash 速度快、单任务成本低,但在行业基准测试中体现出“极少拒答、不确定时容易强行生成”的特征;什么时候用 Flash 跑高频任务,什么时候切回 M3 或闭源大模型做交叉核验?
- 接口协议怎么统一:原生文档中既有专属的
chatcompletion_v2路径,也有兼容 Anthropic 的入口,而大多数团队现有的业务代码、LangChain 或 Dify 工作流都建立在标准 OpenAI Chat Completions 规范之上。 - 长文本与开源算力怎么保障:百万上下文和多模态输入对底层显存与带宽要求极高,如果接入了层层转售的第三方廉价渠道,极易遭遇隐式截断上下文、偷换量化精度甚至暗中降级模型的问题。
本文将围绕这三点,梳理 MiniMax 核心模型的选型判断标准,并演示如何通过 NexAIX 的自有算力部署与标准 OpenAI 兼容端点,用一把 Key 完成从单模型调用到跨模型校验的完整闭环。
一、MiniMax 核心模型选型:M3.1 Flash、M3 与长文本系列对比
在动手改配置之前,先按业务场景把 MiniMax 当前主流模型的定位拆开:
| 模型系列 | 核心定位 | 上下文与输出能力 | 典型适用场景 | 工程注意事项 |
|---|---|---|---|---|
| MiniMax M3.1 Flash | 日常高效编码与快速 Agent 执行 | 最高 1M 上下文,最高 524K 输出,支持 effort 思考深度调节 | 仓库级代码补全、高频工具调用、结构化提取、多步工作流路由 | 遇到知识盲区时拒答率低;涉及严肃事实与合规输出需搭配检索(RAG)或复核模型 |
| MiniMax M3 | 前沿原生多模态与长程复杂推理 | 最高 1M 上下文(MSA 稀疏注意力架构),图文/视频多模态理解 | 10 小时级长程 Coding、复杂算子优化、含大量图表的长文档分析 | 推理深度高,首 token 延迟与算力消耗高于 Flash 系列 |
| MiniMax-M1 / Text-01 | 混合注意力长文本推理与基础生成 | 1M 至 4M 级超长上下文(Lightning Attention 架构) | 超长日志排查、整本技术手册归档摘要、低复杂度长文批处理 | 早期开源权重版本,工具调用与多模态原生对齐能力弱于 M3 系列 |
选型实战建议:用「执行 + 校验」双模型消除幻觉短板
根据近期第三方评测机构的实测数据,M3.1 Flash 在代码基准(DeepSWE v1.1 得分 73.7%)和金融工具流(BankerToolBench 得分 76.2)上逼近头部旗舰模型,中位数生成速度超过 170 token/s;但在面对不确定知识时,它会倾向于尝试回答所有问题而非坦承未知,导致在非正确反馈中的幻觉占比较高。
因此,在生产级 Agent 架构中,更稳妥的做法是:
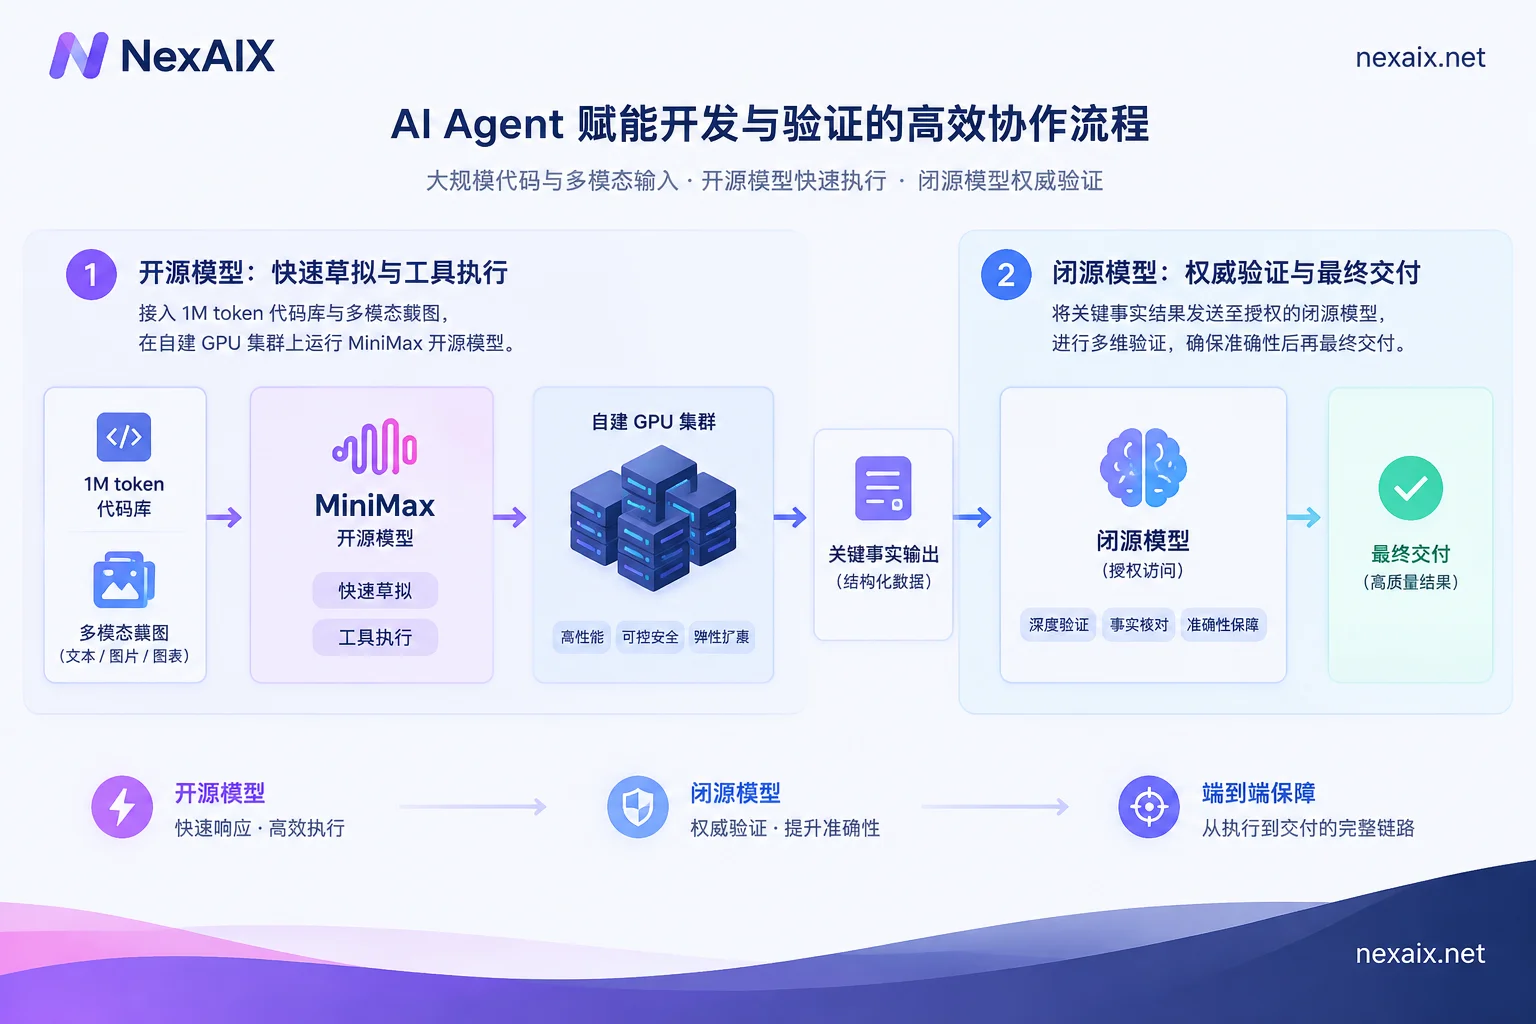
- 主干链路:用 MiniMax 开源权重模型承担长文档吞吐、日志清洗、代码草稿生成和工具参数拼装。
- 护栏与复核链路:在涉及金融数据核对、法律条款引用或最终交付前,将关键摘要交给通过官方授权渠道接入的闭源模型(如 Claude Opus 5 或 GPT-5.6)做二次校验。如果你之前关注过开源与闭源模型的分工,可以参考开源权重模型 API 和官方授权渠道有什么区别:精度、上下文、留存与限流怎么看。
二、为什么选择自有算力部署调用 MiniMax 开源模型?
随着 MiniMax M3、M1 以及 M3.1 Flash 等模型陆续开放权重,市面上出现了大量提供 MiniMax API 的中转服务。但像 MiniMax 这类参数量庞大、且依赖混合专家(MoE)与稀疏注意力机制的百万上下文模型,对推理集群的显存容量和节点间通信带宽极其敏感。
如果使用的是不透明的“二手额度转售”或“号池逆向”渠道,往往会踩中三个隐蔽的坑:
- 隐式截断上下文:明明请求里传了 300K tokens 的代码库,上游为了省显存把窗口硬生生截断到 32K,导致模型漏看关键依赖却不报错。
- 精度缩水与降配:未经声明就将原本需要高精度的推理任务降级为激进的低比特量化,导致长程代码生成出现语法崩坏(关于不同精度的实际影响,详见模型推理精度 BF16 和 FP8 有什么区别:显存、速度、质量与选型)。
- 高峰期静默换模型:在上游限流时,把发往旗舰模型的请求偷偷路由给低配小模型。
在 NexAIX 上,MiniMax 系列属于自有算力部署(开源权重)供给:
- 自有集群独立运维:官方发布的开源权重直接部署在 NexAIX 自建与自租机房的自有 GPU 集群上,自己运维,不转售第三方额度(了解两种供给模式与号池逆向的区别可查看透明供给说明)。
- 规格与精度透明标注:每个模型详情页均明确标注供给方式、上下文窗口、最大输出上限、实际运行的推理精度(如 BF16、FP8、MXFP4 等,按模型标注)以及开源许可。
- 严格不降配承诺:返回体里的
model字段就是实际执行的模型;不换小模型、不降精度、不截断上下文和最大输出、不注入隐藏系统提示词,所有采样参数原样透传(官网提供了四步复测法,参见不降配承诺与自查方法)。
提示:由于 MiniMax 模型迭代迅速,在售的具体型号、模型 ID 与实时规格请以 NexAIX 模型广场 为准。在访问单个模型页https://nexaix.net/models/{slug}/时,注意 URL 中的{slug}需把模型 ID 里的点(.)换成横线(-),而代码请求体里的model字段仍按模型页标注的原样填写。如果团队需要调用刚发布权重但尚未上架的开源型号,可直接发送型号和预计用量至[email protected],评估算力后会直接回复排期。
三、三步接入:用标准 OpenAI 协议统一调用 MiniMax API
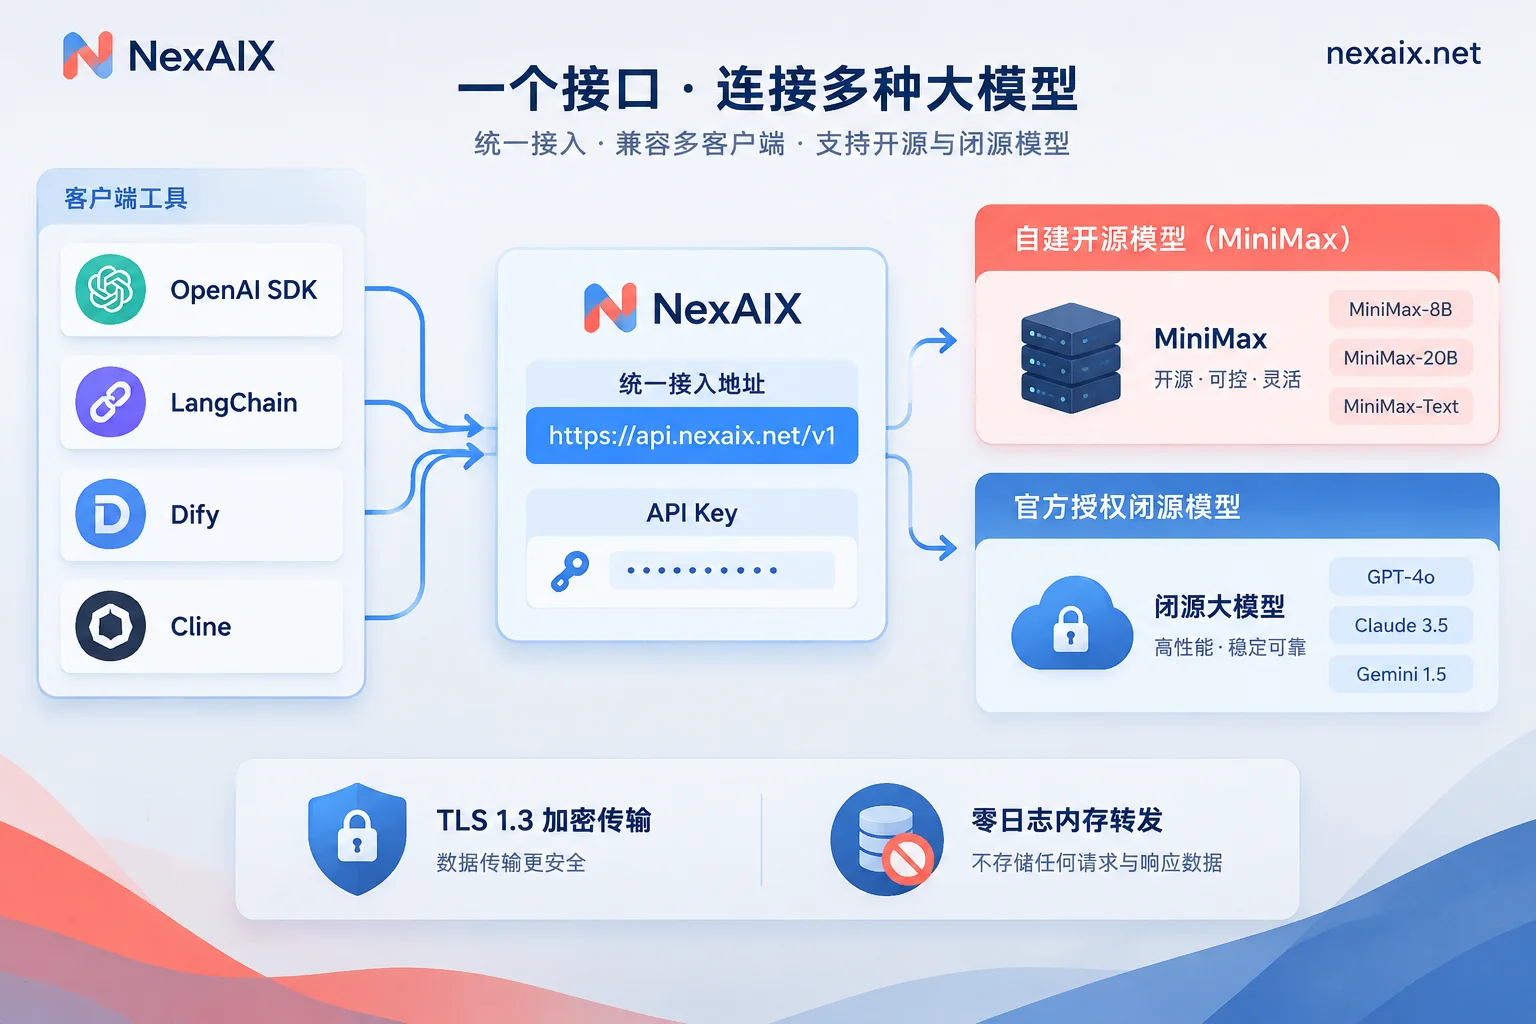
NexAIX 完整按 OpenAI Chat Completions 规范实现。这意味着你不需要为 MiniMax 单独维护一套 SDK 或特殊 URL 路径,只要把现有项目的 base_url 指向 https://api.nexaix.net/v1 并换上 NexAIX 的 API Key,就能直接调用。
1. 获取 API Key 与测试额度
前往 NexAIX 控制台 使用邮箱注册(不需要企业资质),注册即送测试额度。在控制台创建一把 API Key 即可访问全部已开通的开源权重与闭源模型。
2. Python 标准接入与流式调用示例
超长上下文请求的首 token 延迟(TTFT)会随输入长度自然上升,因此生产环境中强烈建议开启 stream=True 流式输出。以下代码展示了如何通过官方 openai Python SDK 调用 MiniMax 模型(请将示例中的 <minimax_model_id> 替换为 模型列表页 中实际展示的模型 ID):
import os
from openai import OpenAI

# 仅需修改 base_url 与 api_key,其余代码与标准 OpenAI SDK 完全一致
client = OpenAI(
    base_url="https://api.nexaix.net/v1",
    api_key=os.environ.get("NEXAIX_API_KEY")
)

response = client.chat.completions.create(
    model="<minimax_model_id>",  # 以 https://nexaix.net/models/ 模型页标注的 ID 为准
    messages=[
        {"role": "system", "content": "你是一名资深后端架构师,请基于提供的源码与日志定位并发死锁原因。"},
        {"role": "user", "content": "请分析以下模块依赖与线程转储日志..."}
    ],
    temperature=0.2,
    max_tokens=8192,
    stream=True
)

for chunk in response:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
如果你的项目使用的是 Node.js、LangChain、Dify、Cherry Studio 或 Cline,只需在对应工具的 OpenAI Compatible 设置中填入 https://api.nexaix.net/v1 即可(支持列表见 一键替换接入说明,具体工具配置也可参考站内的 Dify 接入指南 与 Cline 配置教程)。
3. 多模态输入(图像与视频抽帧序列)传递规范
MiniMax M3 系列具备原生多模态理解能力。在 NexAIX 的 OpenAI 兼容端点下,多模态请求按模型页标注的输入模态支持情况处理:
- 图像输入:按标准 OpenAI 多模态格式,在
messages的content数组中传入image_url(支持公网 URL 或 Base64 编码)。 - 视频输入:将视频按关键帧抽帧后,作为多张图像序列依次放入
content数组中传入,非常适合让模型结合连续的 UI 录屏或实验图表序列做代码调试。
# 多模态图像/抽帧序列输入示例
messages = [
    {
        "role": "user",
        "content": [
            {"type": "text", "text": "对比这两张连续的操作录屏截图,指出前端状态未更新的原因:"},
            {"type": "image_url", "image_url": {"url": "data:image/jpeg;base64,<FRAME_1_BASE64>"}},
            {"type": "image_url", "image_url": {"url": "data:image/jpeg;base64,<FRAME_2_BASE64>"}}
        ]
    }
]
四、生产环境避坑:长上下文限流、429 退避与数据安全
把 MiniMax API 投入高并发或百万上下文生产环境时,技术负责人还需要做好以下三项工程治理:
1. 显式处理 429 状态码与应用层跨模型切换
NexAIX 坚持单一端点透明响应,不做隐藏的自动路由与故障转移。当某把 Key 触发 RPM/TPM 并发上限或集群满载时,服务端会立即返回标准 HTTP 429 状态码并携带 Retry-After 响应头,绝不会无限期挂起连接,也不会在后台偷偷把请求转给便宜的小模型(详见高吞吐与限流机制)。
在编写 Agent 循环时,建议捕获 429 并读取 Retry-After 执行退避重试;或者在业务代码里显式把 model 字段切换为备选模型(关于各类报错的完整处理逻辑,可参阅 AI API 错误码怎么看:400、401、404、429、5xx 与 529 的原因、重试与降级)。如果业务进入放量期需要更高的 RPM/TPM 并发配额,可直接联系团队按实际容量申请上调。
2. 控制超长输入的费用与输出截断
虽然模型支持高达 1M 的上下文窗口,但超长输入不仅会拉长首 token 响应时间,单次请求的 token 账单也会随输入长度线性增加。建议:
- 在控制台利用按 Key 隔离机制,为不同微服务或研发小组分配独立的 API Key。每把 Key 拥有独立配额、独立权限和按模型分项的独立用量账单,一旦某把 Key 泄露可单独吊销。
- 每次调用都会返回唯一的请求 ID(Request ID),遇到长文本截断或异常时,先检查返回体中的
finish_reason(排查步骤见大模型 API 输出被截断怎么办),需要平台协查时带着请求 ID 联系支持即可快速定位。
3. 核心代码与业务数据的零日志保障
用 MiniMax 跑百万上下文的企业,往往会把整个私有代码仓或未公开的财务研报放进 prompt。在 NexAIX 这一侧,所有请求遵循严格的零日志策略:
- 内存转发不落盘:
prompt和completion仅在内存中转发,请求结束即释放,不写入磁盘。 - 不用于模型训练:对话内容绝不用于训练,也不转交给任何做训练的第三方;从客户端到推理节点全程采用 TLS 1.3 加密传输,仅保留请求 ID、模型名、token 计数、时间戳和状态码用于账单统计与排障。
- 开源自建集群闭环:由于 MiniMax 等开源权重模型直接运行在 NexAIX 自有算力集群上,数据不会离开自有节点;而如果你在混合工作流中同时调用了闭源模型,闭源请求到达上游厂商后则按各厂商官方条款处理。
五、总结与下一步
MiniMax M3 与 M3.1 Flash 的推出,让百万上下文与多模态 Coding Agent 的单次调用成本大幅下降。在实际落地时,通过 NexAIX 的自有算力集群调用 MiniMax 开源权重模型,并结合官方授权渠道的闭源模型做关键节点的事实核验,既能吃透开源旗舰的吞吐性价比,又能守住生产环境的准确性与数据合规底线。
- 立即查看在售模型与规格:访问 NexAIX 模型广场
- 注册并领取免费测试额度:登录 NexAIX 控制台
- 企业合同、发票与独立资源池评估:如果团队有合规审计、签署数据处理协议(DPA)或私有化部署需求,欢迎发信至
[email protected]沟通方案。