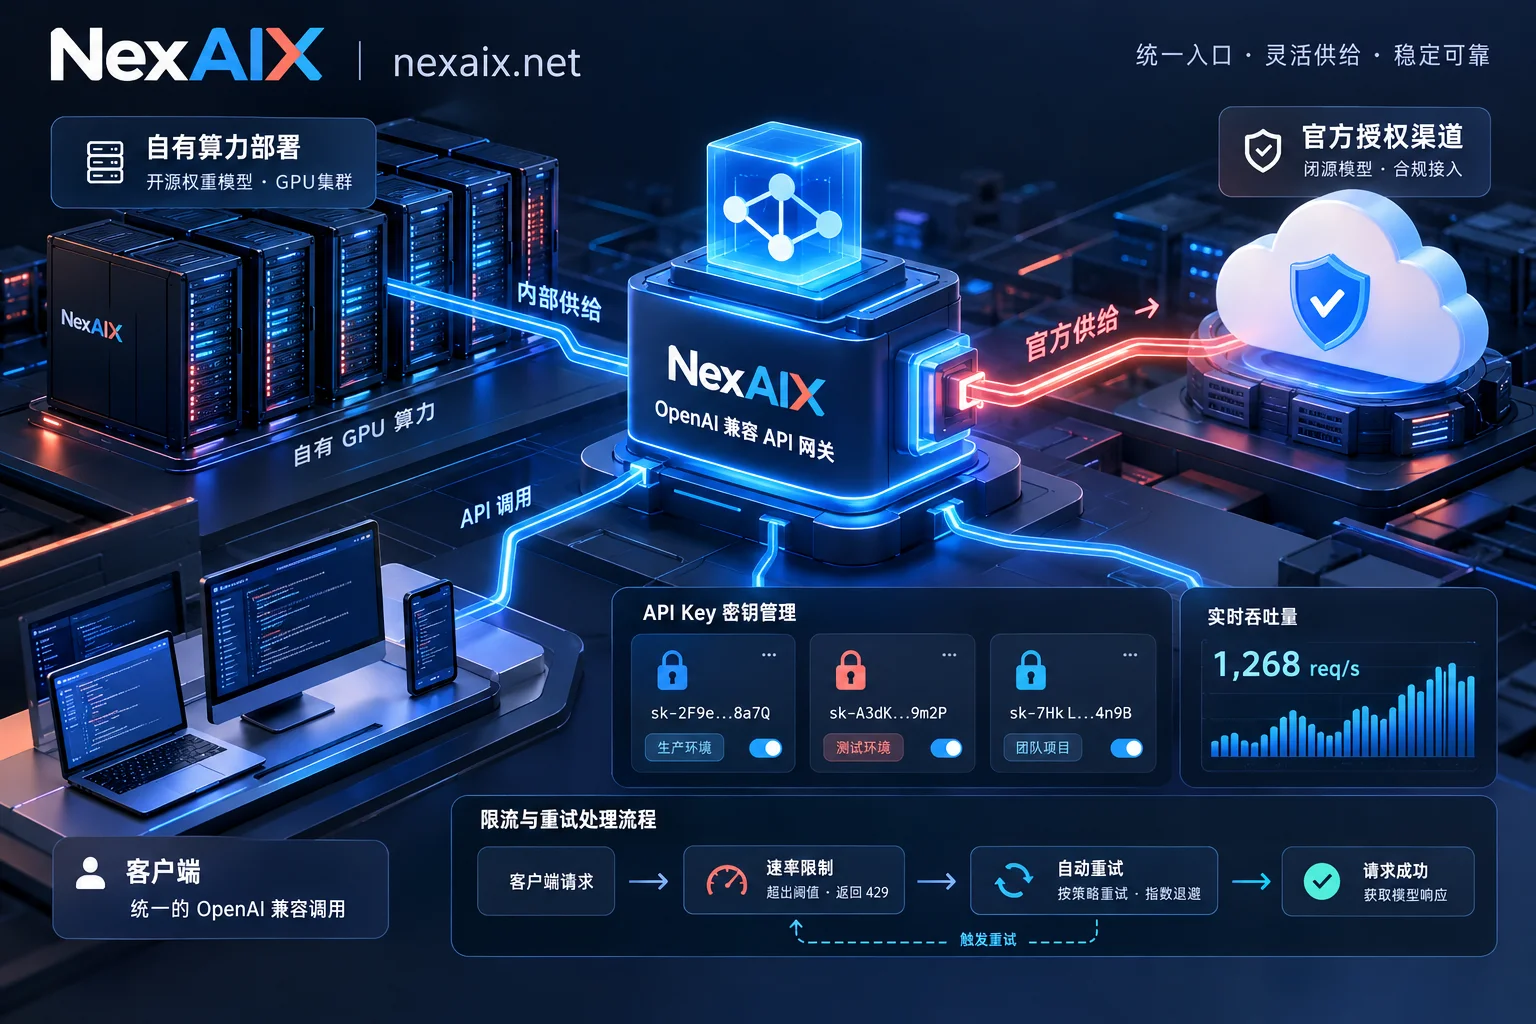
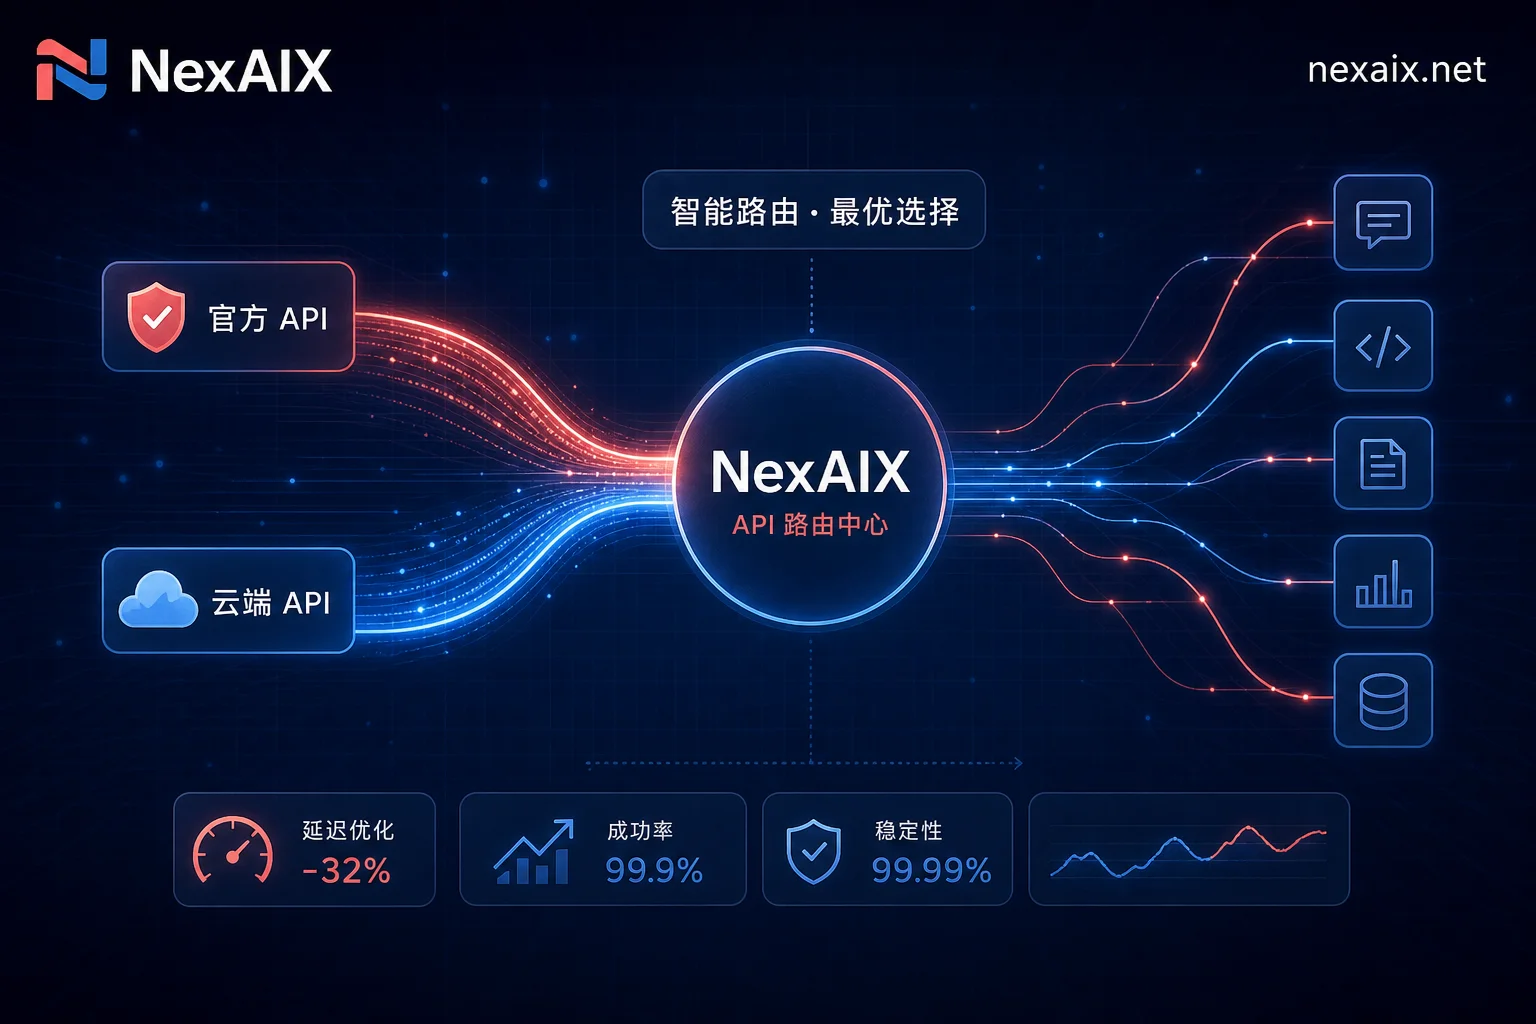
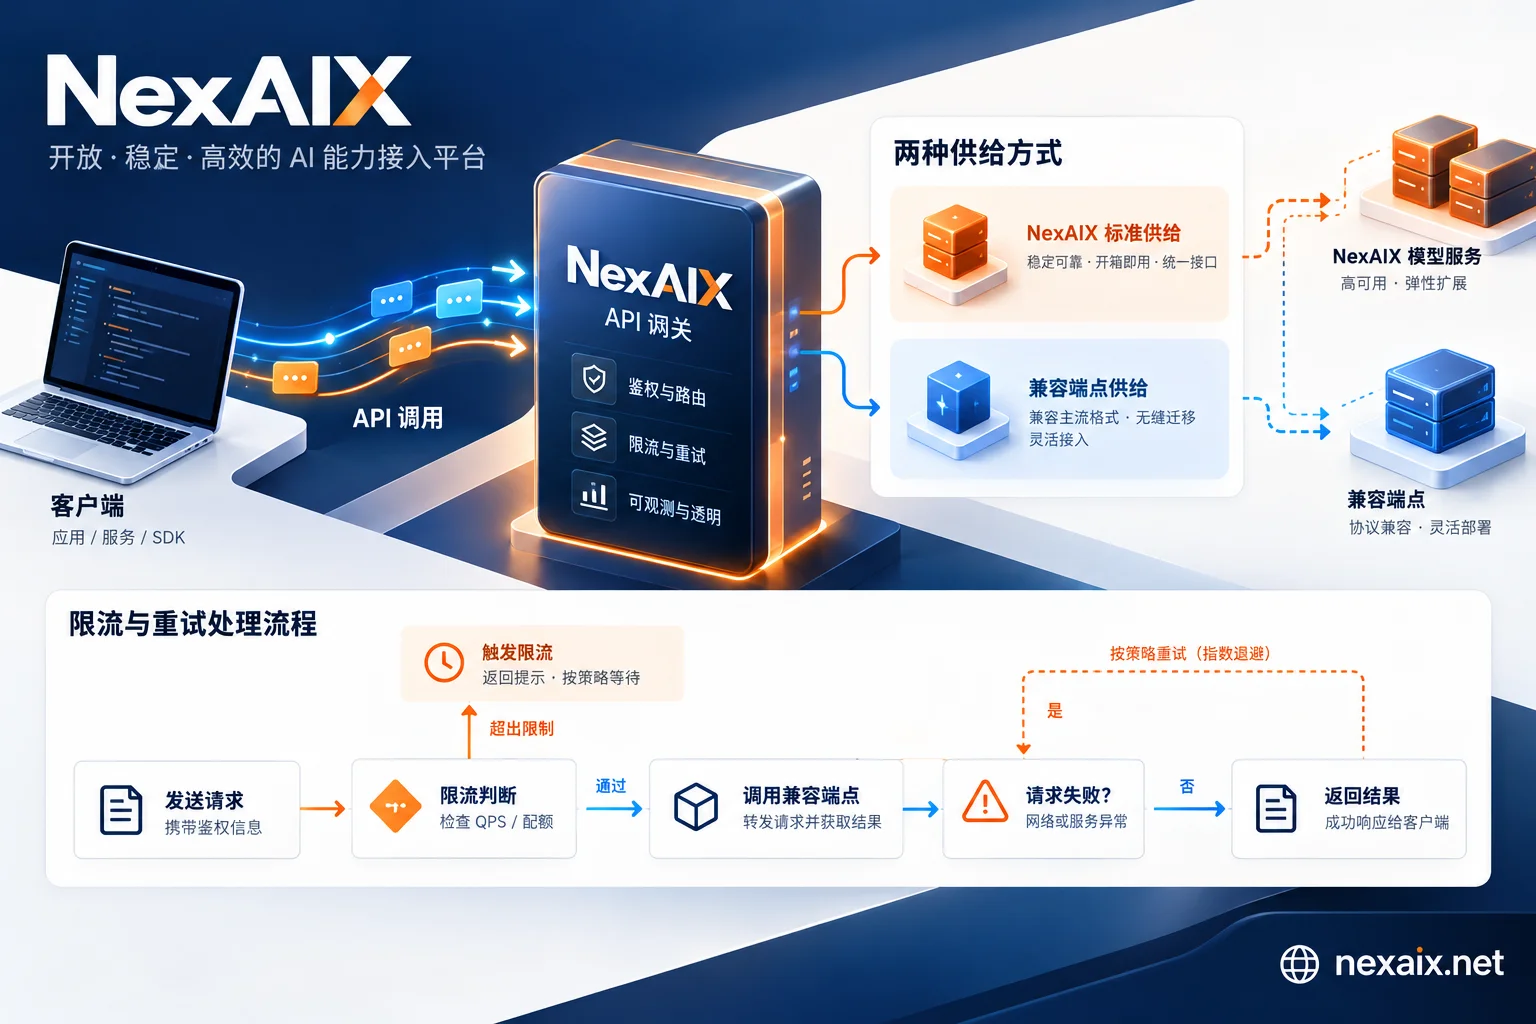
结合近期大模型服务中断、第三方工具 API Key 泄露以及头部模型算力收紧等行业热点,深度解析生产级大模型 API 调用在容灾架构、按 Key 隔离、自有算力与官方授权渠道选型上的实战方案。
针对多模型接入场景,本文基于DeepSeek峰谷计费、Together AI版本弃用及OpenRouter防护栏事实,提供一套可复算的加权单价折算方法与链路分流决策树。
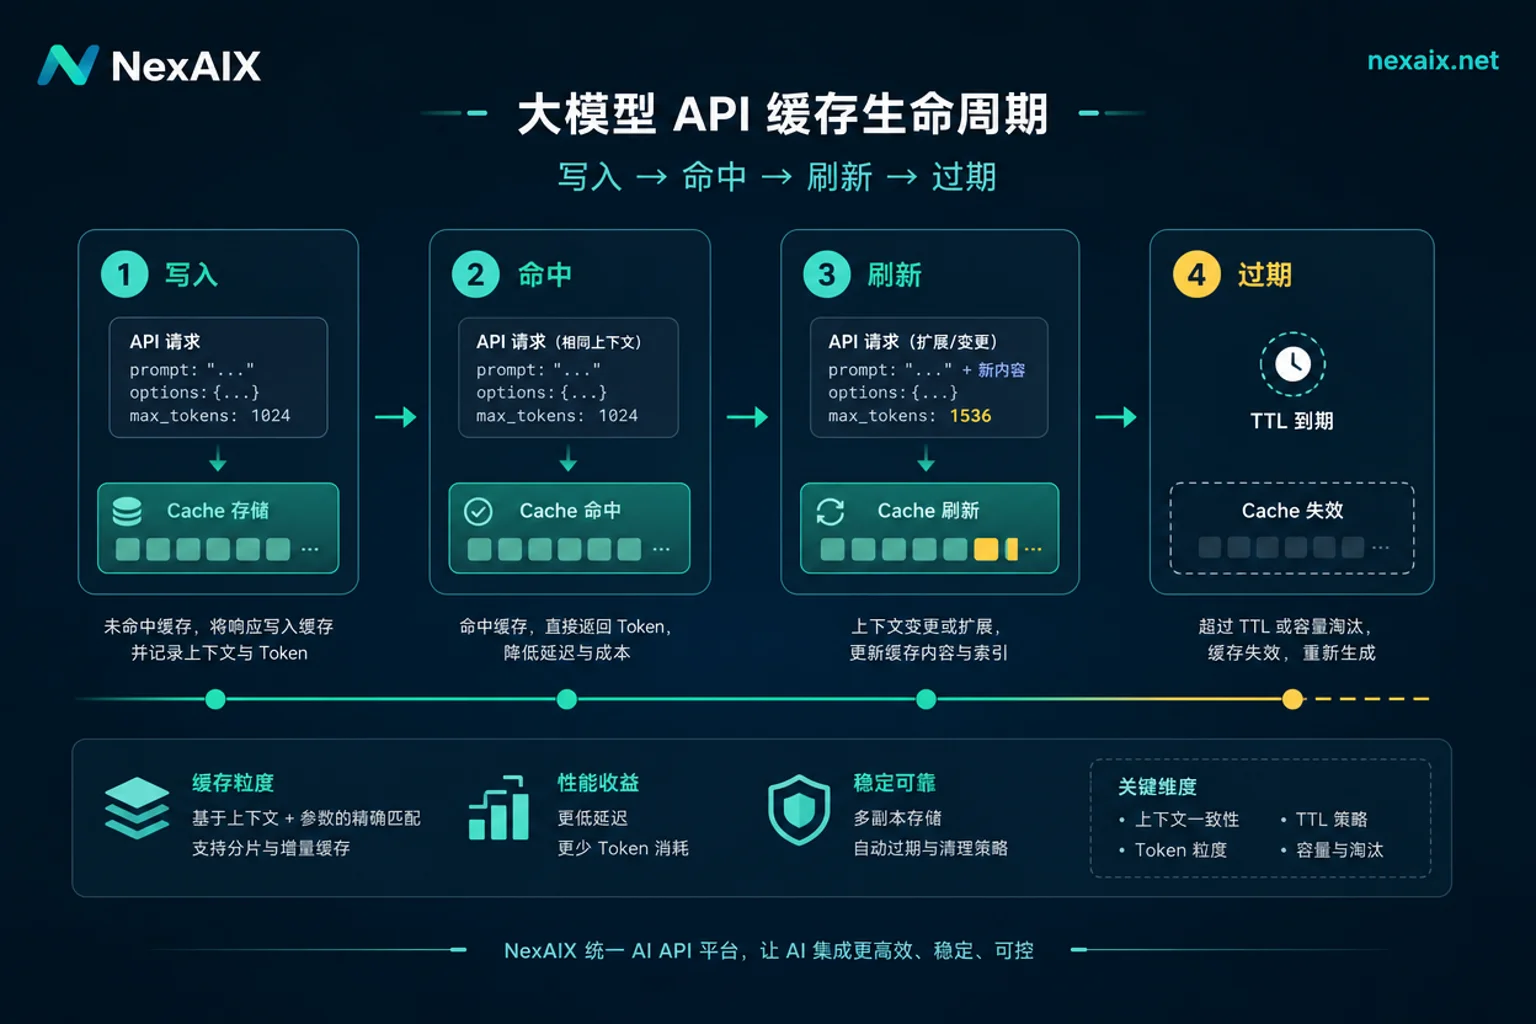
大模型API的prompt缓存通常提供5分钟与1小时两档保留时长,选哪档取决于同一会话相邻请求的间隔中位数,而不是上下文长度。2026年8月起有服务商上线显式Prompt Cache Retention,可指定5分钟或1小时;Anthropic默认5分钟并可扩展至1小时;Google Gemini显式缓存默认1小时。但TTL是最大保留上限而非保证,实际...
0 条留言
 NexAIX-官方博客