Cline 怎么配置自定义模型 API:OpenAI Compatible 的 Base URL、Key 与模型参数

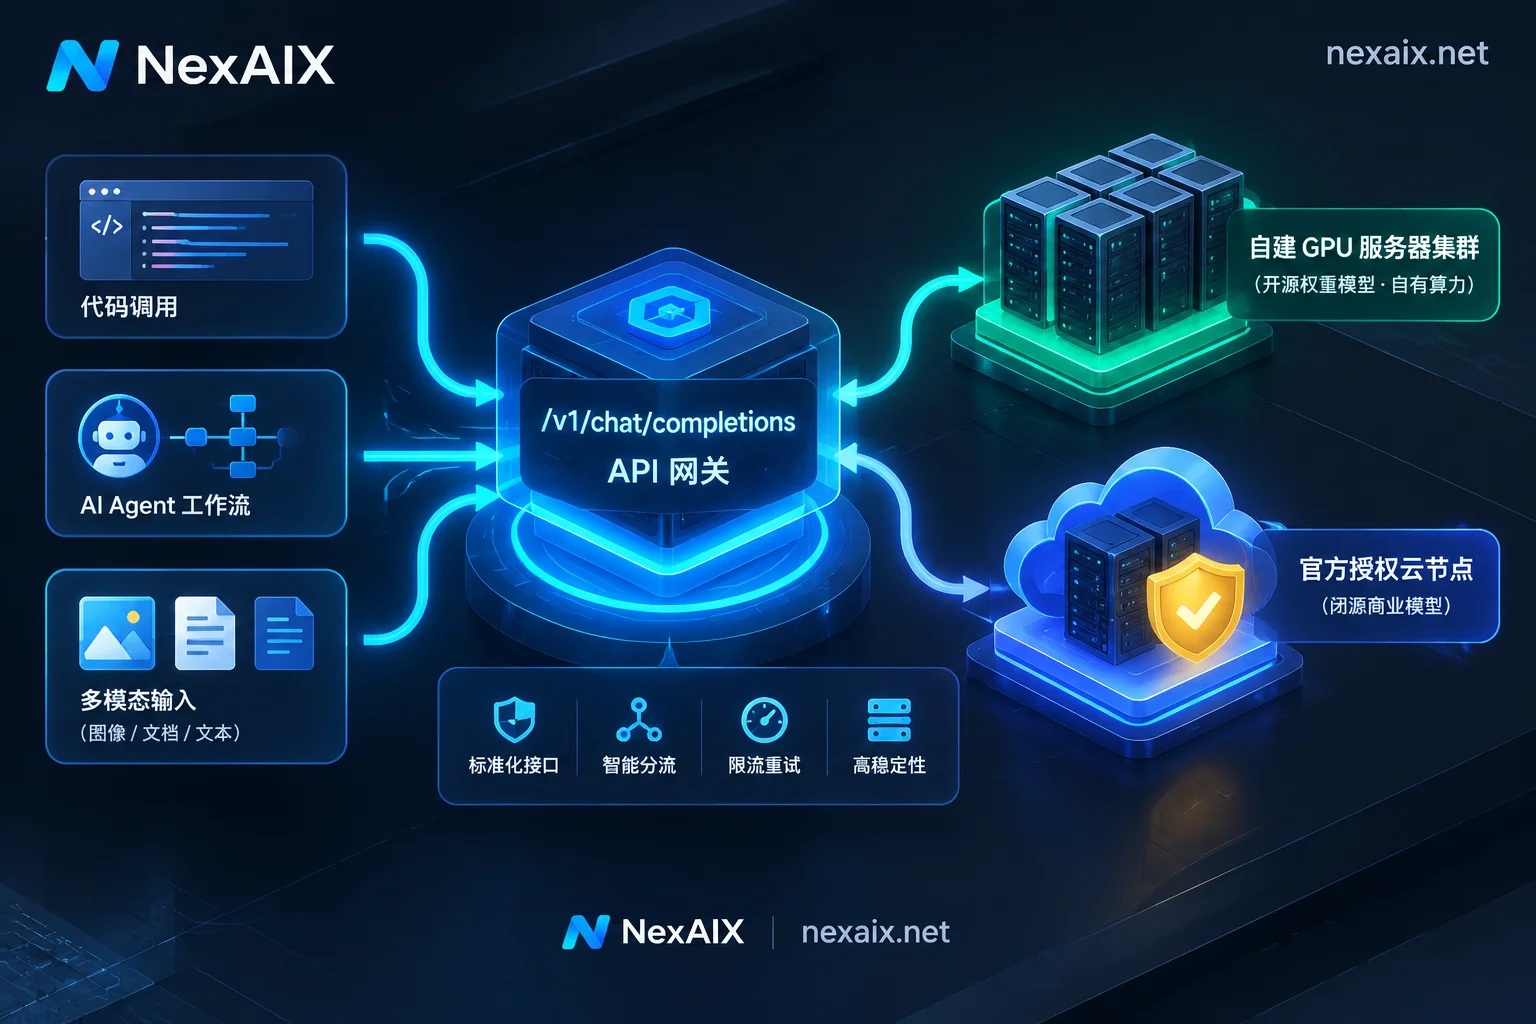
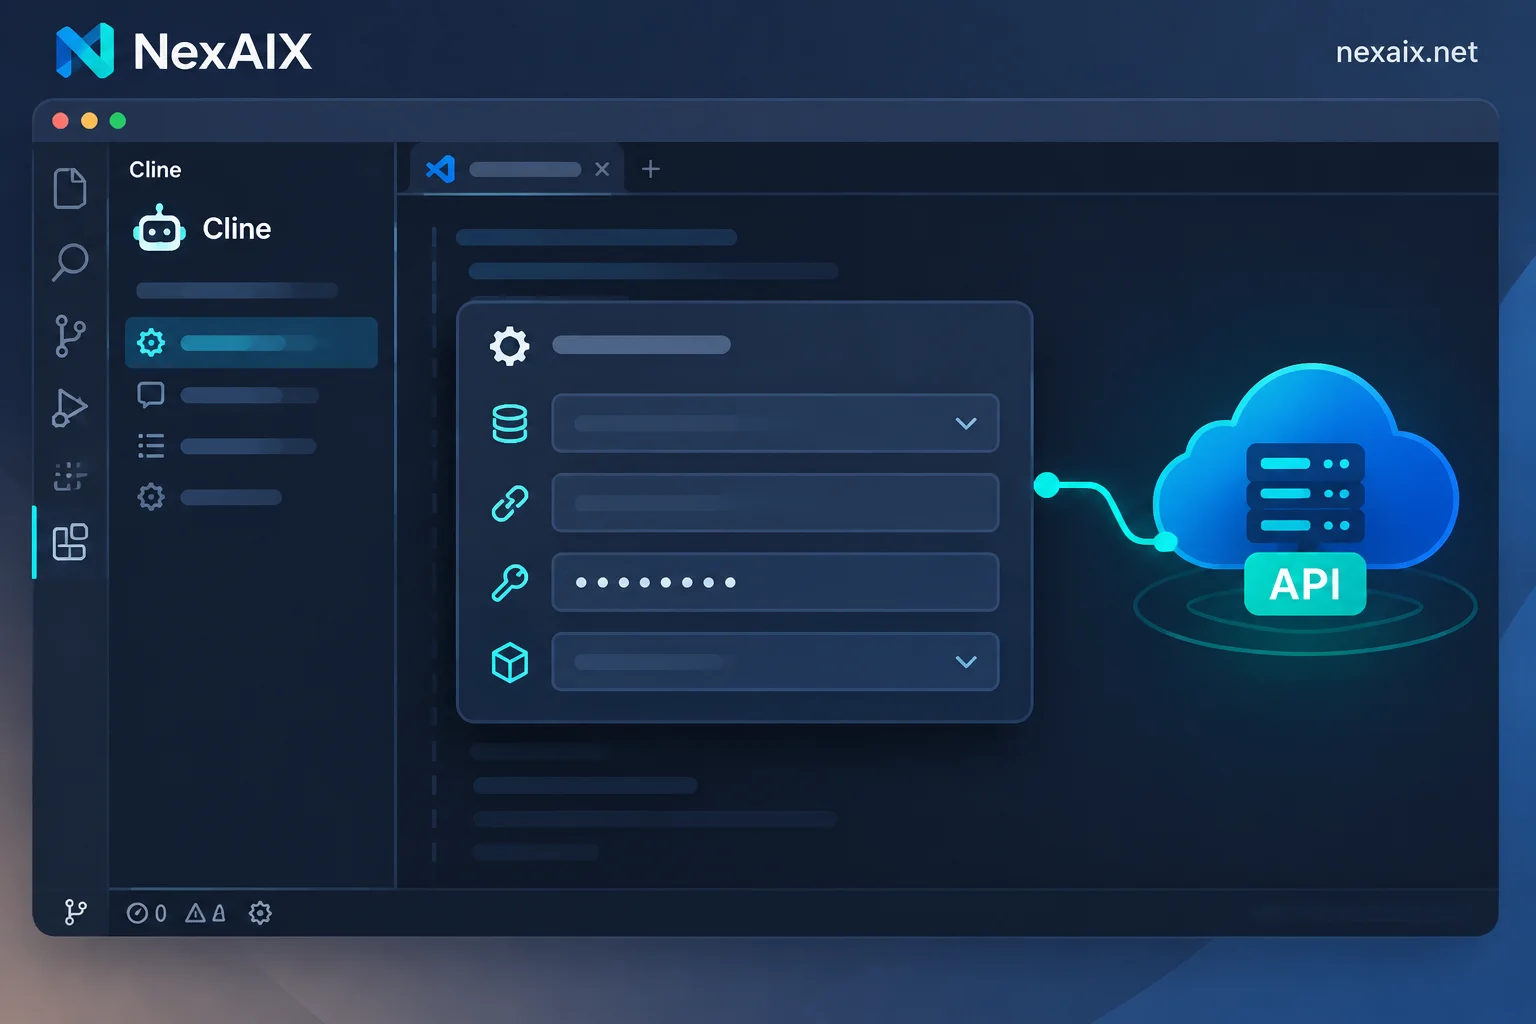
在 Cline 里接入第三方或自建的 OpenAI 兼容端点,需要把 API Provider 选为 OpenAI Compatible,再填写带 /v1 的 Base URL、API Key 和准确的 Model ID,最后按模型规格设置上下文窗口和输出上限。本文按配置顺序讲清每个字段,并整理常见报错的排查方法。
AI API Key 怎么拿、怎么存、怎么分:从本地开发到生产的接入与隔离

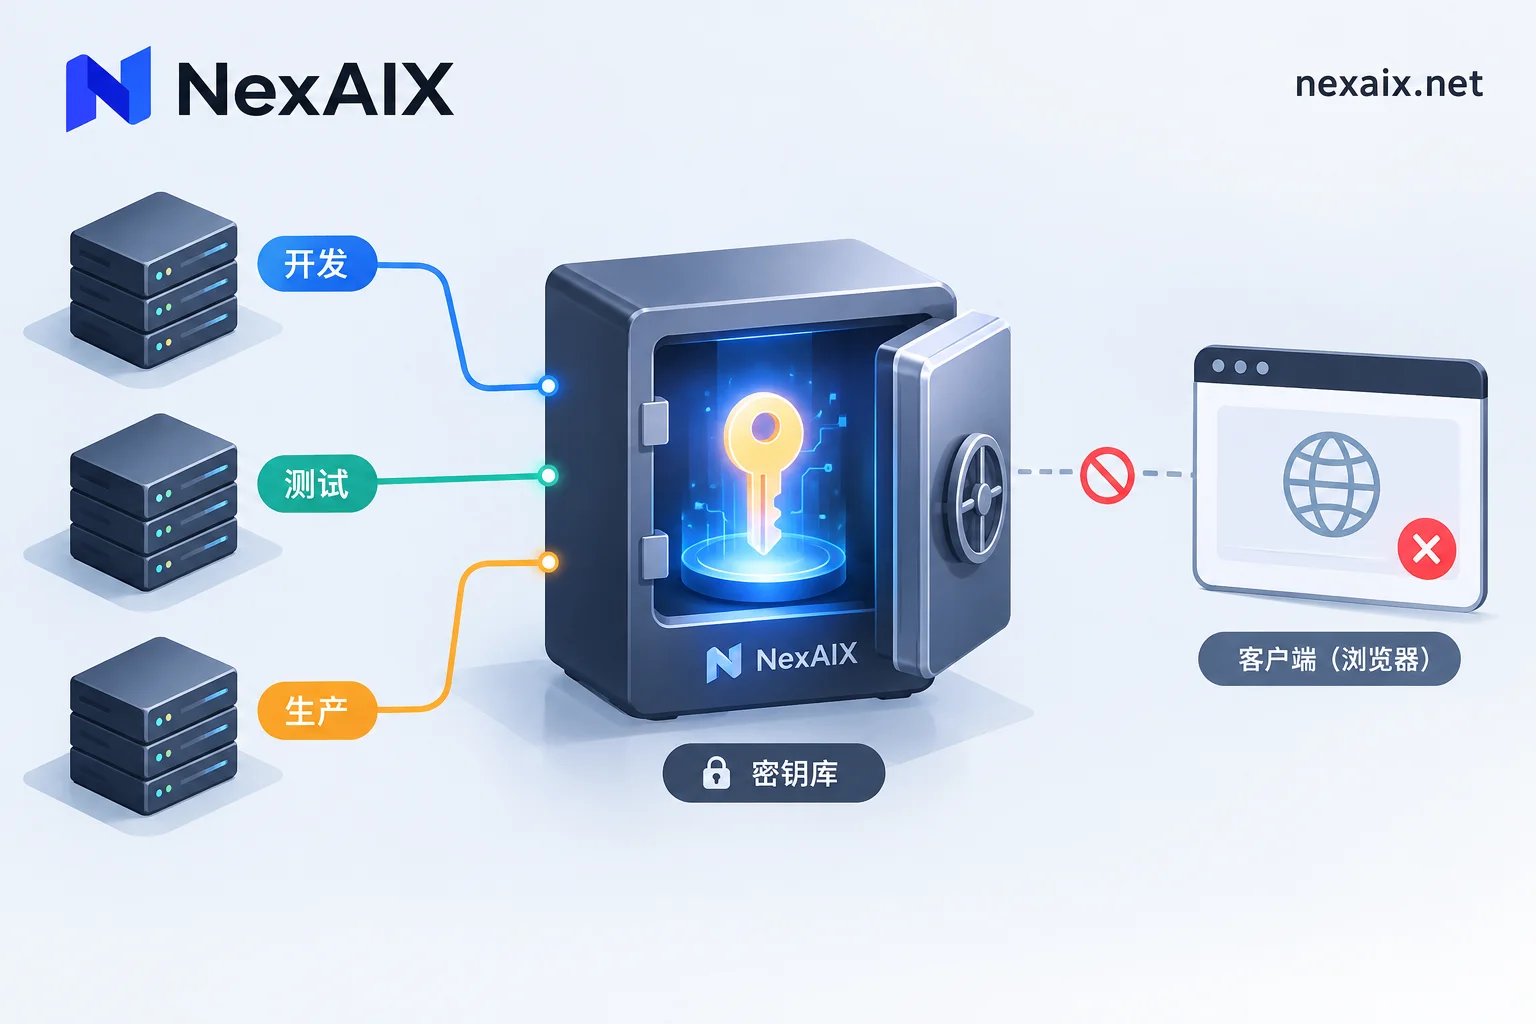
拿到 AI API Key 后,第一步是决定它放在哪里,然后再写调用代码。本文说明如何用环境变量和密钥管理系统注入 Key,如何用 OpenAI 兼容格式只改 base_url 完成接入,怎样按环境和业务拆分 Key,以及 Key 泄露后的处置顺序。

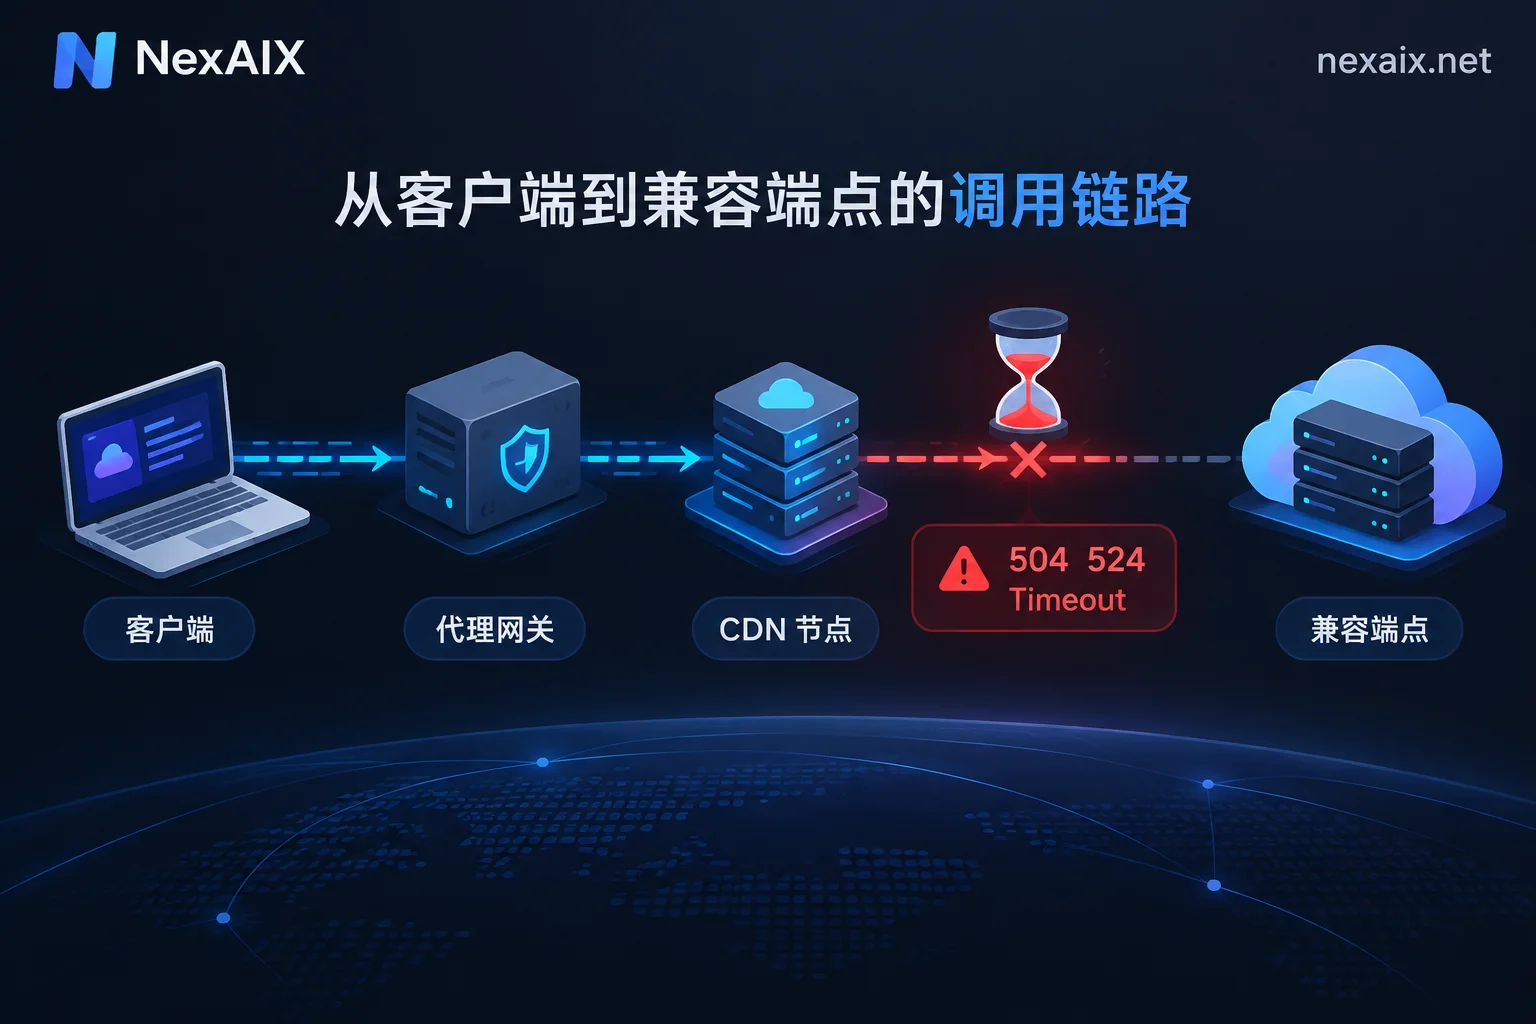
AI API 超时怎么解决:从 504、524 到 APITimeoutError,按链路逐段排查

大模型请求超时,大多是长上下文和长输出的耗时超过了客户端、Nginx 或 Cloudflare 的默认等待时间。本文按“判断断点、开启流式、分段设置超时、调整代理、控制重试和输出长度”的顺序,给出 Python SDK 与 Nginx 的配置示例,并说明各项设置的适用条件。

Kimi K3 API 接入指南:思维链回传、reasoning_effort 档位与防降级验证

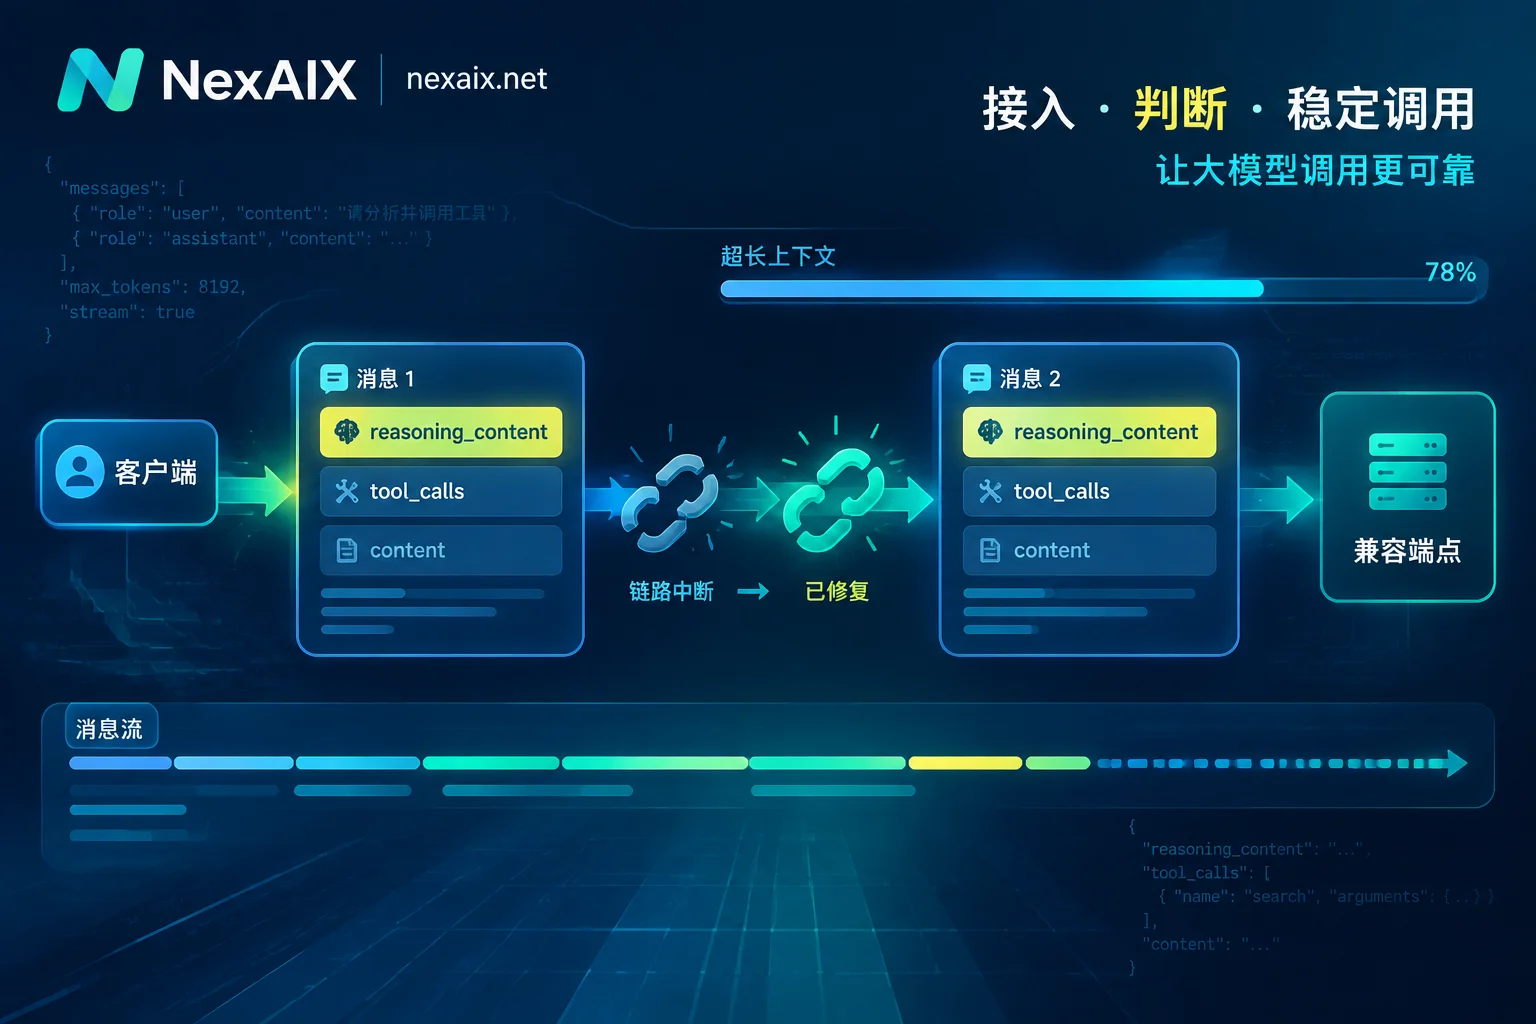
Kimi K3 兼容 OpenAI Chat Completions,接入改两行就能跑,但它的思维链始终开启、必须在多轮和工具调用中原样回传,reasoning_effort 默认还是最高档。本文按实际接入顺序讲清选型判断、最小可用调用、推理档位取舍、工具调用循环的正确消息结构、504 与 429 的处理,以及验证模型没被降配的三条检查。

GPT-5.6 API 怎么接:Sol、Terra、Luna 选型与推理参数配置

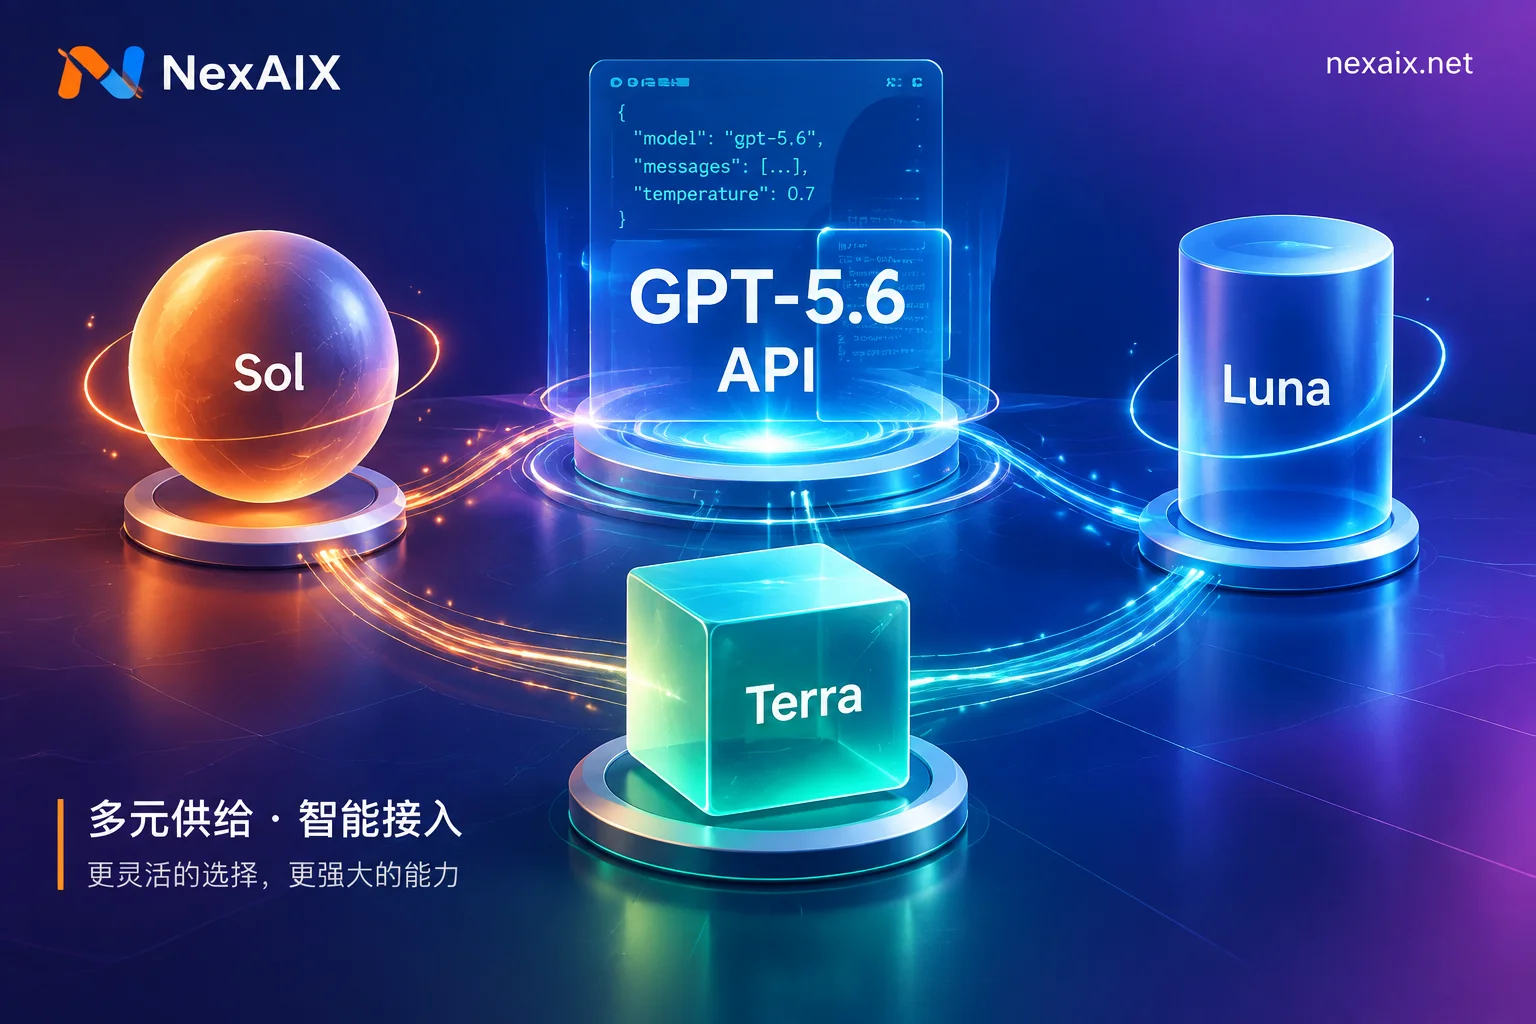
GPT-5.6 分 Sol、Terra、Luna 三个型号,全系支持 105 万 tokens 上下文与最高 12.8 万输出。接入只需改 base_url,通过 reasoning.effort 控制推理深度,用长上下文测试验证渠道是否降配。