 NexAIX-官方博客
进入 2026 年下半年,DeepSeek 的模型迭代节奏明显加快。从上半年发布的 DeepSeek-V4 预览版,到 8 月 V4-Pro 正式版上线,再到 9 月与 10 月接连推出的原生多模态模型 DeepSeek-V4.1-Flash 及其 1017 升级版(DeepSeek-V4.1-Flash-1017),DeepSeek 在代码工程(SWE)、Agent 自动化和多模态理解上的帕累托前沿被再次推高。
然而,伴随模型架构革新而来的,还有 API 端点的频繁更迭与更严格的云服务容量治理。对于在生产环境中维护调用的技术负责人和 Agent 开发团队而言,如何在跟进新模型红利的同时,避开旧端点停用、账号级并发限流以及第三方低价渠道“暗箱降配”的坑,成为了当下最核心的工程命题。
本文将结合 DeepSeek 最新模型演进动态,梳理一套从模型选型、代码平滑迁移、并发限流治理到生产级算力底座选型的完整落地指南。
一、 2026 年 DeepSeek 模型演进与 API 端点调整
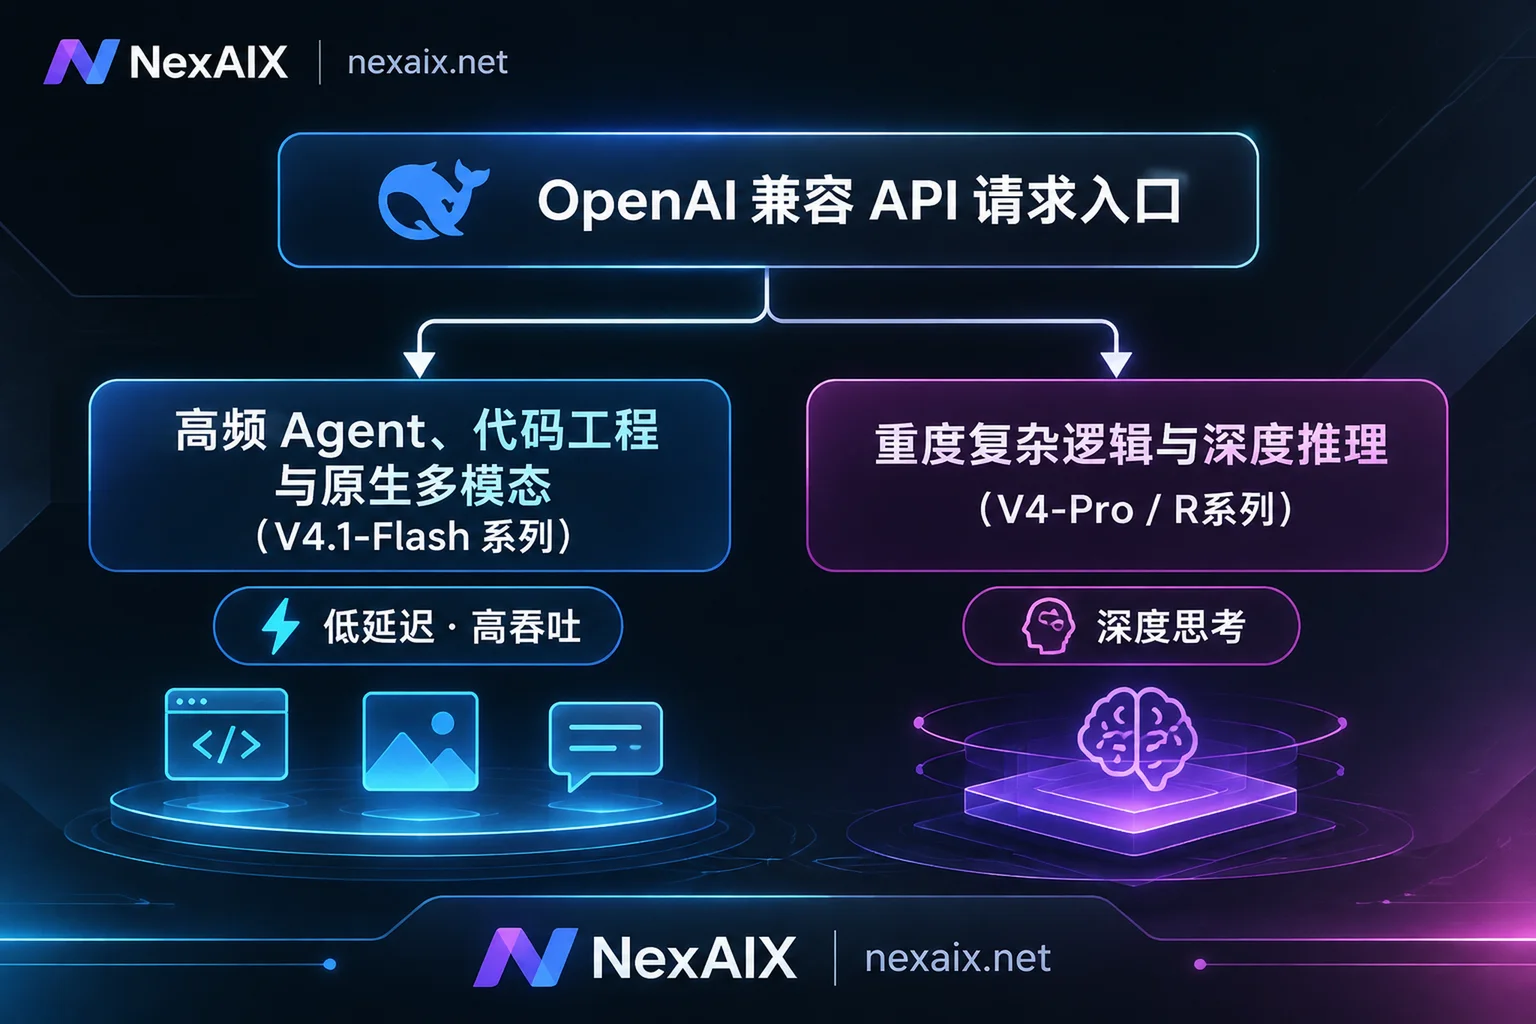
过去两年里,很多开发者的代码中硬编码了 deepseek-chat 或 deepseek-reasoner。但在 2026 年的产品线演进中,DeepSeek 的模型矩阵与命名规范发生了重要调整:
- 旧版模型名停用与自动路由:原有的
deepseek-chat与deepseek-reasoner已于 2026 年 7 月下旬停用。而在 9 月发布采用全新非对称 Causal-Encoder-Decoder 架构(552B 总参数,输入激活 8B、输出激活 16B)的 DeepSeek-V4.1-Flash 后,早期的deepseek-v4-flash与视觉实验版deepseek-v4-flash-vision-exp也已下线并被临时路由至 V4.1-Flash(对应 API 模型名deepseek-flash)。 - V4.1-Flash-1017 与 V4-Pro 的分工:10 月中旬更新的 V4.1-Flash-1017 在 DeepSWE、Terminal-Bench 等代码与 Agent 基准上大幅跃升,同时缩短了任务运行时间与输出长度,具备极高的吞吐与性价比,且原生支持多模态视觉理解;而 DeepSeek-V4-Pro 则继续保留,面向需要重度专家级推理的场景。
在实际业务选型中,如果你此前已阅读过本站关于 Kimi API 接入与迁移指南 或 GLM API 接入与选型指南,就会发现主流国产大模型都在经历“向原生多模态与高吞吐 Agent 模型收敛”的阶段。在接入前,建议先核对当前目标模型的精确的模型 ID、上下文窗口、最大输出与输入模态。
二、 生产环境接 DeepSeek API 的三大高频痛点
当业务从本地 Demo 走向高并发生产环境(尤其是批量数据处理与多步 Agent 编排)时,开发团队普遍会撞上三堵墙:
1. 账号级并发限制与长链路阻塞
随着调用量爆发,DeepSeek 官方进入了标准的云服务限流治理阶段。根据其限流规则,并发限制是以“账号粒度”计算的,而非单个 API Key 粒度。这意味着在同一个官方账号下创建多把 Key 进行轮询,并不能突破总并发上限。
对于普通问答应用,数百并发绰绰有余;但对于 Agent 平台(单次用户指令在后台触发十几次工具调用、代码验证与长思维链推理)或 批量清洗任务,长上下文与长输出请求会长时间占用并发槽位,极易触发 HTTP 429(速率超限)或在晚高峰遭遇全局负载过高导致的 HTTP 503(服务器繁忙)。
2. 模型路由变更带来的行为漂移
如前文所述,当上游将旧模型名自动路由到新模型,或者在部分非正规中转渠道中,服务商为了消化峰值流量而将重度推理请求偷偷切向轻量模型时,业务侧精心调优的 Prompt 和 Function Calling 解析逻辑就可能出现格式报错或输出质量波动。
3. 第三方转售渠道的“量化降配”与日志隐患
DeepSeek 坚持开源权重路线,这也使得市面上出现了大量良莠不齐的 API 聚合与转售站点。部分低价渠道存在三大隐患:
- 精度缩水:将需要高精度的推理任务跑在过度量化的权重上,却按原版计费。
- 隐性截断:暗中压缩最大上下文窗口或
max_tokens,导致长文档分析任务首尾丢失。 - 日志留存不明:请求经过多层转手,企业的核心代码库与业务 Prompt 面临落盘泄露或被拿去微调训练的风险。
关于如何识别并规避这些底层陷阱,可以参考我们此前总结的 开源大模型 API 怎么选:从自建集群、低价转售到生产级混合调用的避坑指南。
三、 为什么工程团队选择通过 NexAIX 调用 DeepSeek 与混合模型?
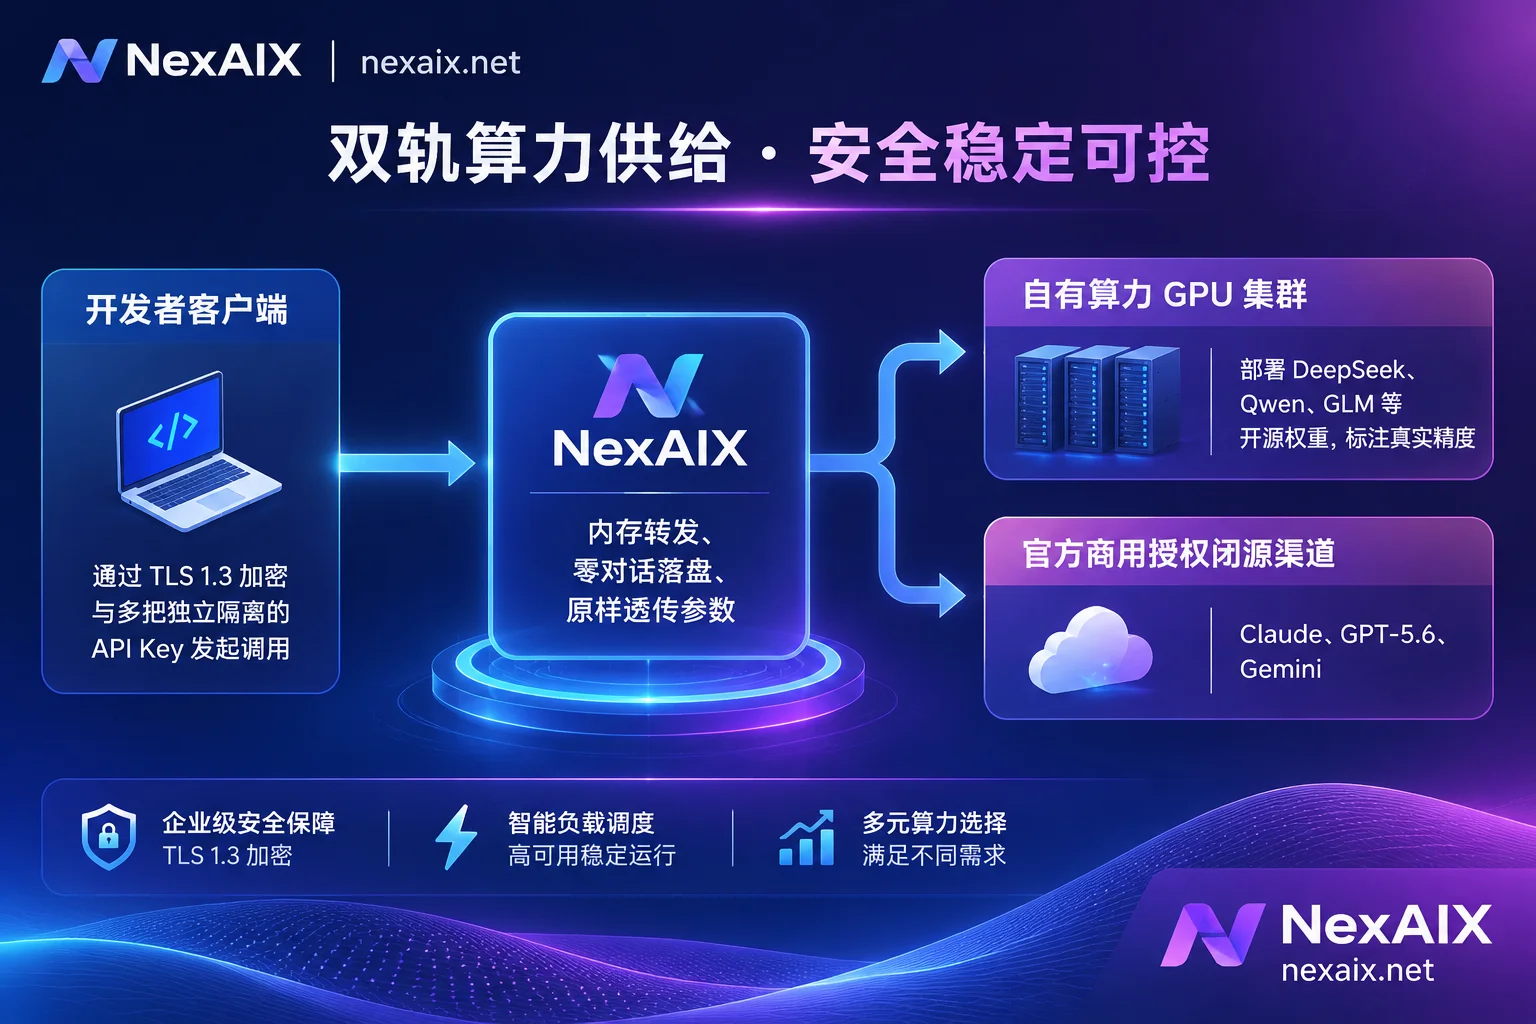
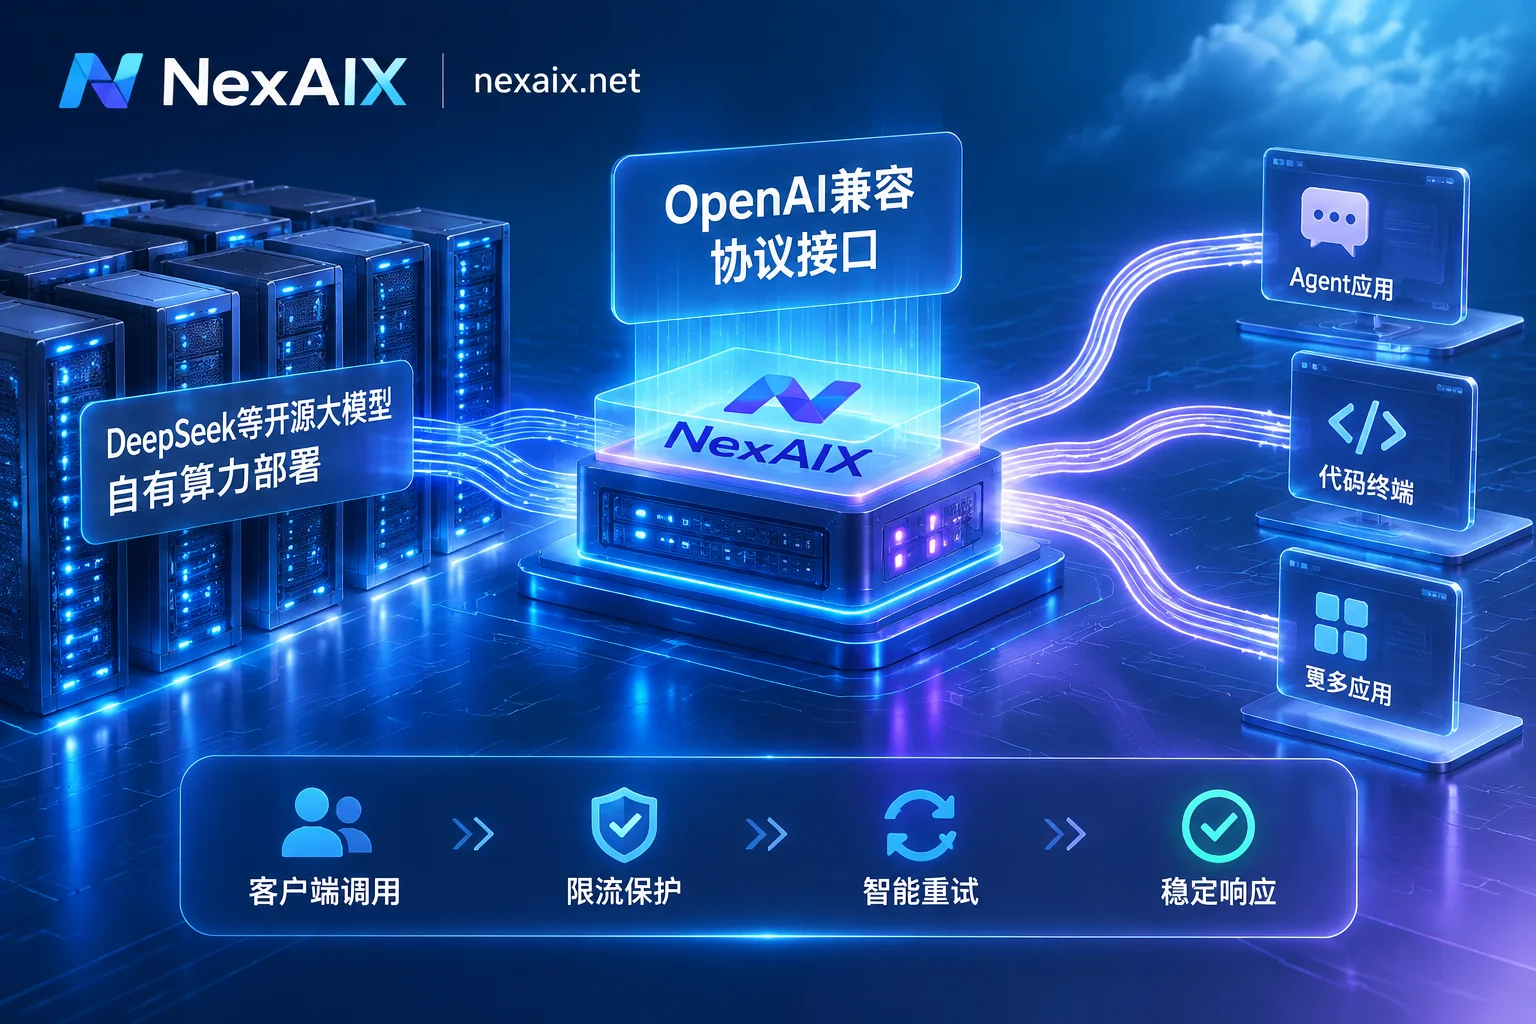
针对上述生产痛点,NexAIX(nexaix.net) 提供了标准、透明的工程化解决方案。我们不做多层转售,也不使用逆向协议或号池,而是通过自有算力部署与官方授权渠道两种明确供给方式,为开发者提供生产级 API 基建。
1. 自有算力集群部署,规格与精度全透明
在 NexAIX 上,包括 DeepSeek、Kimi、GLM、MiniMax、Qwen、gpt-oss 在内的开源权重模型,全部采用自有算力部署:
- 自建与自租机房运维:直接将官方发布的开源权重部署在自有 GPU 集群上,自己负责底层运维,绝不转售第三方额度。
- 参数公开可查:在 NexAIX 模型广场 的每一个独立模型页中,我们都明确标注了供给方式(
自有算力部署)、发布方、开源许可、上下文长度、最大输出、输入模态,以及实际的推理精度(如 BF16、FP8、MXFP4 等,均按实际部署情况逐模型标注)。 - 支持按需定制排期:如果您的团队需要调用当前清单以外的特定开源权重模型(例如特定历史版本的 DeepSeek 权重),可以直接将型号与预计用量发送至
[email protected],我们会评估算力后回复上线排期。
(注:目前在线的具体 DeepSeek 子型号、推理精度及价格,请以 https://nexaix.net/models/ 实时页面为准;访问单个模型详情页时,请注意 URL slug 规则是将模型 ID 中的点替换为横线。)
2. 严格承诺“四不降配”,支持开发者自查
为了保障生产环境的确定性,NexAIX 坚持严格的不降配原则:
- 返回体中的
model字段就是实际执行推理的模型,不换小模型、不降精度、不截断上下文和最大输出、不注入隐藏系统提示词。 - 您传入的
temperature、top_p、max_tokens等超参数均原样透传至推理节点。 - 我们鼓励技术团队通过固定 Prompt 与随机种子复测、核对返回
model字段、接近上限长度压测、让模型复述收到的全部消息这四种方法进行独立核验(详见 怎么确认 API 返回的是不是原版模型:四类可复核的检查方法)。
3. 内存级转发与零对话日志
代码补全与企业内部 Agent 往往涉及高敏数据。在 零日志与隐私保护 方面,NexAIX 在本站侧做到:
- 不写盘、不训练:所有的
prompt和completion仅在内存中完成转发,请求结束即刻释放,绝不落盘;数据不用于模型训练,也绝不转交给任何做训练的第三方。 - 全程加密与最小化元数据:从客户端到推理节点全程采用 TLS 1.3 加密;系统仅保留用于计费与排障的请求 ID、模型名、token 计数、时间戳和状态码。
4. 按 Key 独立隔离,清晰的 429 边界控制
不同于单一账号共享并发池的受限模式,NexAIX 支持按 Key 隔离:
- 每把 API Key 拥有独立配额(RPM、TPM 与并发上限)、独立权限与独立用量账单。一旦某把测试 Key 泄露,可单独吊销而不影响生产主链路;财务对账时,账单按模型清晰分项。
- 当并发达到上限或集群满载时,NexAIX 会返回标准的 HTTP
429状态码并附带Retry-After响应头,绝不无限期挂起连接,也绝不会自作主张将您的请求偷偷降级路由给更便宜的模型(了解详情可查阅 高吞吐与限流机制)。 - 如果您的生产业务需要更高的 RPM/TPM 或并发配额,可随时提交申请,我们将根据集群实际容量快速答复。
四、 接入实战:三步迁移与混合模型调度示例
NexAIX 完全按 OpenAI Chat Completions 规范实现,支持流式输出(Streaming)、函数/工具调用(Function Calling)及多轮对话。对于支持多模态的模型,图像可按 OpenAI 标准格式传 image_url 或 base64(视频可按抽帧后的图像序列传入)。
如果您现有的项目已经在使用 OpenAI SDK,或者正在使用 LangChain、LlamaIndex、Vercel AI SDK、Dify、Cherry Studio、NextChat、Cline、OneAPI 等主流工具,只需修改 base_url 和 api_key 即可无缝切入(详见 一键替换接入说明)。
1. Python SDK 接入与标准 429 退避处理
在生产环境中,由于 NexAIX 不会替用户做暗箱的“自动故障转移或偷换模型”,我们建议在调用端结合 Retry-After 实现显式的退避或跨模型切换策略。以下是一个标准的 Python 调用示例:
import os
import time
from openai import OpenAI, RateLimitError

# 1. 仅需将 base_url 指向 NexAIX 端点,换上控制台获取的 API Key
client = OpenAI(
    api_key=os.getenv("NEXAIX_API_KEY"),
    base_url="https://api.nexaix.net/v1"
)

def call_model_with_retry(messages, model_id, max_retries=3):
    for attempt in range(max_retries):
        try:
            response = client.chat.completions.create(
                model=model_id,  # 请填写 https://nexaix.net/models/ 页面标注的实际模型 ID
                messages=messages,
                temperature=0.6,
                max_tokens=4096,
                stream=False
            )
            # 可核对 response.model 确认实际执行模型,记录 response.id 便于排障
            print(f"[Success] Request ID: {response.id} | Executed Model: {response.model}")
            return response.choices[0].message.content

        except RateLimitError as e:
            # 遇到满载或触发当前 Key 的配额上限时,读取标准 Retry-After 头进行退避
            retry_after = int(e.response.headers.get("Retry-After", 2 ** attempt))
            print(f"[429 Rate Limited] Waiting {retry_after}s before retry...")
            time.sleep(retry_after)

raise RuntimeError("Max retries exceeded.")排障小贴士:每次调用均会返回唯一的请求 ID(Request ID)。在生产环境中如果遇到异常,只需带着该请求 ID 联系支持团队,即可在不暴露任何对话内容的前提下快速定位链路状态。
2. 一把 Key 构建“DeepSeek + 闭源旗舰”的 Agent 混合架构
在复杂的软件工程 Agent(如基于 Cline 或自研工作流)中,押注单一模型往往不是最优解。通过 NexAIX,您可以用同一把 API Key、同一个端点,在自有算力的开源模型与官方授权渠道的闭源旗舰模型(如 Claude、GPT-5.6、Grok、Gemini 系列)之间自由切换——切模型只需改一行 model 字段:
- 高频子任务与批量预处理:路由给自有算力部署的 DeepSeek 系列模型,利用其优异的代码生成能力与高性价比处理海量日志解析、单测生成与初步检索。
- 核心架构重构与跨模块调试:当遇到极高复杂度的逻辑闭环或需要零数据保留的闭源能力时(例如本站官方授权渠道接入的 Claude Opus 5 支持上游零数据保留),只需将请求中的
model参数切换为对应的闭源模型 ID。
关于如何通过多模型分层与多 Key 账单来精细化控制预算,欢迎延伸阅读 AI API 成本优化实战指南:从 Agent 多模型分层、隐性损耗排查到多 Key 账单治理。
五、 总结与快速开始
DeepSeek 架构的持续进化为开发者带来了更强的推理与多模态能力,但生产环境的稳定性终究取决于底层算力供给的透明度与工程治理的规范性。
- 个人开发者与敏捷团队:现在前往 NexAIX 控制台(api.nexaix.net),仅需邮箱注册即可获赠测试额度,无需繁琐的企业资质审核;登录后即可创建独立 API Key、查看模型列表并随时导出用量明细。
- 企业与合规场景:NexAIX 拥有完整实体主体,支持签合同、开发票,并可签署正式的服务协议(SLA)与数据处理协议(DPA)。如果您的业务对吞吐与隔离有极高要求,我们同样支持洽谈独立资源池与私有化部署方案,欢迎直接发送邮件至 [email protected] 与我们的工程团队取得联系。


评论(0)